
游戏客户端架构 / 系统课时
先用帧时间找热点
先用帧时间找热点
当 ECS 场景从几十个实体增长到上万个实体,帧率下降未必说明某个 System 算得太慢:主线程可能在等工作线程,也可能卡在渲染或同步点。本课建立可复现的帧时间采样方法,按证据缩小热点范围,再决定优化对象。
学习目标
- 区分整帧耗时、System 耗时、同步等待及 GPU 瓶颈。
- 在异常帧中追踪主线程与任务线程的时间关系。
- 使用轻量计时示例验证采样方式并制定优化验收条件。
先把帧预算换成毫秒
60 FPS 的平均帧间隔约为 16.67 ms,30 FPS 约为 33.33 ms;但单看 FPS 平均值会掩盖偶发卡顿。先固定设备、分辨率、NPC 数量与镜头路径,再记录一段实际运行样本的帧耗时分布,至少关注中位数、P95 与最大值。
区分几种经常被混称为“CPU 花费”的量:
| 指标 | 用来回答什么 | 不能直接推断什么 |
|---|---|---|
| 帧墙钟耗时 | 从本帧开始到测量终点经历了多久 | 全部时间都在占用 CPU 计算 |
| System 自身耗时 | 当前 System 内部实际执行占多久 | 子任务并行后,总耗时可直接相加 |
| 等待/同步耗时 | 主线程在哪个栅栏等任务或资源 | 被等待的 System 一定效率低 |
| GPU 耗时 | 渲染设备是否成为显示瓶颈 | ECS 模拟一定需要修改 |
测量边界必须写明。引擎统计中的“CPU frame”、脚本执行时间、Present 等待与屏幕显示间隔不一定相同;限帧、垂直同步和 GPU 等待都可能让时间线出现空档。比较优化前后必须使用相同测量口径。
在真实场景中取一段证据
- 使用接近目标平台的构建和相同画质运行,先预热资源与着色器,再进行采样。记录场景版本、实体数、固定步频和是否开启 VSync。
- 连续采样数百帧;找出 P95 附近及最慢的帧,并记录当时是否发生批量生成、结构变更、物理更新或资源加载。
- 展开相同时间区间内的主线程、工作线程和 System 标记;检查是否存在等待栅栏、工作线程空闲或负载不均。最后再对照 GPU 时间线。
在 Unity 可从 CPU Usage Profiler 的 Timeline 看多线程与等待,在 Unreal 可用 Unreal Insights 的 Timing Insights,在 Godot 可用 Debugger 的 Profiler 与 Visual Profiler 交叉检查。Godot 的脚本/物理分析与渲染分析关注范围不同,不能把一个面板的数值当成全帧总成本。
从异常帧判断是计算还是等待
假设一帧用了 26 ms,MovementSystem 自身仅占 4 ms,而主线程在提交后的同步栅栏等待 11 ms;此时先改 MovementSystem 的循环语法很可能收效有限。应该查看工作线程是否仍在处理其他任务、任务粒度是否过碎,以及消费者是否过早要求所有任务完成。
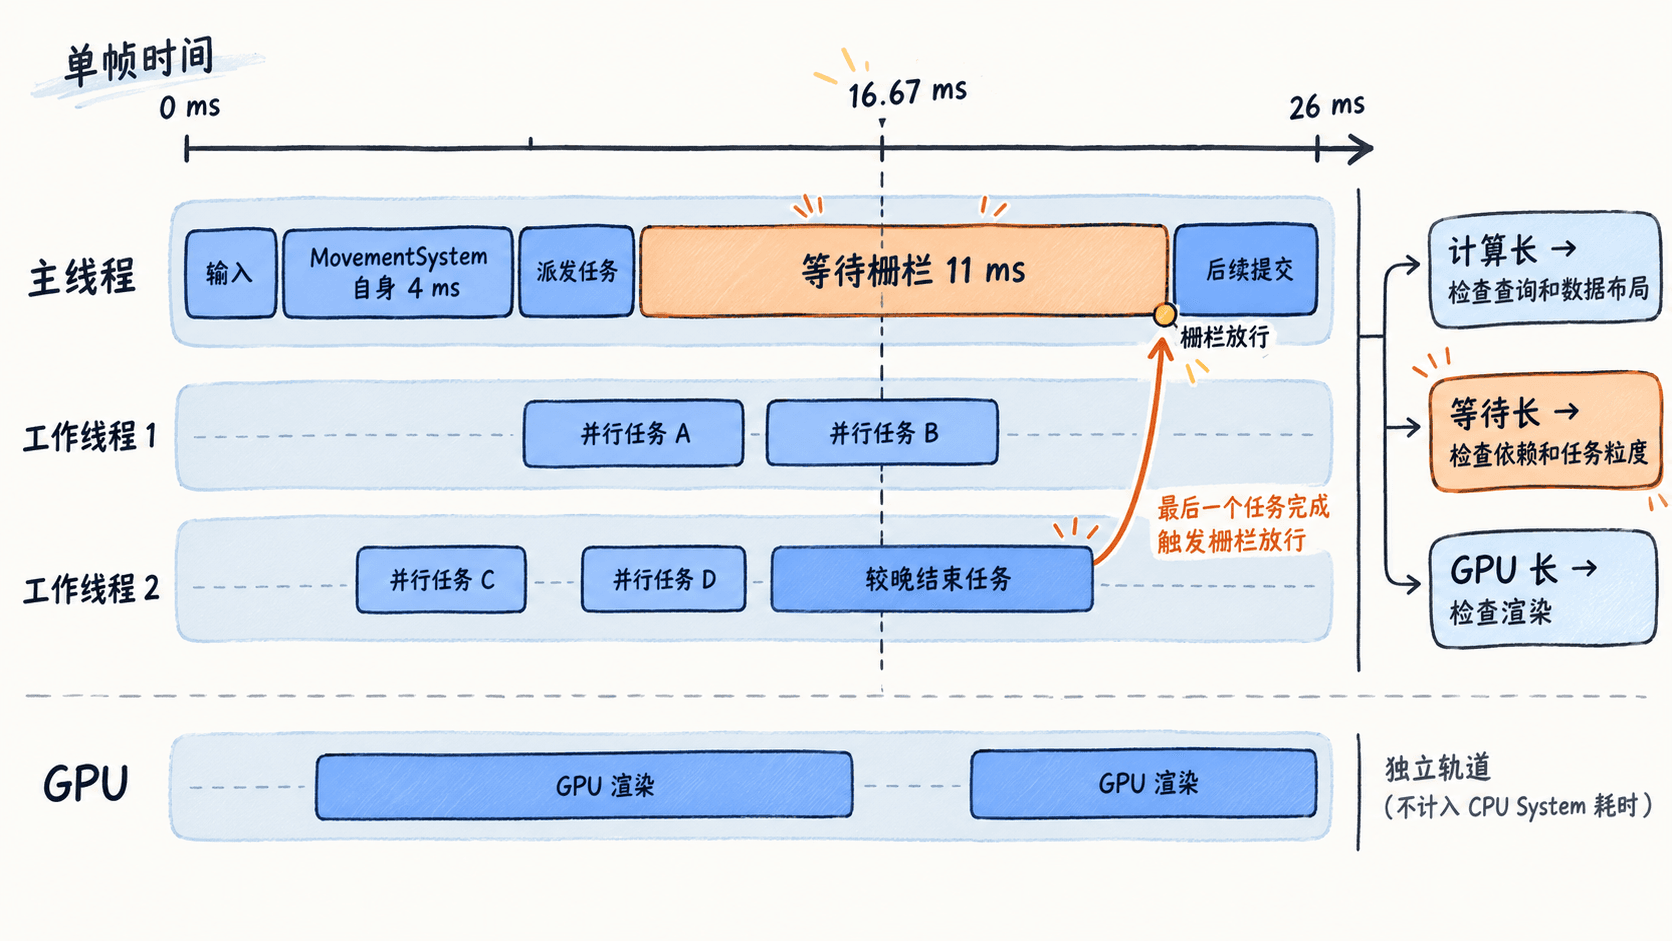
重点读时间上的重叠,而非把所有 System 的计时数字相加:并行的两个 8 ms 任务并不等于让一帧增加 16 ms。也要区分 Inclusive(含子调用)与 Self(自身)时间,否则父 System 与子函数会被重复计算。
用最小计时脚本练习归因
下面是可直接运行的 Python 3 示例,只演示墙钟计时的归类,不代表任何引擎的官方 ECS Profiler。用 sleep() 模拟同步等待,可以看到等待延长了帧时间,但不是持续执行的 CPU 运算。
from statistics import median
from time import perf_counter, sleep

def measure(action):
    started = perf_counter()
    action()
    return (perf_counter() - started) * 1000

def move_system():
    # 模拟批量组件运算;项目中换成真实 System 范围。
    sum(i * i for i in range(10000))

def barrier_wait():
    # 模拟等待其他任务完成,不等于 CPU 忙算。
    sleep(0.005)

def sample_frame():
    started = perf_counter()
    move_ms = measure(move_system)
    wait_ms = measure(barrier_wait)
    frame_ms = (perf_counter() - started) * 1000
    return frame_ms, move_ms, wait_ms

samples = sorted((sample_frame() for _ in range(120)), key=lambda x: x[0])
p95_index = int((len(samples) - 1) * 0.95)
slowest = samples[-1]
print(f"frame_median_ms={median(x[0] for x in samples):.2f}")
print(f"frame_p95_ms={samples[p95_index][0]:.2f}")
print(f"worst_move_ms={slowest[1]:.2f}")
print(f"worst_wait_ms={slowest[2]:.2f}")
预期输出(耗时随设备和调度变化):
frame_median_ms=<TIME>
frame_p95_ms=<TIME>
worst_move_ms=<TIME>
worst_wait_ms=<TIME>
<TIME> 表示实际运行得到的毫秒数,格式为两位小数;在多数环境中等待段接近或大于 5 ms,但不保证固定值。这个脚本的串行范围可相加,真实 ECS 中跨线程的范围不能如此相加,更不应把 sleep() 当作真实引擎等待的诊断方法。
把分析结果变成下一次验证
若 System 的 Self Time 高且 CPU 核心持续忙,先检查查询过滤、数据布局、重复遍历与缓存命中;若长时间落在任务完成或栅栏等待,检查读写依赖、同步点位置、任务粒度和主线程过早消费;若 CPU 侧很快但 GPU 侧超预算,先处理渲染与表现代理的数量,而不是盲目并行模拟。
一次只改一个因素,用相同实体数量和操作路径重新采集 P95、最慢帧与关键阶段耗时;还要验证状态结果、实体生命周期和事件顺序未变。只有热点消失且用户可见的帧时间改善,才算优化有效。