
游戏客户端架构 / 系统课时
并行以后为什么反而更慢
并行以后为什么反而更慢
把一个 ECS System 拆给多个工作线程后,CPU 占用率可能升高,单帧却更慢。本课用任务时间线和可运行的对照实验,识别调度、同步、负载不均与缓存竞争,再根据测量结果决定是否保留并行。
学习目标
- 解释为什么线程更多不等于帧时间更短。
- 区分任务过细、屏障过多、负载倾斜和缓存竞争的证据。
- 用正确性校验与性能测量选择串行、逐元素并行或分块处理。
先看关键路径而不是线程数量
ECS 一帧必须等所有必要的前置任务完成。即使四个 Worker 同时开始,只要其中一个处理得慢,依赖它的后续 System 仍要等待。实际耗时还包含任务分派、线程唤醒、同步等待和内存访问停顿;任务本身越短,这些固定开销所占比例越大。
例如,把几百微秒的工作切成数千个调度单元,可能把节省的计算时间全部花在分派与等待上。相反,某个 Chunk 特别重,也会让其他 Worker 提前空闲,形成长尾。
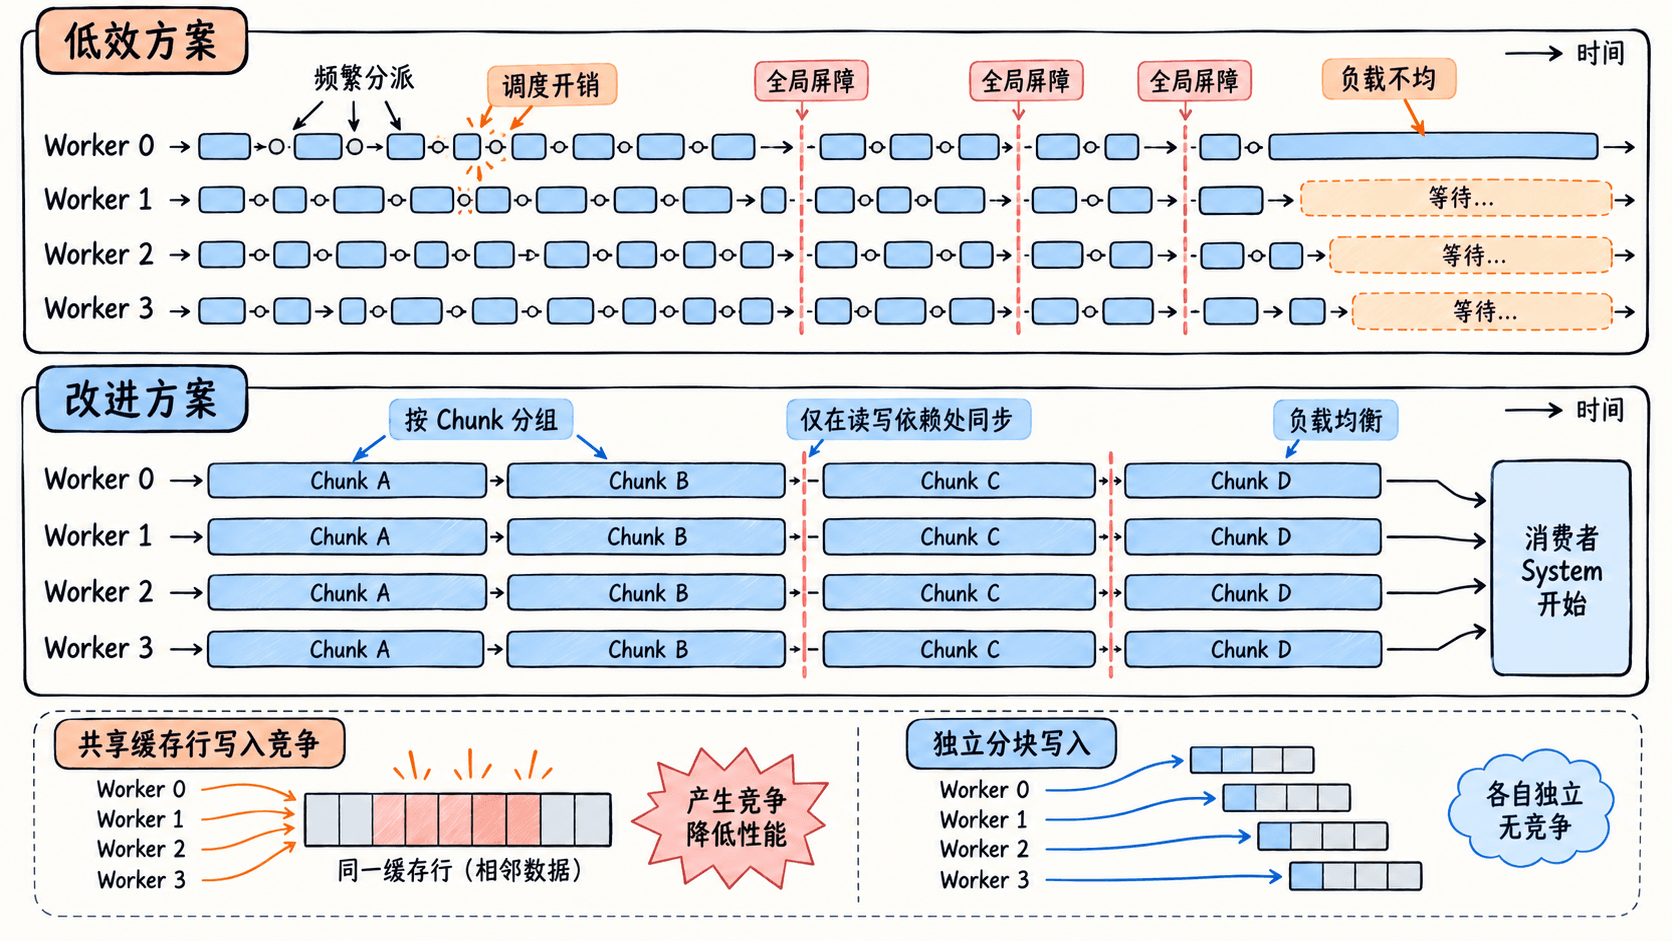
四类症状怎样对应根因
| 观察到的现象 | 优先怀疑 | 下一步验证 |
|---|---|---|
| 任务数量激增,小工作占比高 | 粒度过细 | 增大每个任务的实体批量,比较调度时间 |
| Worker 经常在阶段末空等 | 屏障过多或存在依赖链 | 画出读写依赖,只保留必要同步点 |
| 少数 Worker 持续运行,其余提前空闲 | Chunk 工作量不均 | 记录每块耗时,按工作量重新分配 |
| CPU 很忙,增加线程却不增速 | 缓存行争用或内存带宽饱和 | 检查相邻写入所有权、访存模式及硬件计数器 |
伪共享特指不同线程写入不同变量,却因变量落在同一缓存行而反复触发缓存一致性流量;它不等于普通的数据竞争。多个线程写同一组件字段则是正确性问题,必须先消除冲突,再谈速度。
用可运行实验比较任务粒度
在 .NET 8 控制台项目中将以下代码保存为 Program.cs,使用 dotnet run -c Release 运行。三种方式都计算相同结果,先验证一致性,再比较耗时。Parallel.For 本身会自动分区,逐元素写法并不意味着每个实体都创建一个线程。
using System;
using System.Diagnostics;
using System.Linq;
using System.Threading.Tasks;

const int count = 400_000;
int[] source = Enumerable.Range(0, count).ToArray();
int[] serial = new int[count];
int[] fine = new int[count];
int[] coarse = new int[count];

// 三种方法都只写独立的数组位置,避免数据竞争
void RunSerial()
{
    for (int i = 0; i < count; i++) serial[i] = source[i] * 3 + 1;
}
void RunFine()
{
    Parallel.For(0, count, i => fine[i] = source[i] * 3 + 1);
}
void RunCoarse()
{
    const int chunkSize = 8_192;
    int chunks = (count + chunkSize - 1) / chunkSize;
    Parallel.For(0, chunks, chunk =>
    {
        int begin = chunk * chunkSize;
        int end = Math.Min(begin + chunkSize, count);
        for (int i = begin; i < end; i++) coarse[i] = source[i] * 3 + 1;
    });
}
double Bench(Action action)
{
    action(); // 预热,降低首次 JIT 编译对结果的干扰
    var watch = Stopwatch.StartNew();
    for (int run = 0; run < 20; run++) action();
    watch.Stop();
    return watch.Elapsed.TotalMilliseconds / 20;
}
double ts = Bench(RunSerial);
double tf = Bench(RunFine);
double tc = Bench(RunCoarse);
Console.WriteLine($"结果一致: {serial.SequenceEqual(fine) && serial.SequenceEqual(coarse)}");
Console.WriteLine($"串行: {ts:F3} ms/轮");
Console.WriteLine($"逐元素并行: {tf:F3} ms/轮");
Console.WriteLine($"分块并行: {tc:F3} ms/轮");
预期输出(耗时为实际环境测量值):
结果一致: True
串行: <TIME> ms/轮
逐元素并行: <TIME> ms/轮
分块并行: <TIME> ms/轮
<TIME> 会随 CPU、线程池、系统负载和运行次数变化。这里每个元素的计算很轻,并行可能比串行慢;显式分块是否更快也须以实测为准,不能将一次运行视为结论。
让真实 ECS 的证据形成闭环
先在同一场景分别记录 System 总耗时、Worker 实际工作时间、排队时间和屏障等待时间,再查看最慢 Chunk 与其他 Chunk 的差距。一次只调整一项:Chunk 大小、并行度、屏障位置或数据布局;同时固定实体数量与更新频率,重复多轮测量。
如果减少屏障后后续 System 读取了尚未完成的写入,耗时再低也不算优化。保留结果校验、事件数量和最终状态一致性检查,并分别测试小、中、大三种实体规模。当工作量不足以抵消调度成本,或已受内存带宽限制时,让小 System 串行执行往往更合适。