
游戏客户端架构 / 系统课时
AoS 与 SoA 怎么取舍
AoS 与 SoA 怎么取舍
同一个移动系统只需要位置和速度,却可能遍历数万名角色。如果数据按实体打包,CPU 可能把许多用不到的字段带进缓存。本课用 C 写出 AoS 与 SoA 的等价更新,结合内存排列判断什么时候该按实体存、什么时候该按字段存。
学习目标
- 读懂 AoS 与 SoA 的内存排列及字段访问跨度。
- 用两种布局计算完全相同的批量位置更新结果。
- 根据热路径读取的字段和实体规模选择布局,而非凭名称判断性能。
两种布局如何排数据
AoS(Array of Structures)是结构体数组,每个元素都包含一个实体的 x、y、vx、vy、hp。三个实体在内存中按记录连续摆放:读取下一实体的 x,需要跨过一个 Unit 记录,其步长是 sizeof(Unit),可能包含内存对齐产生的填充。
SoA(Structure of Arrays)把 x[]、y[]、vx[]、vy[]、hp[] 分开。每个数组的同类数值连续,相邻 x 的步长是 sizeof(float);不同字段数组之间不要求彼此相邻。相同下标必须代表同一实体,否则位置与速度会错配。
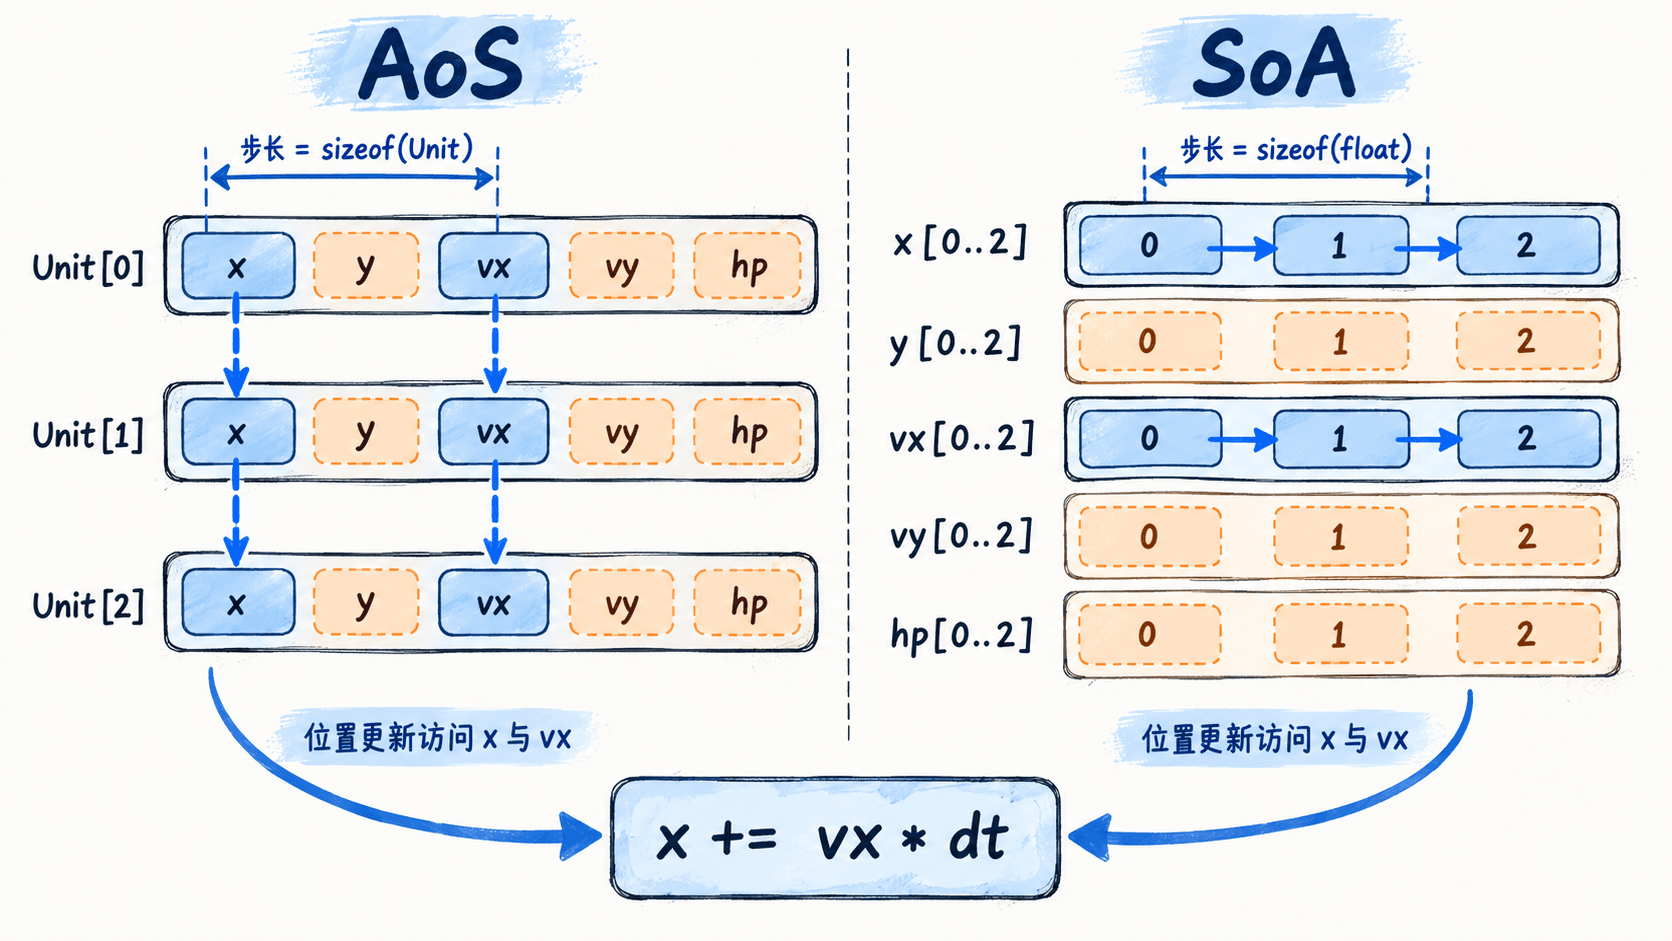
对于批量位置更新,系统只需要读取 x 和 vx,再把结果写回 x。AoS 和 SoA 保存的业务信息完全相同,区别在于处理器为了访问这些字段,需要经过怎样的内存地址序列。
用相同数据执行位置更新
下面是完整的 C11 程序,保存为 ecs_layout.c,在有 C 编译器的终端执行 cc -std=c11 ecs_layout.c -o ecs_layout,随后执行 ./ecs_layout。两个循环都只更新 x += vx * dt,未读取的 y、vy、hp 用于呈现真实结构中的冷字段。
#include <stdio.h>
#define N 3

typedef struct {
    float x, y, vx, vy;
    int hp;
} Unit;

typedef struct {
    float x[N], y[N], vx[N], vy[N];
    int hp[N];
} UnitSoA;

int main(void) {
    Unit aos[N] = {
        {0, 0, 1, 0, 100},
        {10, 0, -2, 0, 80},
        {20, 0, 0.5f, 0, 60}
    };
    UnitSoA soa = {
        .x = {0, 10, 20},
        .y = {0, 0, 0},
        .vx = {1, -2, 0.5f},
        .vy = {0, 0, 0},
        .hp = {100, 80, 60}
    };
    const float dt = 1.0f;

    // AoS 按整条实体记录跨步访问 x 和 vx
    for (int i = 0; i < N; ++i) {
        aos[i].x += aos[i].vx * dt;
    }
    // SoA 分别顺序遍历两个连续的字段数组
    for (int i = 0; i < N; ++i) {
        soa.x[i] += soa.vx[i] * dt;
    }

    printf("AoS: %.1f %.1f %.1f\n", aos[0].x, aos[1].x, aos[2].x);
    printf("SoA: %.1f %.1f %.1f\n", soa.x[0], soa.x[1], soa.x[2]);
    return 0;
}
预期输出:
AoS: 1.0 8.0 20.5
SoA: 1.0 8.0 20.5
两组结果完全一致。第一个实体从 0.0 移动到 1.0,第二个实体因为速度为负而从 10.0 移动到 8.0,第三个实体从 20.0 移动到 20.5。
代码中的 aos[i].x 与 soa.x[i] 访问的是同一个逻辑属性,但前者通过结构体记录定位字段,后者直接通过字段数组定位。数据布局的差异不会改变这一轮计算的数学结果。
为什么 SoA 可能更适合批量系统
对这段循环,CPU 每次只需要 x 与 vx。AoS 的两次访问发生在一条较大的 Unit 记录里,连续迭代会跨过 y、vy、hp 等非必要字段所在的字节;按缓存行加载时,这些数据可能占用带宽。SoA 则把两个热字段组织成紧密的数据流,更容易充分利用缓存行和 SIMD 向量化。
不过,连续不代表必然更快。现代处理器会预取数据,编译器也可能重排或向量化循环。AoS 的跨步访问不一定意味着每次都发生缓存未命中,SoA 也可能因同时访问多个数组而增加管理开销。
上面的三元素示例只验证计算正确,不构成速度基准:数据可能全部位于缓存,编译器也会优化访问。若要比较,应使用足够大的相同数据集、相同编译选项,分别测量多次运行耗时,并避免把初始化时间混入更新耗时。
选型时同时看访问模式和维护成本
| 实际工作负载 | 更值得先尝试 | 原因 |
|---|---|---|
| 大批实体只更新少数字段 | SoA | 顺序读取热字段,减少无关数据进入缓存 |
| 一次处理单个实体的大部分字段 | AoS | 同一实体的状态集中,访问和调试直观 |
| 系统既有批量计算又有复杂实体逻辑 | 分块或混合布局 | 在批处理效率和数据管理之间折中 |
SoA 的额外责任是保持各数组下标严格同步;如果实体会频繁创建和删除,通常还要维护“实体 ID → 稠密索引”的映射,删除换位后同步更新映射。AoS 也需要管理实体生命周期,但按记录组织更简单。
对于大型 ECS,也不必在整个项目里只选择一种布局。例如,频繁执行的运动系统可以把位置和速度放进适合连续扫描的数组,而低频配置或编辑器数据仍然可以采用更方便维护的对象结构。分块 ECS 还可以把相同组件组合的实体放在同一批连续存储区域中。
把示例中的 dt 改为 2.0f 后,两个布局的输出都应变为 2.0、6.0、21.0。布局改变的是数据访问方式,不是运动规则。实际项目应先观察系统最常访问哪些字段,再用可重复的性能测试决定是否改成 SoA。