
游戏客户端架构 / 系统课时
把热点系统改成并行任务
把热点系统改成并行任务
当大量实体都要在同一固定步更新位置时,逐个执行的移动系统可能占据主要帧时间。并行改造的关键不是直接启动多个线程,而是先识别可拆分的数据、写入所有权和真正需要等待的消费者,再用串行基线验证结果。
学习目标
- 根据读写组件集合挑选能按实体分块的热点系统。
- 构造无共享写冲突的任务分片,并确定依赖和局部同步点。
- 对照串行结果验证正确性,评估任务粒度与调度开销。
从性能数据挑选目标
先使用引擎 Profiler 在固定场景、相同实体数量和相同更新频率下记录各 System 的耗时,再选择纯计算占比高、每个实体工作相似、相互依赖少的批处理。仅凭实体数量大就并行,可能因线程唤醒、任务排队和同步等待反而变慢。
移动积分通常适合首批尝试:任务读取 Position、Velocity 和固定步长,计算新的位置。只要每个任务只负责自己的实体区间,彼此无需争用同一组件。相反,邻居避障、全局路径搜索、随机共享状态和频繁创建实体的逻辑,不能不加改造就按相同方式拆分。
写下数据访问契约,比口头约定“应该线程安全”更可靠:移动计算读取本帧快照,只输出下一位置;物理或渲染消费必须发生在移动结果提交后。如果输入系统还在修改本帧速度,移动任务就不能提前读取。
先划分所有权,再安排依赖
将满足 Position + Velocity 的查询按稳定的实体顺序切成若干不重叠数据块。每块被一个任务独占;任务可以共享只读快照,但不能同时写同一索引,也不能在计算过程中增删会改变分块边界的实体。
调度关系可以写为 Input → Snapshot → MoveChunks → Join → Commit → Physics。其中 MoveChunks 可以并行,Join 只等待那些产生物理所需位置的任务;与移动数据无关的工作不必被一条全局栅栏阻塞。渲染应读取物理或表现插值阶段确认的版本,而不是半提交的位置数组。
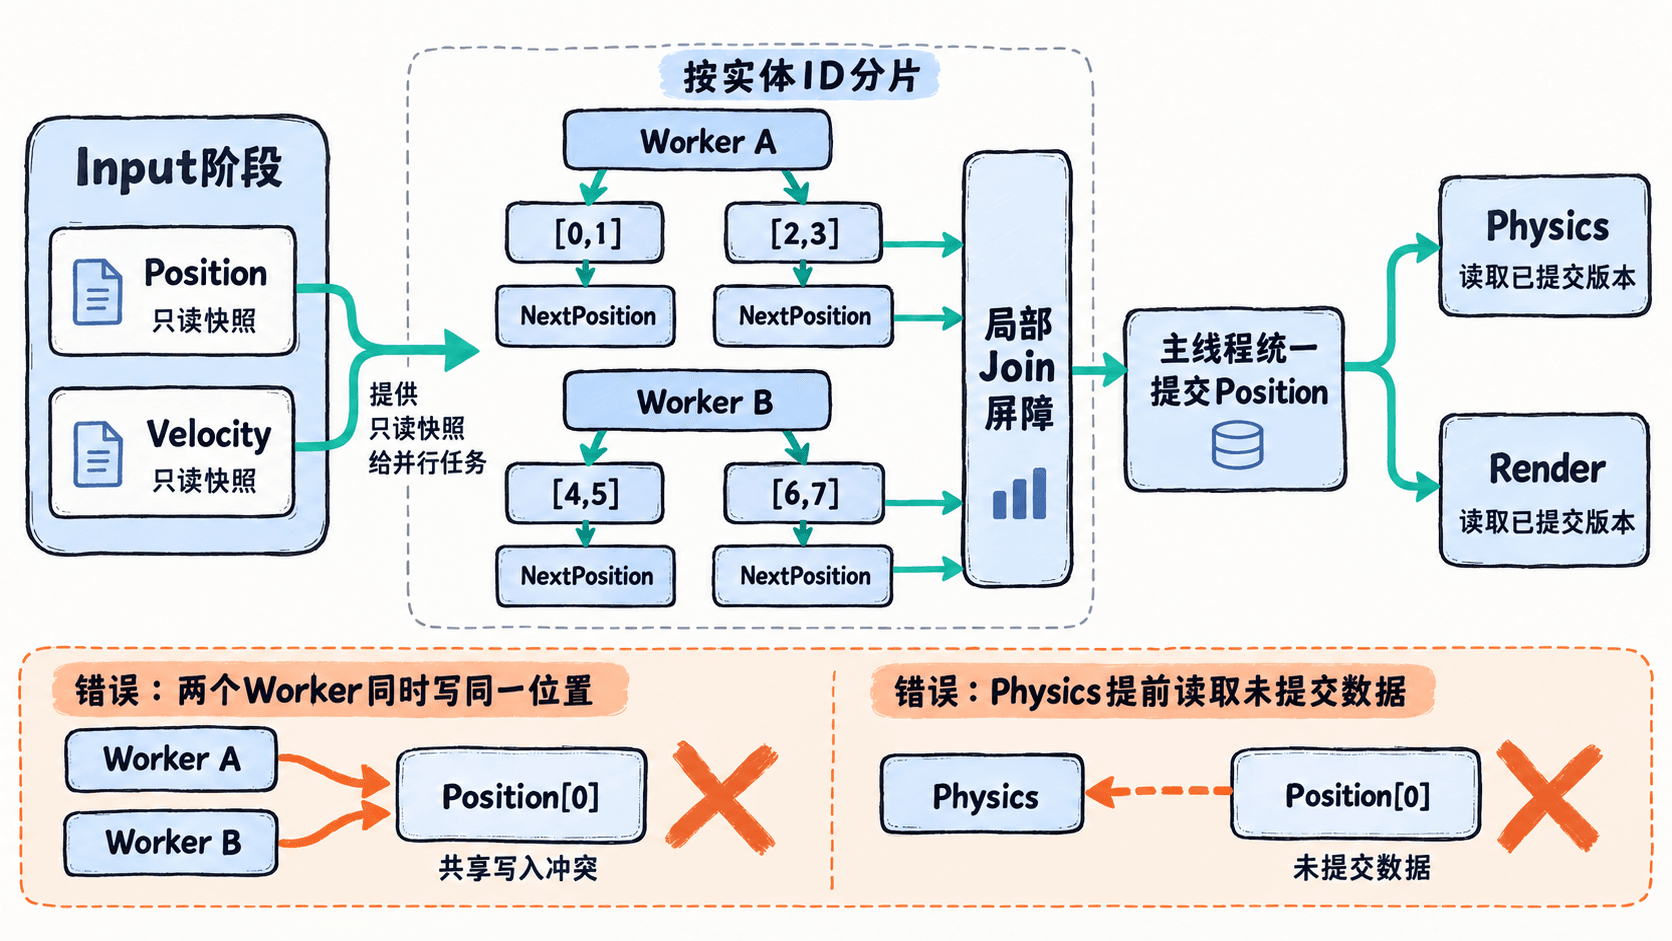
在真实 ECS 中可以给每个任务分配互不重叠的可写 Chunk;为了易于独立验证,下面的示例采用每块返回 NextPosition、主线程统一回写的方式。它牺牲了部分复制开销,换来更直观的所有权边界。
用串行基线检查并行计算
把下面代码保存为 parallel_move.py 并作为普通 Python 3 脚本运行。示例用 ProcessPoolExecutor 而不是纯 Python 线程执行 CPU 任务;它拆成四块,每块两个实体,两个工作进程分担计算。固定步长为 0.5 秒,所有实体速度都是 2.0。
from concurrent.futures import ProcessPoolExecutor

def advance(batch):
    # 进程只计算自身分片,结果在主进程按顺序合并
    dt = 0.5
    return [(entity, x + vx * dt) for entity, x, vx in batch]

def main():
    positions = {entity: float(entity) for entity in range(8)}
    velocities = {entity: 2.0 for entity in range(8)}
    snapshot = [(entity, positions[entity], velocities[entity])
                for entity in sorted(positions)]
    chunks = [snapshot[i:i + 2] for i in range(0, len(snapshot), 2)]
    # 串行结果是本帧正确性基线
    expected = [item for batch in chunks for item in advance(batch)]

    with ProcessPoolExecutor(max_workers=2) as pool:
        batches = list(pool.map(advance, chunks))
    actual = [item for batch in batches for item in batch]
    assert actual == expected
    # 所有计算完成,再把下一位置提交到组件存储
    for entity, x in actual:
        positions[entity] = x
    print("分片:", len(chunks))
    print("串并结果一致:", actual == expected)
    print("实体0:", positions[0])
    print("实体7:", positions[7])

if __name__ == "__main__":
    main()
预期输出:
分片: 4
串并结果一致: True
实体0: 1.0
实体7: 8.0
pool.map() 按输入分片顺序返回结果,因而可以与串行结果逐项比较;断言通过后才写回 positions。这验证了此次拆分结果一致,不等于证明它更快。示例只有八个实体,进程启动和数据序列化的成本通常远高于计算本身,不能将它当成性能收益测试。
调整粒度和同步范围
任务切得过细,会让调度和结果合并占据主要耗时;切得过粗,少数任务运行很久,其他工作线程在屏障处闲置。实际工程先按工作线程数划分少量连续块,再结合每块耗时分布调整;对于单个实体计算量差异很大的系统,可以用动态任务队列平衡负载,但仍须保持实体写入区间不重叠。
对于汇总命中数、累计伤害或计算统计量的场景,不要让所有 Worker 争写一个计数器。每块产出局部结果,在 Join 后归约。浮点归约的加法顺序可能影响末位结果;如果战斗回放或网络同步要求确定性,就必须指定稳定合并顺序与数值策略,而不是依赖任务完成先后。
结构变化也应留在安全点:并行任务可以登记生成或销毁请求,但不能在别的任务仍持有该查询视图时直接更改 Chunk 分布。跨系统依赖按实际读写集合建立,避免把所有任务都绑到每帧唯一一个全局屏障。
验证改造是否值得上线
至少做三组检查。正确性方面,用相同初始快照跑串行和并行更新,比对实体集合、位置和状态;简单计算应逐项相等,复杂浮点计算则按系统确定性要求判断。边界方面,覆盖空查询、非整除分片、实体死亡及固定步连续运行,观察是否有重复更新、漏更新或读取半成品。
性能方面,应在目标运行环境和典型实体规模下比较改造前后的帧耗时分布、热点 System 的墙钟耗时、屏障等待时间和额外内存。进程池示例只是架构正确性演示;引擎中的高性能实现通常使用原生 Job 系统或具备并行执行能力的任务调度器,并尽可能避免每帧进程通信与复制。只有测得整体帧时间改善且回归稳定,才算完成一次有效的并行改造。