
游戏客户端架构 / 系统课时
Chunk 为什么适合批量迭代
Chunk 为什么适合批量迭代
系统已经按组件组合选中了待更新的实体,下一步仍可能因内存访问零散而变慢。本课把实体数据装入固定容量的 Chunk,沿组件列顺序执行位置更新,并识别连续访问带来的收益与块内空位、结构迁移等成本。
学习目标
- 说明 Archetype、Chunk、组件列和已用行数的关系。
- 追踪按 Chunk 扫描
Position与Velocity的更新路径。 - 判断批量迭代的收益及空间、迁移、调度开销。
Chunk 将同类实体分成固定容量的块
Archetype 根据完整组件签名分组;一个 Archetype 下可以分配多个 Chunk。Chunk 通常有固定的字节预算,并为该组合中的实体 ID 和各组件保留成列的数据区域。列内按行紧密排列,同一行号对应同一个实体;具体对齐和内存布局因 ECS 实现而异。
例如,一个简化的 Position+Velocity Archetype 每个 Chunk 最多放 3 个实体,5 个实体就分成两个块:Chunk 0 存 101~103,Chunk 1 存 104~105。第二块只占用 2 行,遍历时必须使用已用行数,不能读取预留但未初始化的第 3 行。
查询如何转成连续扫描
运动系统先筛选含 Position 和 Velocity 的 Archetype,再逐个访问其中的 Chunk。在每个 Chunk 内,按行读取速度列并写回位置列:x = x + vx * dt。若组件组合还含 Health,这次更新不需要访问该列。
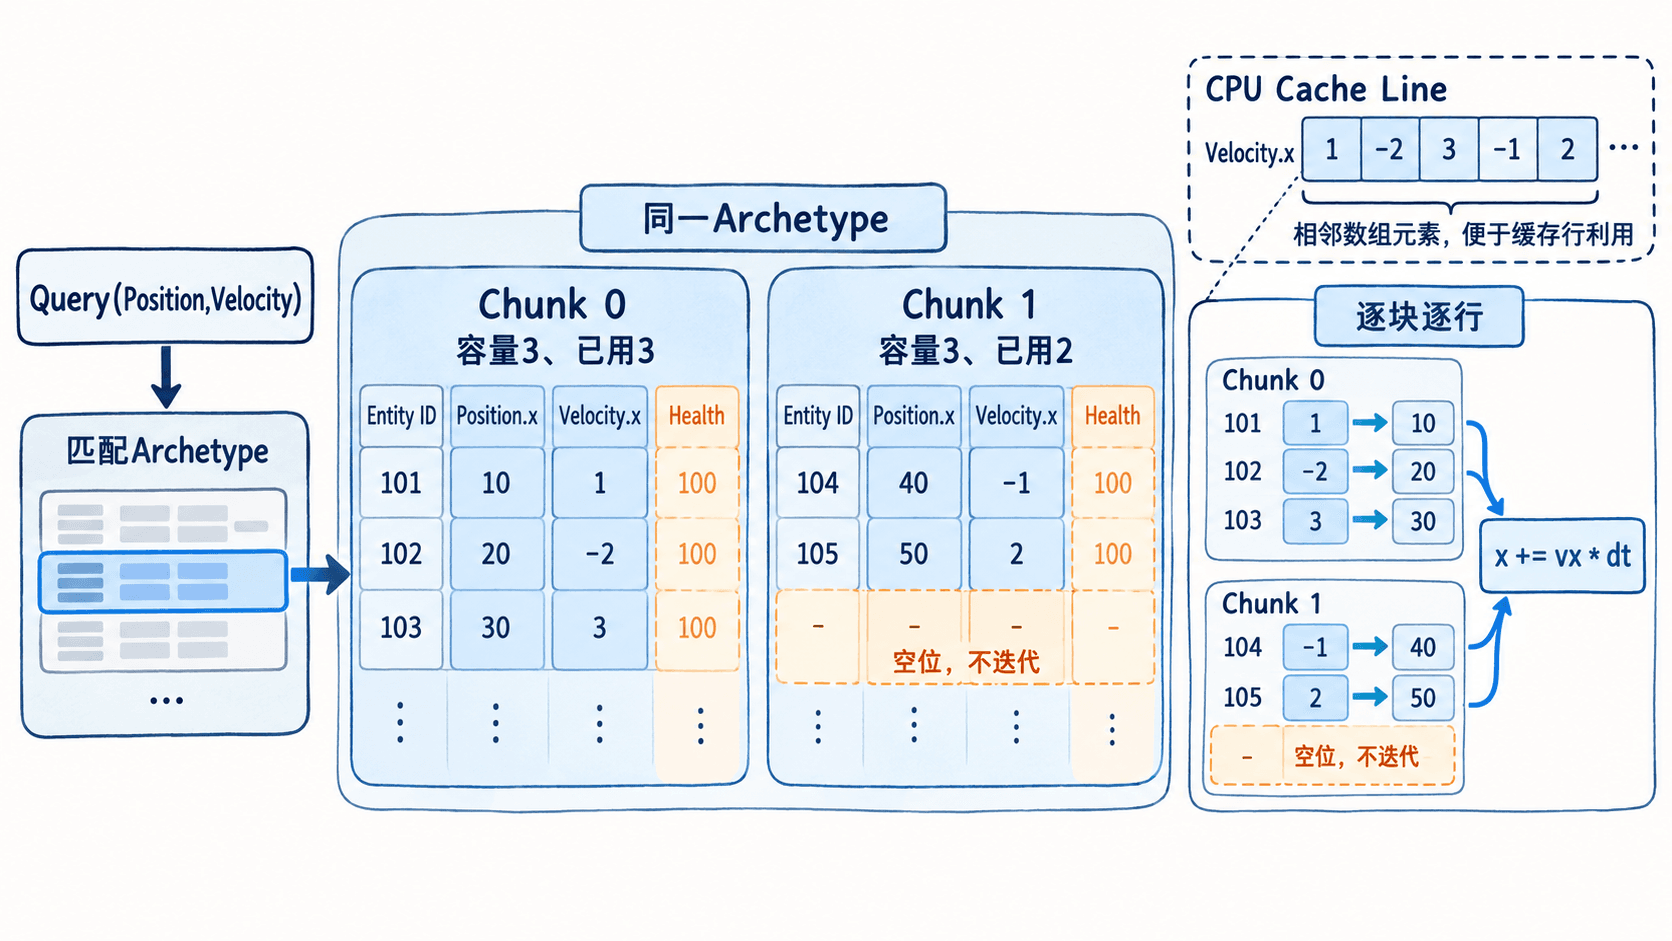
相较于逐个追踪分散对象指针,连续数值列通常能让一次缓存行加载带来更多后续会用到的数据,也便于编译器优化循环。不过 Chunk 不等于 CPU 缓存行;是否真的更快,还取决于组件大小、访问模式、查询选择性和实际硬件。
用最小程序遍历两个 Chunk
下面使用 Python 标准库 array('f') 模拟紧凑的浮点组件列,每块容量为 3。它是便于验证的模型,不代表某个 ECS 框架的具体 API。
from array import array

records = [
    (101, 0.0, 2.0),
    (102, 1.0, 1.0),
    (103, 2.0, 0.0),
    (104, 3.0, -1.0),
    (105, 4.0, 2.0),
]
capacity = 3
chunks = []

for start in range(0, len(records), capacity):
    batch = records[start:start + capacity]
    # x 与 vx 分列存储,模拟块内按列连续布局
    chunks.append({
        "ids": [entity_id for entity_id, _, _ in batch],
        "x": array("f", (x for _, x, _ in batch)),
        "vx": array("f", (vx for _, _, vx in batch)),
    })

dt = 0.5
for index, chunk in enumerate(chunks):
    # 只遍历真实使用的行数,跳过容量中的空位
    for row in range(len(chunk["ids"])):
        chunk["x"][row] += chunk["vx"][row] * dt
    print(f"Chunk {index}: {chunk['ids']} -> {list(chunk['x'])}")
预期输出:
Chunk 0: [101, 102, 103] -> [1.0, 1.5, 2.0]
Chunk 1: [104, 105] -> [2.5, 5.0]每个块都执行相同更新逻辑,第二块仅处理两行。array('f') 存储连续的单精度浮点值;这里的实体 ID 列只是演示索引,生产级 ECS 还需要管理类型元数据、行数、对齐和实体位置映射。
批量收益不能脱离成本讨论
固定容量块有利于复用已分配内存,也方便把多个 Chunk 分派给不同任务。但在上述例子中,共分配 6 行容量只用了 5 行,存在 1 行闲置;若实际按整块预留空间,低占用率会增加内存开销。
另外,结构迁移可能复制组件并整理源块;组件越大,搬迁成本越高。Chunk 太小会增加块数、迭代入口和任务调度开销,太大则可能扩大工作集、降低并行任务拆分灵活性。较实用的衡量方式是记录匹配的 Chunk 数、已用行数、每次更新读取的字节量和实际执行耗时,再调整块大小与组件组合,而不是简单认定 Chunk 越大越快。