
编码与格式 / 系统课时
区分交错声道与平面声道排列
区分交错声道与平面声道排列
同样是双声道 PCM 音频,采样值可以交替存放,也可以按声道分别存放。两种排列方式包含相同的声音信息,但内存访问方式不同。读懂 packed 与 planar 的区别,才能正确处理音频缓冲区、调用编解码接口,并避免声道串音和数据错位。
学习目标
- 识别 packed 与 planar 两种采样排列,正确计算采样位置和缓冲区大小。
- 区分声道数量、声道布局和采样格式,理解它们各自描述什么。
- 使用双声道示例验证数据排列,并判断格式转换时需要执行的操作。
从双声道采样观察内存排列
假设音频采用双声道、48 kHz 采样率、16 位有符号整数 PCM,每个声道连续采集 4 个采样点。左右声道的值分别为:
| 采样帧序号 | 左声道 L | 右声道 R |
|---|---|---|
| 0 | 100 | 1000 |
| 1 | 200 | 2000 |
| 2 | 300 | 3000 |
| 3 | 400 | 4000 |
这里的一个采样帧(sample frame)指同一采样时刻所有声道的采样值。双声道的 4 帧共有 8 个采样值,而不是 4 个。
**交错排列(packed,也称 interleaved)**将同一时刻各声道的采样值放在一起,顺序为 L0、R0、L1、R1,以此类推。它通常对应一个连续的数据平面。
**平面排列(planar)**将每个声道的采样值连续存放,左声道为 L0、L1、L2、L3,右声道为 R0、R1、R2、R3。两个声道通常分别通过独立的数据平面访问,即使底层分配器可能把它们放在同一块内存中。
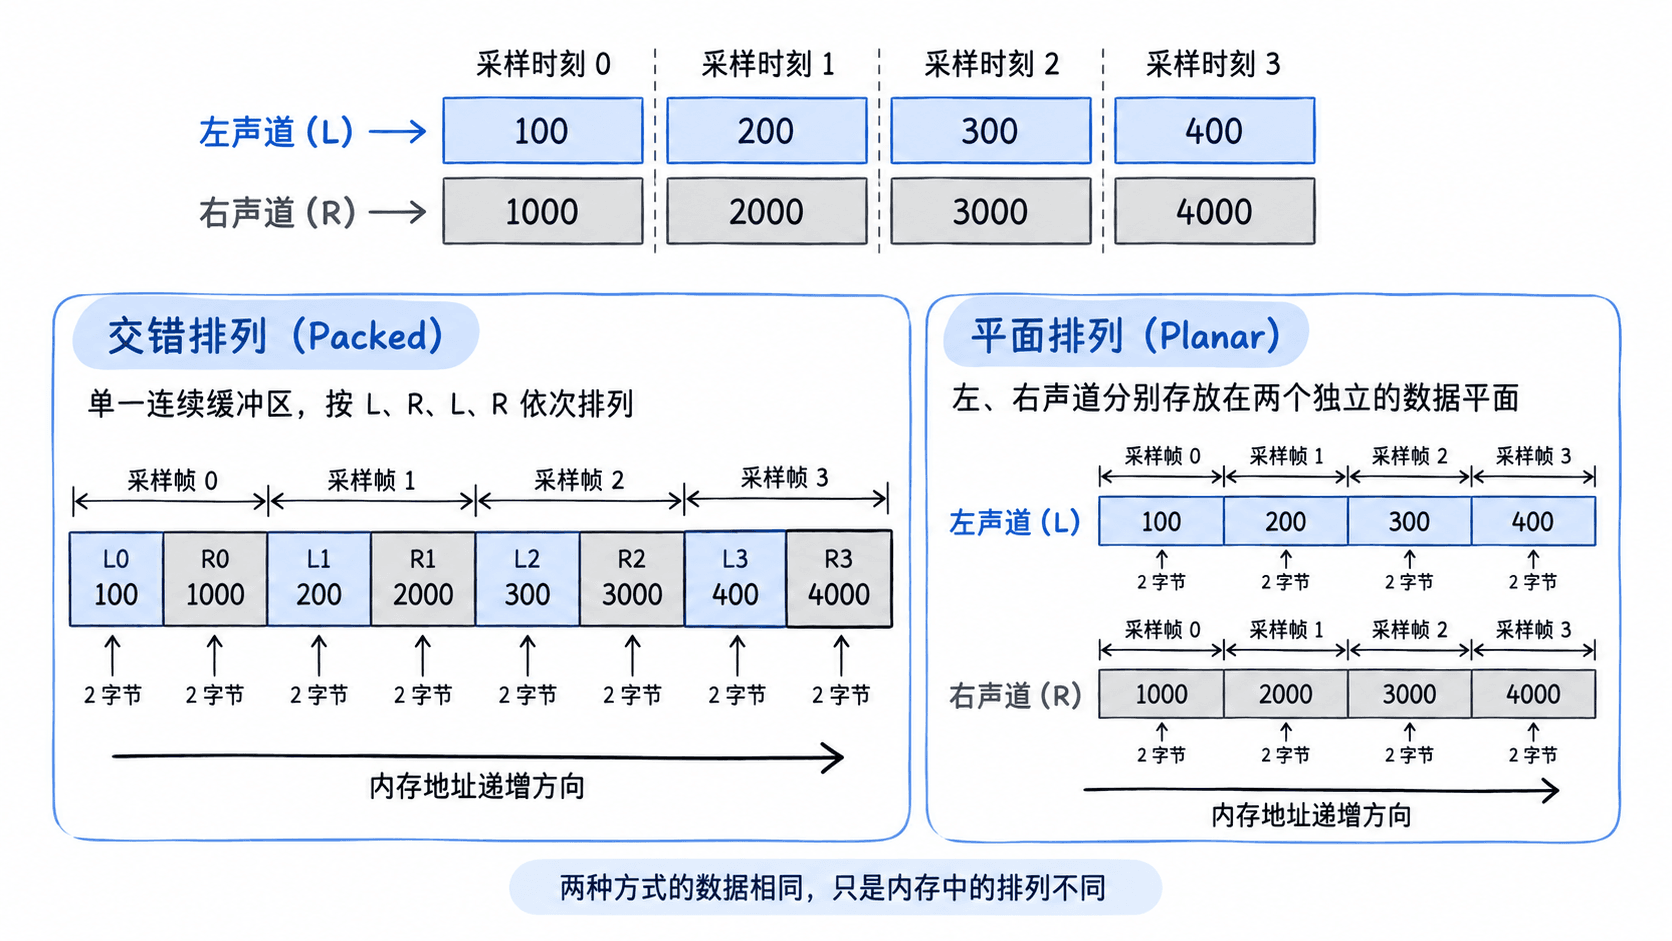
注意:图中的 100、1000 等表示解码后的数值,不是实际字节序列。16 位 PCM 每个采样值占 2 字节;具体字节先后还受大端、小端字节序影响,不能把采样排列和字节序混为一谈。
计算采样地址与缓冲区大小
对于 packed 排列,假设每个声道样本宽度为 B 字节、声道数为 C、采样帧索引为 i、声道索引为 c,且数据连续、无额外填充,则采样值的字节偏移量为:
对于 planar 排列,各声道拥有独立的数据平面,第 c 个声道中的第 i 个采样值相对该平面起始地址的偏移为:
以双声道、16 位、4 帧为例,B=2、C=2。读取第 3 帧(索引 2)的右声道:packed 的字节偏移为 (2×2+1)×2=10;planar 的右声道平面内偏移为 2×2=4 字节。
假设没有行跨度或末尾填充,总有效数据量为:
本例为 4×2×2=16 字节。packed 通常是一块 16 字节的有效采样数据;planar 则是每个声道 8 字节,共 16 字节。实际库中的缓冲区可能因对齐而分配更多空间,应以接口返回的行跨度或缓冲区容量为准,不能总是假定物理分配大小等于有效数据量。
当采样率为 48 kHz 时,双声道 S16 PCM 每秒有效数据量为 48000×2×2=192000 字节,约为 192 kB/s。packed 和 planar 不改变这项原始音频数据量。
用 Python 验证两种排列
以下示例使用 Python 3 标准库,直接操作采样值列表,无须安装第三方依赖。它模拟双声道交错写入、平面拆分及重新交错,并检查转换是否丢失数据。
left = [100, 200, 300, 400]
right = [1000, 2000, 3000, 4000]

# packed:每一帧依次写入左、右声道
packed = [sample for frame in zip(left, right) for sample in frame]

# planar:按声道拆分,每个平面内部保持时间顺序
planar = [packed[0::2], packed[1::2]]

# 将两个声道平面重新交错,检查往返转换
restored = [sample for frame in zip(*planar) for sample in frame]

print("packed:", packed)
print("planar:", planar)
print("restored:", restored)
print("identical:", restored == packed)
预期输出:
packed: [100, 1000, 200, 2000, 300, 3000, 400, 4000]
planar: [[100, 200, 300, 400], [1000, 2000, 3000, 4000]]
restored: [100, 1000, 200, 2000, 300, 3000, 400, 4000]
identical: True
这个示例处理的是 Python 整数列表,并没有生成实际的二进制 PCM 文件。如果要写入 S16 PCM 字节缓冲区,还需要明确整数范围、字节序和目标接口规定的声道顺序。
实际进行 packed 与 planar 转换时,通常只需要重排样本,不需要插值或重采样。前提是采样率、样本数、数据类型及声道对应关系保持一致。
区分声道数量、声道布局和采样格式
声道数量(channel count)只描述同时存在多少路音频采样,例如 1、2、6 或 8。声道布局(channel layout)进一步描述每一路的含义和空间位置。采样格式(sample format)则描述单个样本的数据类型以及是否采用平面排列。
| 属性 | 示例 | 解决的问题 |
|---|---|---|
| 声道数量 | 2 | 每帧包含几个声道样本 |
| 声道布局 | Stereo:FL、FR | 哪个样本属于左前或右前声道 |
| 采样格式 | S16、S16P、FLT、FLTP | 样本是什么类型、怎样存储 |
| 采样率 | 48000 Hz | 每个声道每秒采样多少次 |
在 FFmpeg 的音频采样格式命名中,AV_SAMPLE_FMT_S16 表示有符号 16 位整数 packed,AV_SAMPLE_FMT_S16P 表示对应的 planar 格式;AV_SAMPLE_FMT_FLT 与 AV_SAMPLE_FMT_FLTP 则分别表示 32 位浮点 packed 和 planar。这里的 P 是 planar 标记,不代表精度更高。
同样是两个声道,既可能是普通立体声的 FL、FR,也可能是其他双声道组合。不能仅凭声道数量 2 就在所有情况下推断具体布局。布局也不保证两个声道一定使用哪种内存排列。
在实际音频接口中选对数据布局
packed 适合直接按照采样帧顺序读写的数据通路,例如常见的交错式 PCM 文件内容和部分播放设备接口。planar 适合按声道独立处理的算法,例如分别调整左右声道增益、执行单声道滤波或处理多声道矩阵。
在 FFmpeg 的 libavutil 接口中,可以使用 av_sample_fmt_is_planar() 判断采样格式是否为 planar。对于 packed 音频,首个数据指针指向交错样本;对于 planar 音频,需要按声道取得对应的数据平面。涉及 AVFrame 时,还应结合声道布局与 extended_data 访问数据,而不是假设 data 数组始终容纳所有声道指针。
工程接入时可按以下顺序核对:
- 确认每个声道的采样率及每帧样本数,避免把总采样值数量误当作每声道样本数。
- 确认声道数量和明确的声道布局,例如 Stereo 的 FL、FR,并核对声道排列顺序。
- 确认样本类型和 packed/planar 属性,例如 S16 与 S16P,计算样本字节宽度。
- 读取缓冲区时遵守实际平面数量、行跨度和有效样本数;格式不匹配时先重排或转换。
- 使用左右声道不同的测试信号回放或检测,验证两个声道没有交换、重复或串音。
可以用一个简单测试发现错误:让左声道始终为 100,右声道始终为 1000,连续生成 4 帧。正确的 packed 数据应交替出现 100 和 1000;正确的 planar 数据应分别在两个平面得到四个 100 和四个 1000。如果读取结果与这一规律不一致,应先检查缓冲区排列,而不是立即怀疑采样率或编解码器。
无论音频包含 2 个还是 8 个声道,判断顺序都相同:先确认每个声道代表什么,再确定采样值的数据类型,最后按照 packed 或 planar 的地址规则访问。转换内存排列不会自动改变声道布局,也不会提高音质。