
编码与格式 / 系统课时
用响度滤镜修正音量差异
用响度滤镜修正音量差异
两段音频即使峰值电平相同,听起来也可能一段很响、一段很轻。使用 FFmpeg 的 loudnorm 滤镜,可以按感知响度测量并调整音量,同时限制真实峰值。本篇通过一次测量、一次归一化和一次复测,把不同来源的音频处理到接近一致的听感。
学习目标
- 区分 LUFS 响度、dBFS 峰值与 dBTP 真实峰值。
- 使用
loudnorm完成两遍响度归一化,并理解关键参数。 - 通过复测判断输出是否达到目标,识别无法简单线性调整的素材。
为什么峰值相同却听起来不同
峰值表示信号的最大瞬时幅度,响度则更接近人耳对一段声音整体强弱的感受。两段录音都达到 -1 dBFS,一段只有偶尔出现的鼓点,另一段持续有人声和音乐,后者通常听起来更响。
FFmpeg 的 loudnorm 基于 EBU R128 响度测量,常见指标如下。
| 指标 | 单位 | 实际含义 |
|---|---|---|
| Integrated Loudness(I) | LUFS | 整段节目的综合响度 |
| Loudness Range(LRA) | LU | 节目响度变化范围,不等于最大值减最小值 |
| True Peak(TP) | dBTP | 考虑采样点之间重建峰值的真实峰值估计 |
| Sample Peak | dBFS | 数字采样点的最大电平 |
例如,两段素材的综合响度分别为 -24 LUFS 和 -16 LUFS,若按相同播放增益输出,后者通常明显更响。两者相差 8 LU,并不意味着采样峰值也相差 8 dB。
本篇采用一组演示目标:综合响度 -16 LUFS、响度范围上限 11 LU、真实峰值上限 -1.5 dBTP。这是便于练习的统一交付参数,不代表所有平台的强制标准。实际发布时应以目标平台或项目交付规范为准。
测量输入素材的响度
先确认本机安装的 FFmpeg 包含 loudnorm 滤镜,并准备一段名为 input.wav 的音频。以下命令适用于支持该滤镜的 FFmpeg 6.x、7.x 和 8.x;不同版本的日志排版可能略有差异。
ffmpeg -hide_banner -filters | grep loudnorm预期结果:过滤器列表中出现 loudnorm;若没有结果,检查 FFmpeg 构建是否包含该滤镜。在 Windows PowerShell 中,可将 grep loudnorm 换为 Select-String loudnorm。
使用第一遍扫描读取整段音频,不生成输出文件:
ffmpeg -hide_banner -i input.wav -af "loudnorm=I=-16:LRA=11:TP=-1.5:print_format=json" -f null -预期结果:命令运行结束后,日志中出现一个 JSON 对象,包含 input_i、input_tp、input_lra、input_thresh、output_i、output_tp、output_lra、output_thresh、normalization_type 和 target_offset 等字段。输入响度需要根据实际素材计算,不能预先假定为固定数值。
其中,input_i 是输入综合响度,input_tp 是输入真实峰值,input_lra 是输入响度范围,input_thresh 是相对门限计算后的绝对响度门限。target_offset 是本次分析得到的偏移补偿量,后续第二遍处理需要原样传入。
使用两遍处理得到可重复的响度
loudnorm 支持动态模式和线性模式。单遍处理时通常采用动态模式,适合快速处理;需要对完整素材进行可复现的文件转码时,推荐先测量,再将测量值提供给第二遍。
两遍处理的关键是:第一遍记录输入指标,第二遍传入相同目标和测量结果。不要拿另一段素材的扫描值复用,否则输出无法可靠校准。
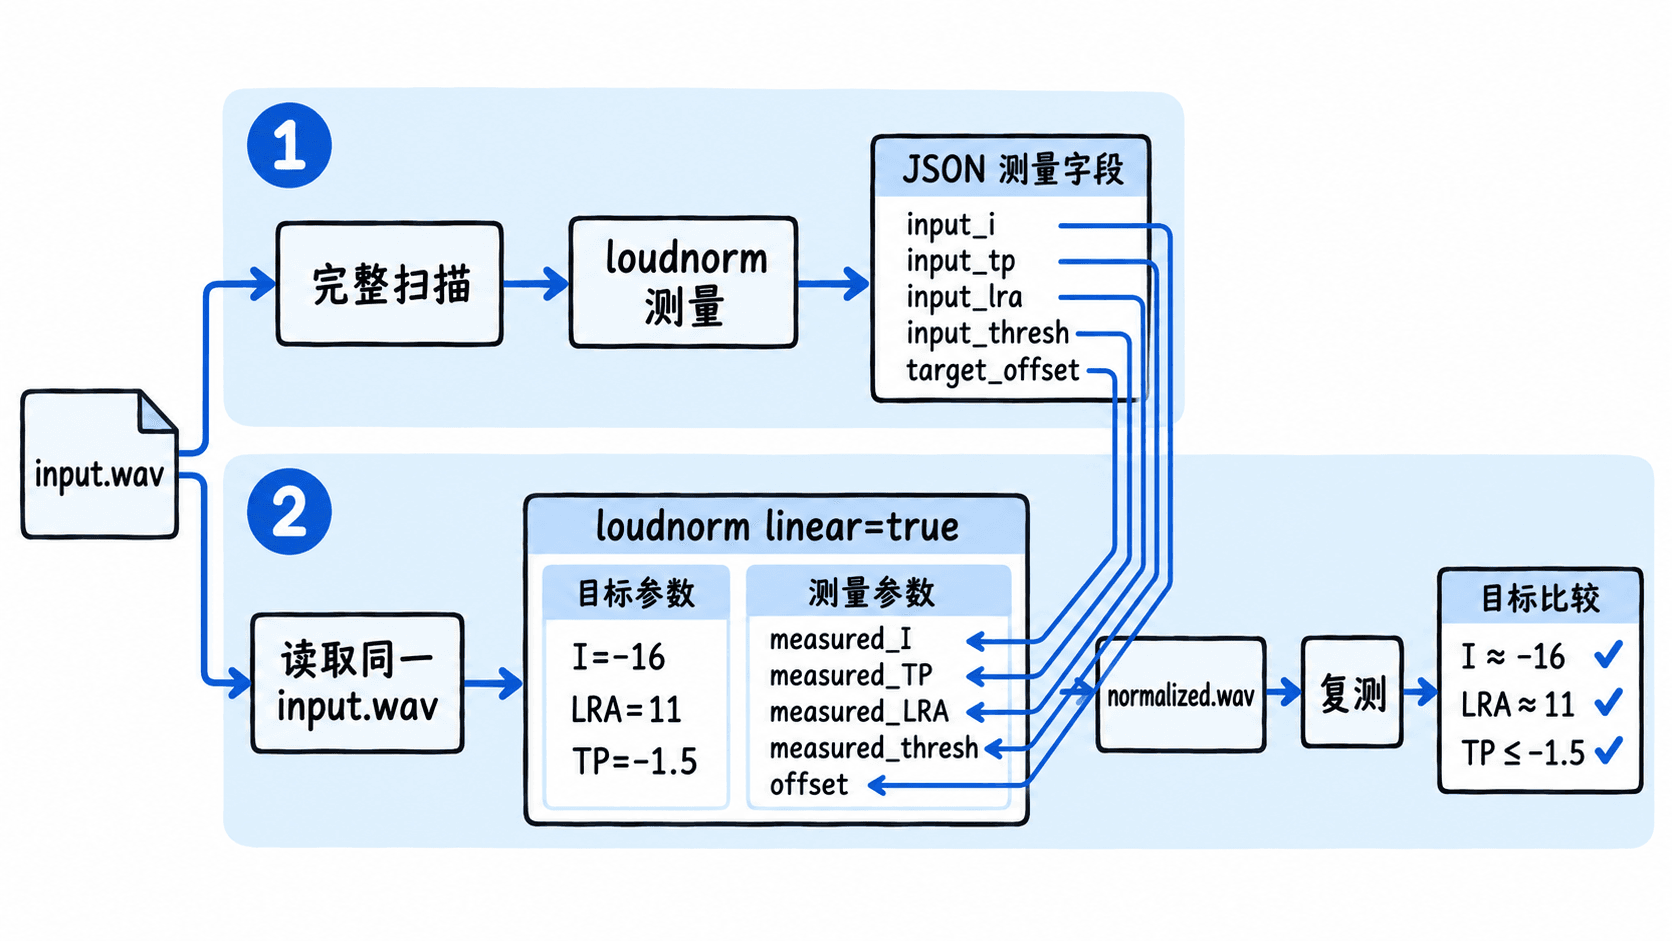
假设第一遍扫描某段素材得到下列测量值:
| 测量字段 | 示例值 |
|---|---|
input_i |
-22.00 LUFS |
input_tp |
-3.50 dBTP |
input_lra |
5.00 LU |
input_thresh |
-32.50 LUFS |
target_offset |
0.00 LU |
这些数字仅用于演示参数传递,实际操作必须替换成自己第一遍扫描的结果。第二遍执行:
ffmpeg -hide_banner -i input.wav -af "loudnorm=I=-16:LRA=11:TP=-1.5:measured_I=-22:measured_TP=-3.5:measured_LRA=5:measured_thresh=-32.5:offset=0:linear=true:print_format=summary" -ar 48000 -c:a pcm_s24le normalized.wav预期结果:生成 48 kHz、24 位 PCM WAV 文件 normalized.wav,并在日志中显示 Input Integrated、Output Integrated、Output True Peak 和 Normalization Type 等摘要。上述示例不保证输出恰好为 -16 LUFS,结果由真实音频数据决定。
参数 I、LRA、TP 是目标约束,measured_I、measured_TP、measured_LRA、measured_thresh 是第一遍输入测量结果,offset 对应 target_offset。参数名中的大小写应按示例保留。
线性模式并非永远能够生效。FFmpeg 需要确认线性增益不会令真实峰值超过 TP,且输入响度范围不大于目标 LRA;如果条件不满足,即使设置 linear=true,滤镜也会回退到动态模式。
例如输入为 -22 LUFS、-3.5 dBTP,直接增加约 6 dB 虽然能达到 -16 LUFS,却可能使真实峰值升至约 +2.5 dBTP,违反 -1.5 dBTP 上限。此时不能期待滤镜保持纯线性增益。
复测输出并判断是否合格
转码成功只代表文件已经生成,不代表响度必然符合目标。应对输出文件重新扫描,避免用第二遍日志替代独立验收。
ffmpeg -hide_banner -i normalized.wav -af "loudnorm=I=-16:LRA=11:TP=-1.5:print_format=json" -f null -预期结果:日志再次生成测量 JSON。这一次应该读取 input_i、input_tp 和 input_lra 来判断已经生成的文件,因为这些字段描述的正是复测输入 normalized.wav。
可以为本次练习设定如下验收规则:
| 检查项 | 建议条件 |
|---|---|
| 综合响度 | -16 LUFS ±0.5 LU |
| 真实峰值 | 不高于 -1.5 dBTP |
| 响度范围 | 观察是否符合项目要求,不强制等于 11 LU |
| 文件参数 | 48 kHz、24 位 PCM |
这些是本次练习的验收条件,不是 loudnorm 保证每段素材都能满足的输出承诺。LRA=11 表示目标响度范围约束,并非强制把所有音频扩展为 11 LU。
还可以使用 ffprobe 检查文件编码参数:
ffprobe -v error -select_streams a:0 -show_entries stream=codec_name,sample_rate,bits_per_raw_sample -of default=noprint_wrappers=1 normalized.wav预期输出:
codec_name=pcm_s24le
sample_rate=48000
bits_per_raw_sample=24
如果响度偏离目标,应先查看第二遍日志中的 Normalization Type,再检查输入真实峰值是否限制了可增加的增益。不要简单重复叠加一次归一化,因为多轮动态处理可能进一步改变素材的动态范围。
选择适合交付场景的处理方式
对几十条独立配音、访谈切片或短视频素材,按文件分别执行两遍测量和处理,通常比手工调整音量滑块更容易统一综合响度。但测量单位应与实际交付单位一致:若多个片段最后拼接成一整期节目,应对最终整期节目复测,必要时在拼接后统一归一化。
以下情况需要特别处理:
- 输入素材存在强烈瞬态峰值:响度目标与真实峰值上限可能冲突,应允许动态模式处理,或先修复异常峰值。
- 录音包含很长的静音:门限机制会影响综合响度统计,不应把 LUFS 当成所有采样音量的简单平均值。
- 多声道素材准备下混为立体声:应先确定最终声道布局,再对交付声道测量和归一化。
- 需要无损保留原始动态关系:先判断线性增益是否满足峰值约束,不要只因为设置了
linear=true就认定没有动态处理。
实际验收时,除了记录 LUFS 和 dBTP,还应试听开头、最响片段及结尾,检查是否出现明显抽吸感、失真或忽大忽小。响度数值接近只说明整体电平接近,不能代替对人声清晰度和动态处理副作用的检查。