
编码与格式 / 系统课时
拆分端到端直播延迟的来源
拆分端到端直播延迟的来源
直播画面比真实事件晚几秒,并不一定是网络太慢。采集、编码、推流、服务端处理和播放器都可能引入等待。本篇将直播延迟拆成可测量的阶段,通过具体算例建立延迟预算,并学会根据测量结果定位最值得优化的环节。
学习目标
- 识别从摄像头采集到观众屏幕显示的主要延迟来源。
- 使用分阶段测量数据计算端到端延迟和延迟预算。
- 根据不同直播协议和业务目标确定优化优先级。
端到端延迟从哪里产生
端到端直播延迟是指真实事件发生到观众屏幕显示对应画面的时间差。假设主持人在真实时间 12:00:00.000 举手,观众直到 12:00:02.400 才看到举手动作,那么这一路的端到端延迟为 2400 毫秒。
典型链路可以分为七个阶段:
- 采集:摄像头曝光、传感器读出、驱动和采集队列产生等待。
- 编码:视频帧进入编码器,经过帧重排、压缩和输出队列。
- 发送:推流端复用音视频、封装数据并写入网络发送队列。
- 网络传输:数据经上行网络、服务端与下行网络传递,受到 RTT、丢包和拥塞影响。
- 服务端处理:接入、转封装、转码、分发和直播切片可能额外排队。
- 播放缓冲:播放器积累一定量的数据,抵抗网络抖动和下载波动。
- 解码渲染:压缩帧解码后等待显示时机,最终呈现在屏幕上。
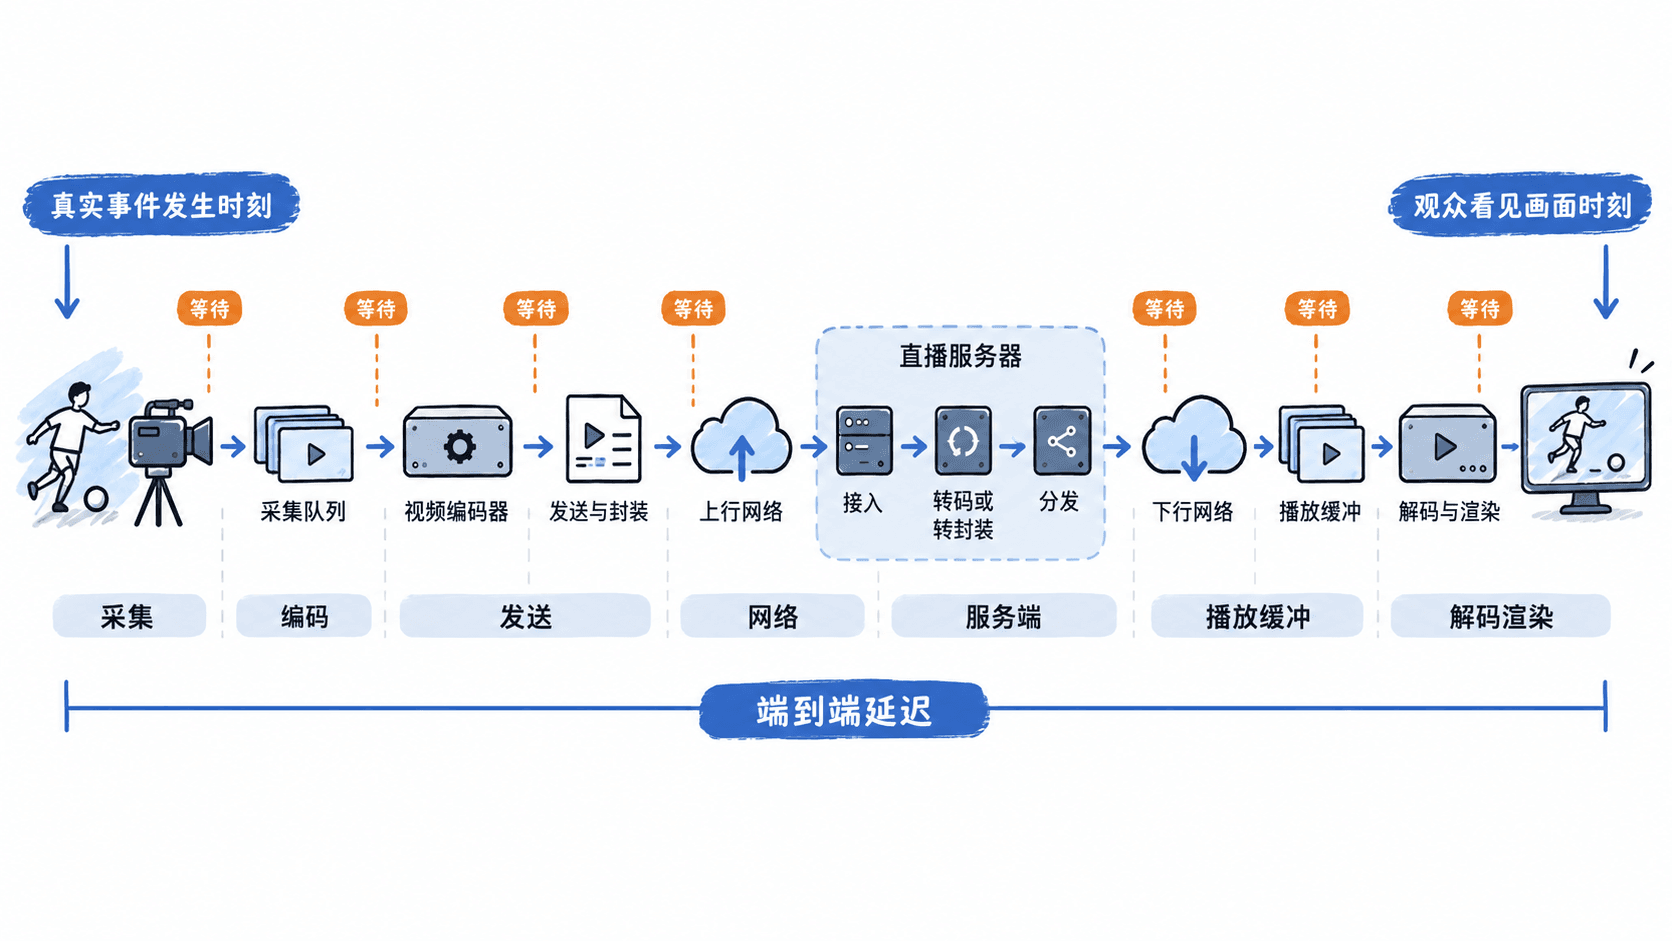
这里的阶段是测量边界,而不是保证每个环节严格串行。实际系统中,采集下一帧时可能同时编码上一帧;因此必须针对同一帧计算各测量点之间的时间差,避免把不同帧的处理耗时直接相加。
用一条时间线计算延迟
为每帧分配唯一标识,并在关键边界记录时间戳。下面假设各阶段使用已同步的时钟,且测量的是同一帧,从真实事件对应的采集起点到屏幕实际显示。
| 测量点 | 累计时间/ms | 当前阶段耗时/ms |
|---|---|---|
| 真实事件发生 | 0 | — |
| 采集输出 | 40 | 40 |
| 编码输出 | 110 | 70 |
| 发送完成 | 130 | 20 |
| 网络传输完成 | 230 | 100 |
| 服务端处理完成 | 310 | 80 |
| 播放缓冲完成 | 1510 | 1200 |
| 解码并显示 | 1570 | 60 |
对于这次观测,端到端总延迟为:
七个阶段中,播放器缓冲占 1200/1570,约为 76.4%。即使将编码耗时从 70 毫秒降低到 35 毫秒,总延迟也仅减少 35 毫秒。优先检查播放缓冲通常更有价值。
为不同直播目标建立预算
延迟预算是给各阶段设置允许消耗的时间上限。预算并不是平均分配:编码必须满足设备能力,网络要预留波动空间,而播放缓冲与协议、播放器策略密切相关。
假设要实现观众端到端延迟不超过 1000 毫秒,可以先制定一份工程试验预算:
| 阶段 | 预算/ms | 调整方向 |
|---|---|---|
| 采集 | 50 | 缩短采集队列,避免积压旧帧 |
| 编码 | 100 | 使用低延迟编码配置,限制帧重排 |
| 发送 | 30 | 及时发送,避免批量排队 |
| 网络传输 | 150 | 改善链路质量和接入区域 |
| 服务端处理 | 100 | 减少转码、转封装及分发等待 |
| 播放缓冲 | 450 | 控制播放器目标缓冲时长 |
| 解码渲染 | 70 | 降低解码排队与显示等待 |
| 机动余量 | 50 | 吸收尚未归因的波动 |
| 合计 | 1000 | 端到端预算上限 |
这个预算适合用于设计和压测,不能直接视为可实现承诺。例如网络抖动持续达到 300 毫秒时,450 毫秒播放缓冲可能仍然不够;缓冲设得越小,发生卡顿的风险越高。
传输方案也会改变预算的主要消耗位置:
- 普通 HLS:采用较长媒体分片并维持多个分片缓冲时,可能产生数秒至数十秒延迟,不适合直接套用上述 1 秒预算。
- 低延迟 HLS:通过部分分片、提前获取和播放器追赶策略减少等待,但实际延迟仍依赖服务器与客户端实现。
- WebRTC:适合追求亚秒级互动体验的场景,但必须结合丢包恢复、抖动缓冲、拥塞控制和设备性能测试,不能保证任何网络环境下都低于 1 秒。
如何测量各阶段耗时
首先选择一个含有明显时间变化的测试画面,例如毫秒计时器和周期性闪烁区域。使用同一台高速摄像机同时拍摄事件源和播放屏幕,可以测量真实可见的端到端延迟,避免仅依赖播放器报告的缓冲值。
随后在链路内部加入时间戳和帧标识:
- 采集端记录帧标识、采集完成时间和编码输入时间。
- 编码器记录该帧编码完成时间;如果存在 B 帧,区分编码顺序与显示顺序。
- 发送端记录该帧全部相关数据写入发送队列的时间,而不是仅记录开始调用发送接口的时间。
- 服务端记录接收完整帧、处理完成及输出时间;区分网络等待与服务端排队。
- 播放端记录帧进入缓冲队列、解码输出和实际提交显示的时间。
- 对相同帧标识计算相邻边界时间差,并汇总至少数百帧的统计结果。
跨设备时间戳必须先解决时钟同步问题。可以使用 NTP 或 PTP 等同步机制,记录同步误差;若时钟不同步,不能直接将服务器时间减去客户端时间当作单向网络延迟。同一进程内部的耗时测量应优先使用单调时钟。
在直播场景中,除了平均值,还应关注 P50、P95、P99 和最大值。例如 500 次观测的 P50 为 900 毫秒、P95 为 1800 毫秒,说明典型体验满足 1 秒附近的目标,但至少约 5% 的观测延迟达到或超过较高水平,不能只用平均值宣布达标。具体百分位的边界取决于统计计算方式。
发现超预算后先改哪里
假设一次测试得到采集 40、编码 70、发送 20、网络 100、服务端 80、播放缓冲 1200、解码渲染 60 毫秒,总计 1570 毫秒,而业务目标是 1000 毫秒,需要减少至少 570 毫秒。
此时可先将播放缓冲目标从约 1200 毫秒逐步调整到 600 毫秒,并重新测量。如果其他阶段不变,总延迟理论上变为 970 毫秒;但只有连续播放不卡顿、音画同步正常且 P95 达标,才算优化有效。
如果出现以下现象,应采用不同处理方式:
- 延迟持续缓慢增长:检查播放器是否不断累积旧帧、是否存在直播追赶策略,以及消费速度是否低于生产速度。
- 延迟突然升高又回落:结合 RTT、丢包率、抖动和重传记录,检查网络短时波动。
- 编码耗时周期性升高:检查设备负载、帧重排、关键帧和编码输出队列;不要简单地把关键帧间隔越短视为越好。
- 服务端耗时明显增大:区分转码计算时间与排队时间,观察并发数、CPU/GPU 使用率和分发队列长度。
- 延迟下降但频繁卡顿:适度恢复缓冲,或先改善链路稳定性与自适应码率策略。
最后使用相同测试画面、编码规格、网络条件和并发规模重复测试,记录优化前后的 P50、P95、卡顿次数与卡顿总时长。对于实时互动直播,还应同时测量音画同步误差,避免只优化视频延迟而破坏观看体验。
真正可用的延迟预算应同时写明目标值、测量边界、统计百分位和卡顿约束。这样才能判断优化是否改善了观众体验,而不仅仅是让某一个计时器上的数字变小。