
编码与格式 / 系统课时
计算 PCM 缓冲区大小与播放时长
计算 PCM 缓冲区大小与播放时长
录音、播放或传输 PCM 音频时,需要准确计算缓冲区能存放多少数据、可以播放多久。本课通过采样率、声道数和采样位数建立计算公式,再用 Python 实际生成音频数据并验证结果,避免缓冲区过小、时长计算错误和声道数据理解偏差。
学习目标
- 根据 PCM 音频参数计算每秒数据量、指定时长的缓冲区大小。
- 根据缓冲区字节数反推播放时长,区分采样点、采样帧与字节。
- 使用 Python 验证计算结果,并识别非对齐缓冲区和格式混淆问题。
建立 PCM 数据量计算公式
PCM(脉冲编码调制)将音频波形离散成一系列采样值。计算未压缩 PCM 数据大小时,需要三个参数:
- 采样率:每个声道每秒采样的次数,单位 Hz,例如 48000 Hz。
- 声道数:同时保存的独立声道数量,例如单声道为 1,立体声为 2。
- 每采样位数:每个声道的一次采样占用的有效存储位数。例如常见的 16-bit PCM 每个采样值占 2 字节。
对于每个采样值都按固定整数个字节存储、没有额外文件头的交错 PCM,计算公式为:
其中, 是每秒字节数, 是采样率, 是声道数, 是每个声道采样值的存储字节数。
指定播放时长 秒所需的数据量为:
反过来,缓冲区能够表示的音频时长为:
这里使用的必须是实际存储位数。例如 24-bit PCM 如果按 3 字节紧凑存储,;如果每个采样值使用 32-bit 容器,,即使只有 24 位有效数据,也应按 4 字节计算。
计算立体声 PCM 的实际大小
假设音频采用 48000 Hz、双声道、16-bit、交错存储格式,并且没有压缩或额外头部。
每个声道的单个采样值占 2 字节,同一采样时刻的左右声道各产生一个采样值,因此每个采样帧占 4 字节。
每秒数据量为:
如果录制 10 秒,所需 PCM 数据大小为 1920000 字节,约为 1.92 MB(十进制),或 1.831 MiB(二进制)。这里不包含 WAV 文件头、容器元数据和其他封装开销。
| 音频格式 | 每秒数据量 | 100 毫秒数据量 | 10 秒数据量 |
|---|---|---|---|
| 48 kHz、单声道、16-bit | 96000 B | 9600 B | 960000 B |
| 48 kHz、双声道、16-bit | 192000 B | 19200 B | 1920000 B |
| 44.1 kHz、双声道、16-bit | 176400 B | 17640 B | 1764000 B |
| 48 kHz、双声道、32-bit | 384000 B | 38400 B | 3840000 B |
最后一行表示每采样值存储 4 字节;它既可能是 32-bit 整数 PCM,也可能是 32-bit 浮点 PCM,具体含义由格式描述决定。
理解采样帧与缓冲区边界
在交错存储的立体声 PCM 中,同一个采样时刻的左声道值和右声道值连续存放,随后才是下一时刻的左右声道值。
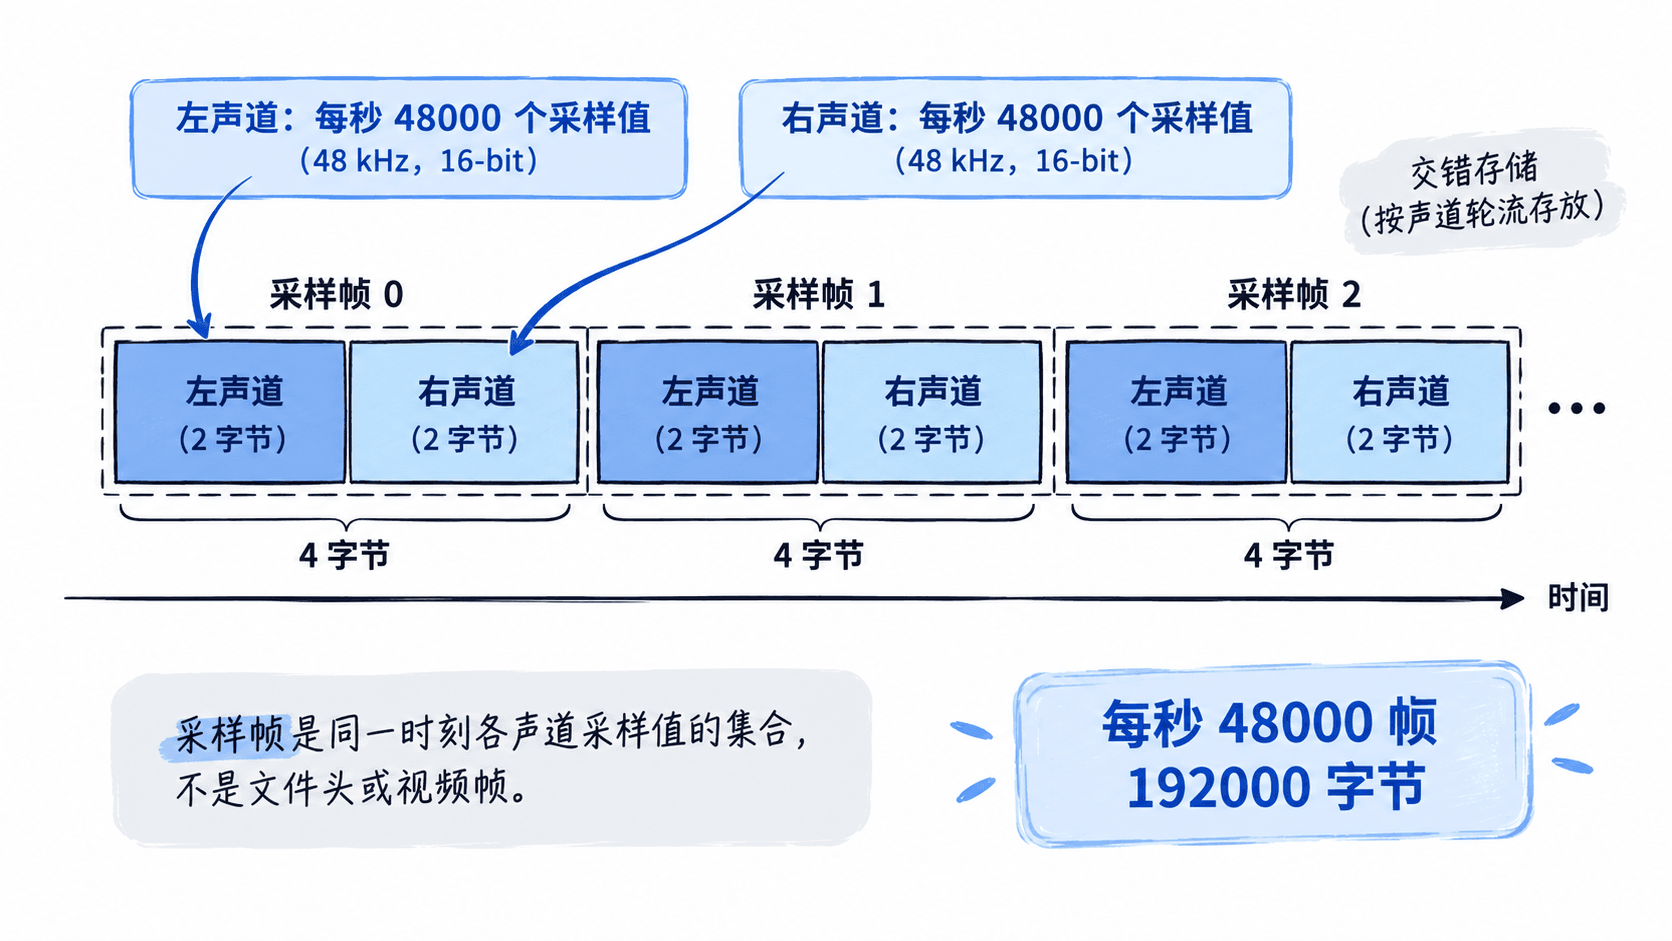
计算缓冲区时要区分三个概念:
- 采样值:一个声道在一个时刻的数值,16-bit PCM 通常占 2 字节。
- 采样帧:同一时刻所有声道的采样值,双声道 16-bit PCM 占 4 字节。
- 缓冲区:连续保存若干采样帧的存储空间,大小通常用字节表示。
对于这种格式,缓冲区字节数最好是 4 的整数倍。19200 字节恰好包含 4800 帧,对应 100 毫秒;19201 字节则多出一个无法组成完整采样帧的字节。
例如播放器请求 4096 字节数据,在 48 kHz 双声道 16-bit 格式下,它包含 1024 帧,播放时长约为 21.33 毫秒,而不是 4096 毫秒。
用 Python 验证缓冲区与时长
下面使用 Python 3.10 或更新版本的标准库生成 100 毫秒静音 PCM,检查生成的字节数,并反推时长。这里的静音采用有符号 16-bit PCM,所有采样值均为零。
sample_rate = 48000
channels = 2
bits_per_sample = 16
duration_ms = 100

# 采用16-bit整数字节对齐存储,每声道采样值占2字节。
bytes_per_sample = bits_per_sample // 8
bytes_per_frame = channels * bytes_per_sample
frame_count = sample_rate * duration_ms // 1000
buffer_size = frame_count * bytes_per_frame

# 每个采样帧由左右两个零值采样组成。
pcm_buffer = bytes(buffer_size)
actual_frames = len(pcm_buffer) // bytes_per_frame
actual_duration_ms = actual_frames * 1000 / sample_rate

print(f"每帧字节数: {bytes_per_frame}")
print(f"采样帧数: {actual_frames}")
print(f"缓冲区大小: {len(pcm_buffer)} 字节")
print(f"播放时长: {actual_duration_ms:.2f} 毫秒")
预期输出:
每帧字节数: 4
采样帧数: 4800
缓冲区大小: 19200 字节
播放时长: 100.00 毫秒
把 duration_ms 改成 20,重新运行,缓冲区应变为 3840 字节,包含 960 个采样帧。该程序只生成原始音频字节,并不向声卡播放;计算得到的是音频数据的标称播放时长,不包括设备排队、系统调度和输出延迟。
需要特别注意:如果目标时长不能表示为整数个采样帧,实际缓冲区必须采用整数帧。示例中的整数除法会向下取整,因此计算所得时长可能略小于请求时长。
为实时播放选择缓冲区大小
实时播放通常根据希望一次处理多少毫秒音频来决定单块缓冲区大小。假设格式为 48 kHz、双声道、16-bit,则不同块时长对应的数据量为:
| 单块时长 | 采样帧数 | 缓冲区大小 |
|---|---|---|
| 10 ms | 480 | 1920 B |
| 20 ms | 960 | 3840 B |
| 40 ms | 1920 | 7680 B |
| 100 ms | 4800 | 19200 B |
如果使用三个 20 ms 的缓冲块,总容量为 11520 字节,能够存放 60 ms 的 PCM 数据。但这不等于实际端到端延迟为 60 ms,因为采集、编码、调度、设备队列等还会引入额外时间。
工程实现时可先选择 20 ms 作为应用层处理块的测试起点,再观察音频设备接口是否要求指定帧数或对齐粒度。播放线程如果经常来不及提供下一块数据,会发生欠载,用户可能听到断音;单纯增大缓冲区虽然可能缓解欠载,但也会增加排队时长。
实际验收可检查三个条件:缓冲区大小能够被每帧字节数整除;反推的时长符合期望;连续播放时没有欠载或明显的额外延迟。
对于固定格式 PCM,只要明确实际每采样存储字节数、声道数与采样率,就可以在字节数和播放时长之间准确换算。遇到大小不符时,优先排查容器头部、24-bit 对齐方式、声道数量和采样帧边界。