
架构与系统设计 / 系统课时
评审拆分决策与演进路线
评审拆分决策与演进路线
这一节把目标架构从“看起来合理”变成可评审、可迁移的决策:用业务内聚、自治程度、一致性成本和迁移风险检查服务边界,并据此安排分阶段演进,避免一次性重写把架构收益变成迁移风险。
学习目标
- 用统一维度评审服务拆分是否值得保留
- 识别高耦合边界中的一致性成本和迁移风险
- 形成可以逐阶段验收和回退的演进路线
用四个维度评审边界
评审服务拆分时,不要只问“服务够不够小”。业务内聚看一个服务内部的规则是否围绕同一业务能力变化;自治程度看它能否独立部署、独立拥有数据并在短暂故障时保持可恢复;一致性成本看跨边界后新增了多少事件、补偿、幂等和状态对账;迁移风险看旧系统是否存在隐蔽共享表、批处理、报表或外部接口依赖。
可以给每个候选边界按 1~5 分打分:业务内聚与自治程度越高越好,一致性成本与迁移风险越低越好。分数不是自动做决定,而是让评审者明确争议来自哪里。
| 评审维度 | 好的信号 | 风险信号 |
|---|---|---|
| 业务内聚 | 规则和变更集中在同一能力 | 同一用例频繁跨多个服务改动 |
| 自治程度 | 独立数据、独立部署、故障可隔离 | 共享库、共享事务、同步链过长 |
| 一致性成本 | 少量可补偿的异步协作 | 强一致跨服务写入很多 |
| 迁移风险 | 依赖清晰、可旁路验证 | 隐式依赖多、无法局部回退 |
把评分变成可重复的评审
下面的 Python 示例把四个维度转换为一个简单评审分数。它不是架构真理,而是让团队在多次评审中使用同一口径:正向指标直接加分,成本与风险反向计分。
def review_score(cohesion, autonomy, consistency_cost, migration_risk):
    positive = cohesion + autonomy
    negative = (6 - consistency_cost) + (6 - migration_risk)
    return positive + negative

score = review_score(
    cohesion=5,
    autonomy=4,
    consistency_cost=3,
    migration_risk=2,
)

print(f"score={score}/20")
print("decision=keep" if score >= 15 else "decision=rework")
预期输出
score=16/20
decision=keep
实际项目可以调整权重和阈值。关键不是 15 本身,而是当评分下降时,评审记录必须指出具体代价,例如“支付与订单仍共享事务”或“库存迁移无法回退”,而不是只写“耦合较高”。
先迁移边界,再迁移实现
演进路线应优先消除结构性耦合,再搬代码。第一阶段先明确数据所有权和接口边界,即使模块仍部署在同一个进程,也禁止新增跨模块直接写表。第二阶段把最独立、收益最高的能力抽成服务,并通过事件或 API 与旧系统协作。第三阶段再处理需要补偿和对账的复杂链路,例如库存预占与支付确认。最后才清理旧表、旧接口和兼容层。
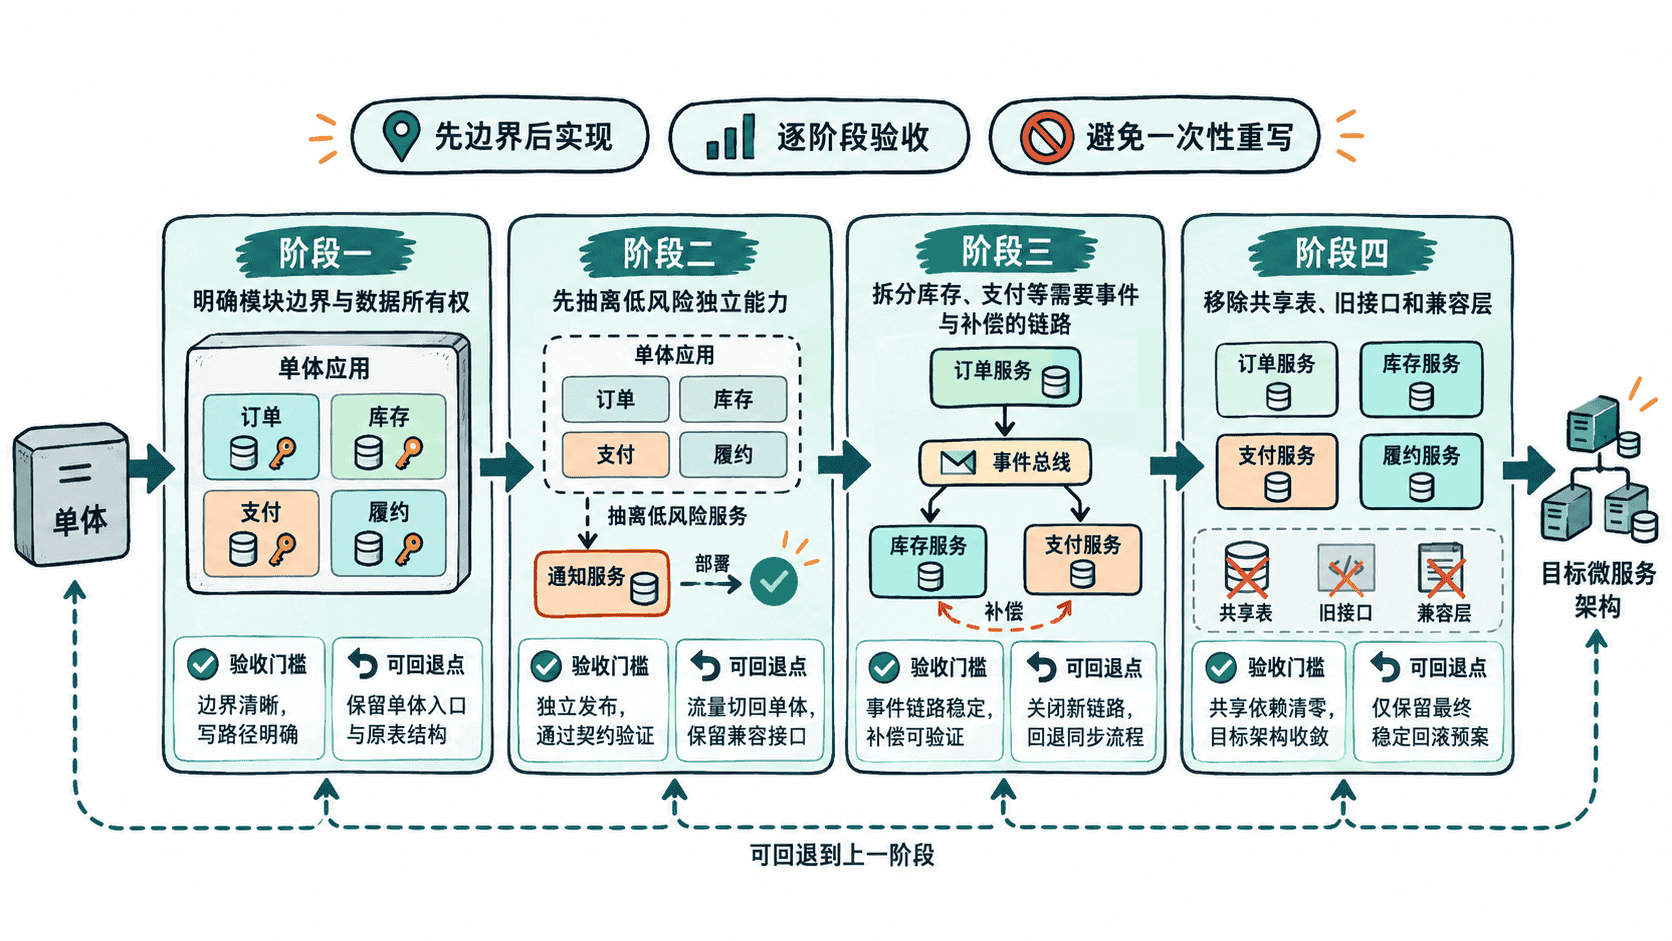
每一阶段都要有可验证的退出条件。例如抽离库存服务后,不是“新服务上线”就算完成,而是旧系统不再直接写库存表、库存失败可以独立恢复、回退时可以把流量切回旧实现且不会丢失预占记录。
控制双写和兼容期
迁移期最危险的是长期双写。为了平滑迁移,可以短期保留旧模型与新模型的并行写入或事件同步,但必须指定主写方、对账方式和结束条件。否则兼容层会从临时措施变成新的永久耦合。
对于读流量,可以先通过旁路构建新读模型并对比结果,再逐步切换;对于写流量,优先使用单主写入加事件复制,只有在确实无法一次切换时才使用受控双写,并为失败重试与对账建立明确机制。
决定什么时候继续拆、什么时候停止
当一个候选服务已经具备清晰业务语言、单一数据所有权和可独立演进的发布节奏,同时跨边界协作成本可控,就应停止继续细拆。反过来,如果一次常规业务变更仍需要同时修改多个服务、共享事务或人工协调发布,说明边界还需要重新评审。
好的演进路线不是最快到达目标图,而是每一步都降低下一步的不确定性。只要每个阶段都有明确边界、验收条件和回退方案,团队就能在持续交付中逐步完成拆分,而不是把全部风险集中到一次“大迁移”。