
架构与系统设计 / 系统课时
区分子域、上下文与服务
区分子域、上下文与服务
子域、限界上下文、模块和微服务经常被画成同一组方框,但它们回答的问题不同。本文用问题空间、模型边界、代码组织和部署单元四个层次拆开这些概念,并通过一个可运行的小例子验证它们不必一一对应。
学习目标
- 区分子域、限界上下文、模块和部署服务各自解决的问题
- 理解业务边界与进程边界为什么不能直接画等号
- 在拆微服务前先建立可讨论、可验证的边界映射
四个概念处在不同层次
子域属于问题空间,表示业务能力的一部分,例如订单履约、计费或库存。它描述“业务要解决什么问题”,不规定代码放在哪个进程里。
限界上下文属于解决方案空间,规定一套模型和语言在哪个边界内有效。同一个“客户”“订单”在不同上下文中可以有不同字段、规则和生命周期,只要边界与转换关系明确。
模块是上下文内部的代码组织手段,用来把相关模型、应用逻辑或基础设施代码聚合起来。模块边界可以帮助维护结构,但通常不等于独立业务语义边界。
部署服务是运行与运维层面的单元,关注独立发布、扩缩容、故障隔离和资源配置。一个服务可以承载多个清晰隔离的上下文;是否继续拆成多个进程,应由独立演进和运行需求决定。
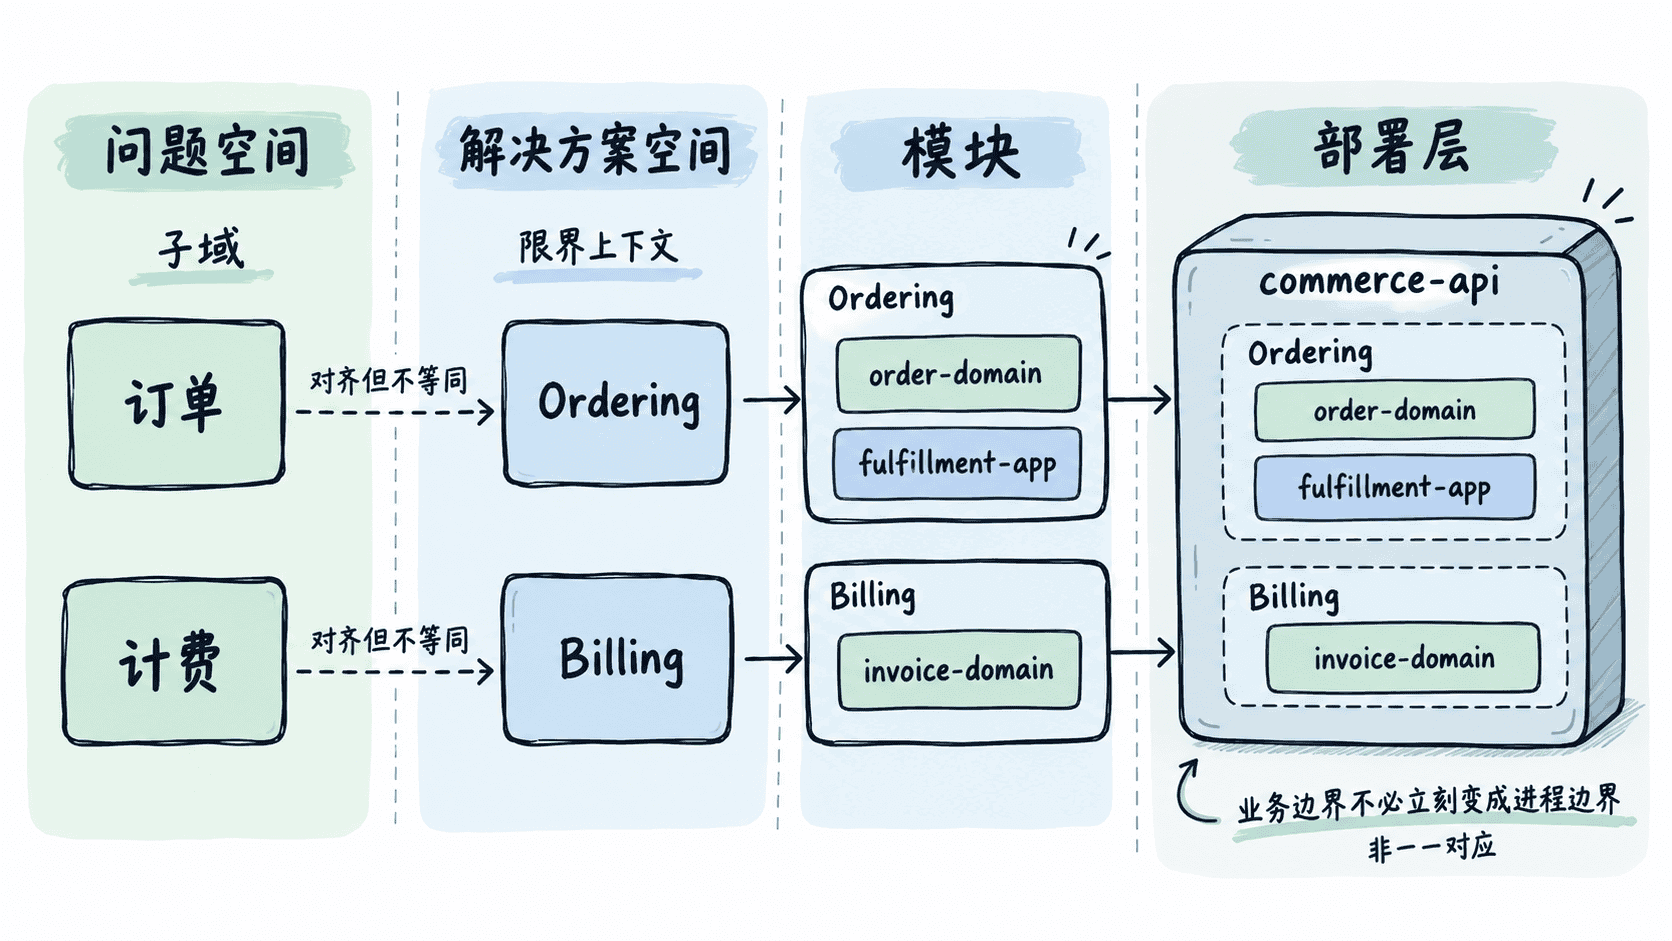
先画模型边界,再决定进程边界
拆分顺序如果反过来,很容易把“一个数据库表”“一个代码包”或“一个团队”直接变成微服务。更稳妥的做法是先确认哪些概念必须共享同一套业务规则,哪些概念虽然名字相同却需要不同模型,再根据发布频率、容量、故障隔离和团队自治决定部署方式。
下面的程序把四层关系显式记录下来,并故意让一个部署服务承载两个限界上下文。它不是 DDD 框架代码,而是用于验证边界映射的最小可运行示例。
subdomains = {"ordering", "billing"}

contexts = {
    "Ordering": {"subdomain": "ordering", "modules": ["order-domain", "fulfillment-app"]},
    "Billing": {"subdomain": "billing", "modules": ["invoice-domain"]},
}

services = {
    # 部署单元可以承载多个上下文,不必与业务边界一一对应。
    "commerce-api": ["Ordering", "Billing"]
}

for context_name, context in contexts.items():
    assert context["subdomain"] in subdomains
    assert context["modules"], f"{context_name} must contain at least one module"

for hosted_contexts in services.values():
    assert all(name in contexts for name in hosted_contexts)

print(f"subdomains={len(subdomains)}")
print(f"bounded_contexts={len(contexts)}")
print(f"deployment_services={len(services)}")
print("context_count_equals_service_count=", len(contexts) == len(services))
预期输出
subdomains=2
bounded_contexts=2
deployment_services=1
context_count_equals_service_count= False
这里的 False 正是关键:模型边界已经分开,但当前仍可部署在同一个进程中。以后如果计费需要独立发布、隔离故障或单独扩容,再把 Billing 移到独立服务,并不会改变它作为限界上下文的语义边界。
用边界问题检查拆分是否过早
准备创建新服务前,可以连续问三个问题:这部分是否拥有独立业务语言和规则;它是否需要独立演进;它是否真的需要独立部署。如果只有最后一个答案模糊,先保留清晰的上下文和模块边界,通常比提前增加网络调用、分布式事务和运维负担更稳妥。
子域帮助你理解业务问题,限界上下文约束模型语义,模块组织上下文内部代码,服务承载运行时部署。把这四层分开,才能让微服务拆分成为业务边界之后的工程决策,而不是边界本身。