
架构与系统设计 / 系统课时
决定一个上下文拆几个服务
决定一个上下文拆几个服务
一个限界上下文不等于天然只对应一个服务。本篇给出一套可执行的判断顺序:先确认业务能力是否能独立,再结合团队、性能和发布节奏决定继续拆分还是保持单服务,避免为了“微服务化”制造新的耦合。
学习目标
- 用业务内聚、团队规模、性能特征和发布节奏判断是否需要继续拆分。
- 区分真正的自治边界与仅仅“代码很多”“表很多”这类伪信号。
- 用一个最小决策记录把拆分理由和保留理由留给后续评审。
先找业务上的独立性
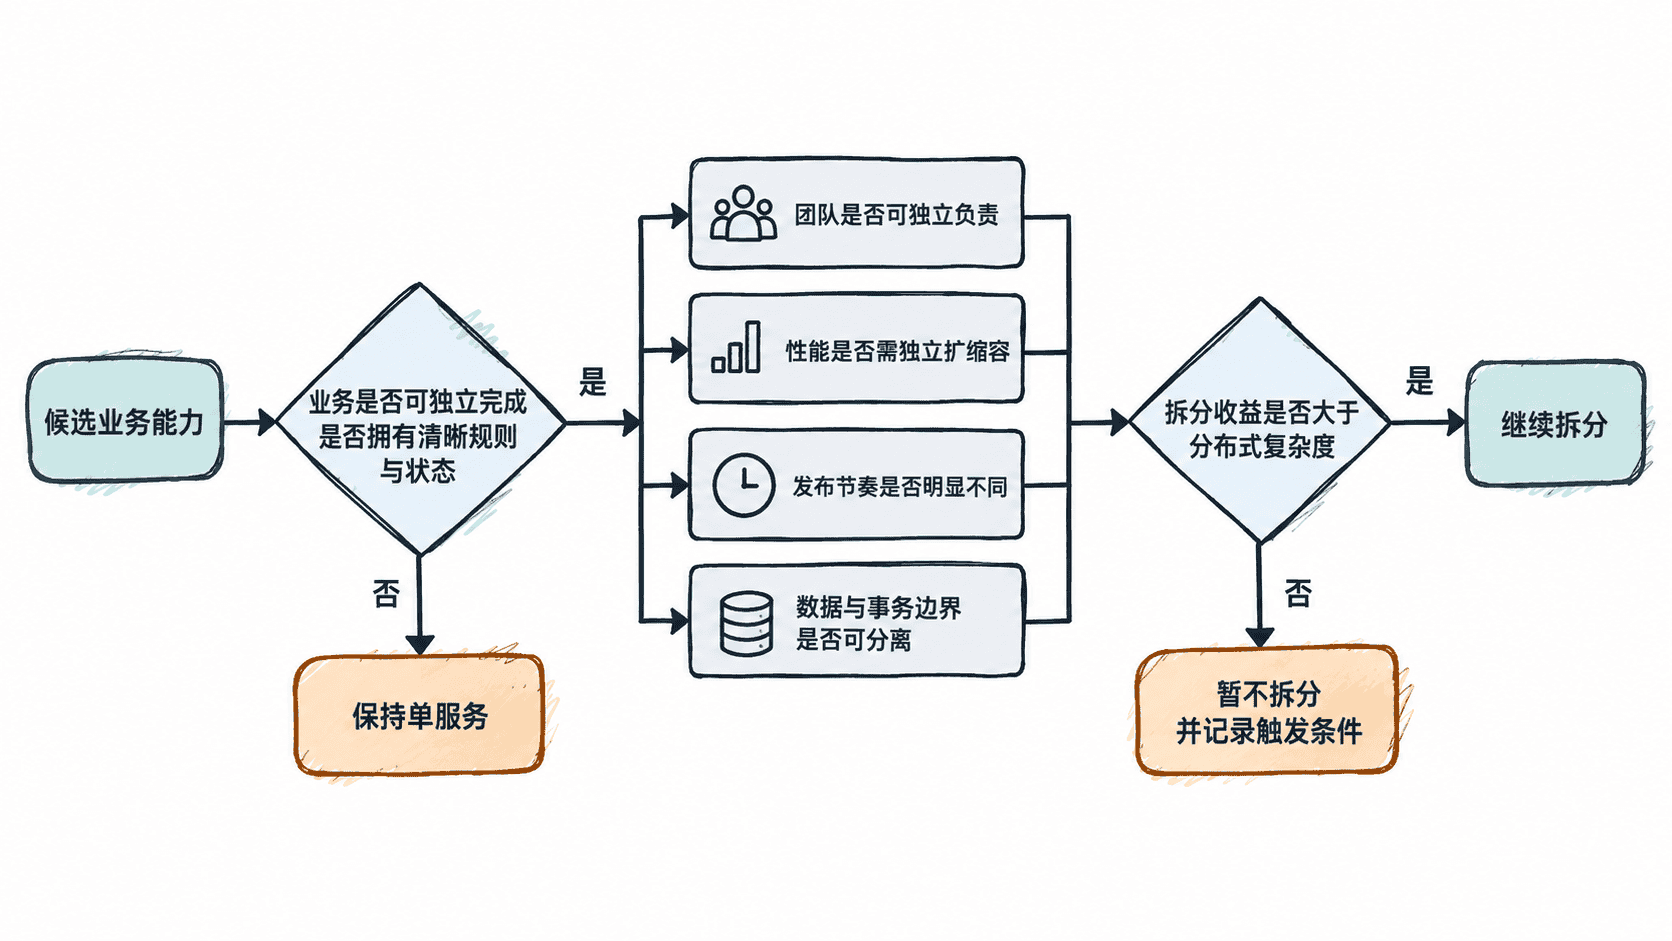
判断能不能拆,先问“拆出来的部分是否能独立完成一项业务责任”,而不是先看类数量或表数量。候选服务最好有自己的业务术语、规则和状态变化,并且大多数操作不需要与上下文中的另一部分同步锁步。
例如“订单履约”和“价格计算”都在交易上下文中,但如果价格计算有独立规则、独立变更节奏,并能通过明确输入输出工作,它就是合理候选。相反,如果两个模块几乎每次请求都要互相调用、共同提交同一事务,拆开通常只会把进程内耦合变成网络耦合。
再看四个拆分驱动力
业务独立性是前提,其余四个维度决定“现在是否值得拆”。
- 业务内聚:拆出后是否形成完整能力,而不是只得到 CRUD 薄层。
- 团队规模:是否存在两个能够长期独立负责的团队;如果仍由同一小团队维护,拆分收益往往有限。
- 性能特征:某部分是否有明显不同的吞吐、延迟、计算或资源需求,需要独立扩缩容。
- 发布节奏:某部分是否频繁变更,而另一部分要求高稳定,独立发布能否显著降低互相等待。
用最小脚本做一次结构化评审
下面的脚本不是“自动替你做架构决定”,而是把讨论中的四个驱动力显式化。只有业务独立性成立,并且至少出现两个强驱动力时,脚本才建议进入拆分设计。
python
from dataclasses import dataclass

@dataclass
class SplitReview:
    business_independent: bool
    team_independent: bool
    scaling_independent: bool
    release_independent: bool
    data_transaction_separable: bool

def recommend(review: SplitReview) -> str:
    if not review.business_independent:
        return "保持单服务:业务责任还没有形成独立边界"

    drivers = sum([
        review.team_independent,
        review.scaling_independent,
        review.release_independent,
        review.data_transaction_separable,
    ])
    if drivers >= 2:
        return "进入拆分设计:验证接口、数据所有权和失败边界"
    return "暂不拆分:记录触发条件,继续保持模块化单服务"

review = SplitReview(
    business_independent=True,
    team_independent=False,
    scaling_independent=True,
    release_independent=True,
    data_transaction_separable=True,
)

print(recommend(review))
预期输出:
text
进入拆分设计:验证接口、数据所有权和失败边界这段脚本只用于让评审条件可见,不应用“得分”覆盖业务判断。实际项目中还要继续验证同步事务是否能消除、跨服务调用是否稳定,以及拆分后的故障处理成本是否可接受。
识别不该拆的信号
“代码仓库太大”“某张表很大”“想让服务数量更像微服务”都不是充分理由。更值得保留单服务的情况包括:核心流程必须强事务提交、两个模块总是同步发布、团队无法形成长期所有权,或拆分后大部分请求都会跨服务往返。
最稳妥的结论不是“上下文必须一服务”或“一个上下文应多服务”,而是先守住业务边界,再让组织、性能和发布需求证明拆分价值。证据不足时保持模块化单服务,并记录将来触发拆分的条件,通常比提前分布式化更安全。
按自己的节奏,确认真正理解。