
架构与系统设计 / 系统课时
从调用链发现边界问题
从调用链发现边界问题
纸面上的服务划分可能很整齐,运行时却出现高频同步调用、长链路和级联失败。本篇用调用链数据观察真实协作成本,并据此判断哪些边界需要合并、改成异步,或重新分配职责。
学习目标
- 从调用频率、同步链长度和失败传播识别运行时耦合
- 区分“正常协作”和“边界切得过细”两类调用关系
- 用可重复的指标验证边界调整是否真的降低耦合
先看三类运行时信号
单次跨服务调用并不等于边界错误。需要把三个信号放在一起看:频率说明两个服务是否几乎总是一起工作,同步深度说明一次业务请求要穿过多少边界,失败传播说明下游异常是否会快速放大成上游不可用。
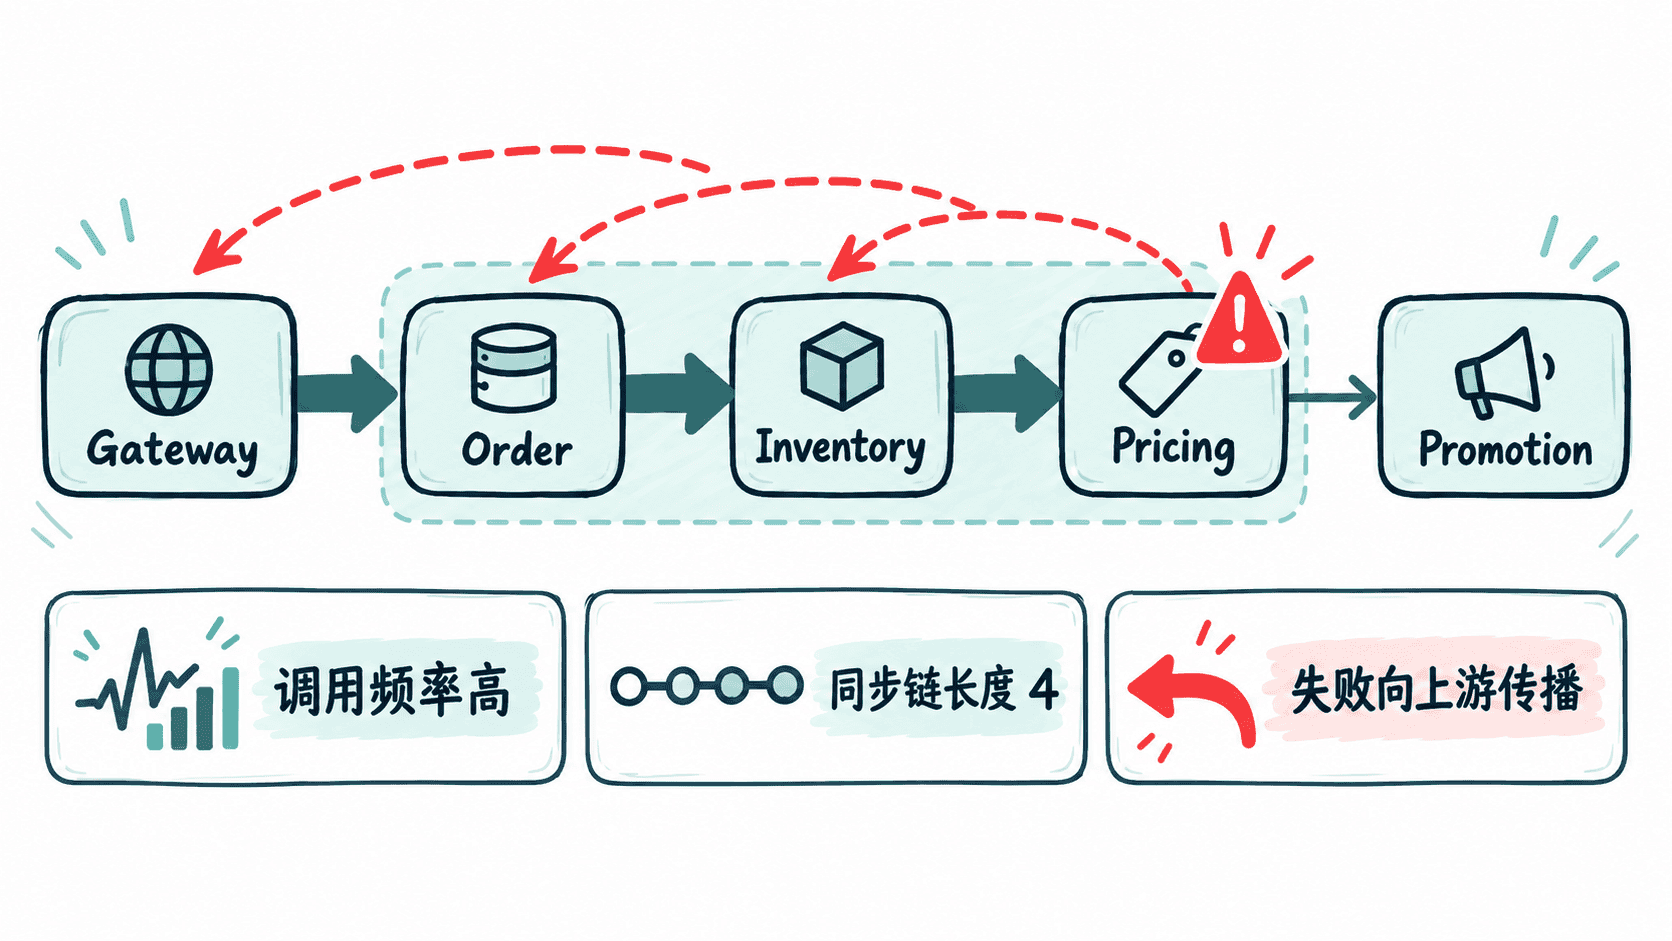
一个常见反模式是“请求必须依次穿过四五个服务才能完成”,并且其中若干服务只是取一个字段或做一次轻量判断。这通常意味着能力被拆得太碎,或者某个服务持有了别人的业务决策所必需的数据。
用调用链数据做最小量化
真实环境可以从 OpenTelemetry、APM 或网关日志导出 trace。下面的 Python 示例使用一组简化后的调用链,计算边调用次数、失败次数和最大同步深度;把 traces 替换为生产采样数据后,分析方法保持不变。
from collections import Counter

traces = [
    (["gateway", "order", "inventory", "pricing"], "ok"),
    (["gateway", "order", "inventory", "pricing"], "error"),
    (["gateway", "order", "inventory", "pricing"], "ok"),
    (["gateway", "order", "inventory"], "ok"),
]

edge_calls = Counter()
edge_failures = Counter()
max_depth = 0

for services, status in traces:
    max_depth = max(max_depth, len(services))
    for left, right in zip(services, services[1:]):
        edge = f"{left}->{right}"
        edge_calls[edge] += 1
        if status == "error":
            edge_failures[edge] += 1

for edge, count in edge_calls.most_common():
    print(f"{edge} calls={count} failures={edge_failures[edge]}")
print(f"max_sync_depth={max_depth}")
预期输出:
gateway->order calls=4 failures=1
order->inventory calls=4 failures=1
inventory->pricing calls=3 failures=1
max_sync_depth=4
这个结果不能直接证明 inventory 与 pricing 必须合并,但它给出了调查优先级:order->inventory 几乎出现在每条请求里,inventory->pricing 又把主链继续拉长,而且一次 pricing 失败会沿整条同步链向上返回。
从指标回到业务边界
发现高耦合链路后,先问业务问题,而不是立刻改通信协议。若两个服务总在同一个业务动作中同步出现、共享同一组一致性要求,并且独立发布很少带来收益,边界可能过细,合并上下文或聚合职责通常更直接。
若双方职责确实独立,但上游只是为了等待一个“后续结果”,可以考虑领域事件、消息队列或异步工作流,把同步依赖改成时间上的解耦。若问题来自频繁读取对方稳定数据,则可评估本地投影、缓存或事件驱动复制,减少在线远程查询。
识别失败传播而不是只看延迟
边界问题经常在故障时才暴露。某个下游超时后,如果上游线程持续等待、自动重试再放大流量,最终会把局部故障扩散成整条链路不可用。此时要同时检查超时预算、重试层级、熔断策略和是否真的需要同步响应。
用调整前后数据验证拆分质量
边界调整完成后,至少比较同一业务入口的三个量:跨服务调用次数是否下降、关键请求的最大同步深度是否缩短、单个下游失败是否仍会导致整条链路失败。只看平均延迟可能掩盖新的重试或异步积压问题。
如果一次边界调整让主流程从四跳变成两跳、关键服务不再被每次请求同步调用,并且局部失败能被限制在本地,那么这次拆分才真正降低了运行时耦合,而不只是把架构图画得更漂亮。