
架构与系统设计 / 系统课时
修正服务粒度失衡问题
修正服务粒度失衡问题
微服务拆得过大、过小或过热,都会把复杂度转移到协作和运行阶段。本篇针对万能服务、纳米服务和热点服务,用职责、数据所有权与调用关系重新评估粒度,并给出合并、重新拆分或仅调整交互方式的判断路径。
学习目标
- 能识别万能服务、纳米服务和热点服务的典型信号
- 能用职责、数据与调用关系判断粒度失衡的根因
- 能选择合并边界、重新拆分或优化交互,并定义调整后的验收标准
先识别三种失衡信号
万能服务往往承载多个变化原因,代码仓库大、团队多、发版冲突频繁;纳米服务则只有很薄的一层逻辑,没有独立数据和独立演化价值,却增加一次网络跳转和一套运维对象;热点服务表现为大量入站调用、频繁发布和资源压力,但它不一定真的应该拆。
这三类问题不能只看代码行数。一个代码量很小但拥有独立规则和数据的服务可能粒度正好;一个代码量很大的服务如果围绕同一核心模型和一致性边界演进,也未必需要拆分。
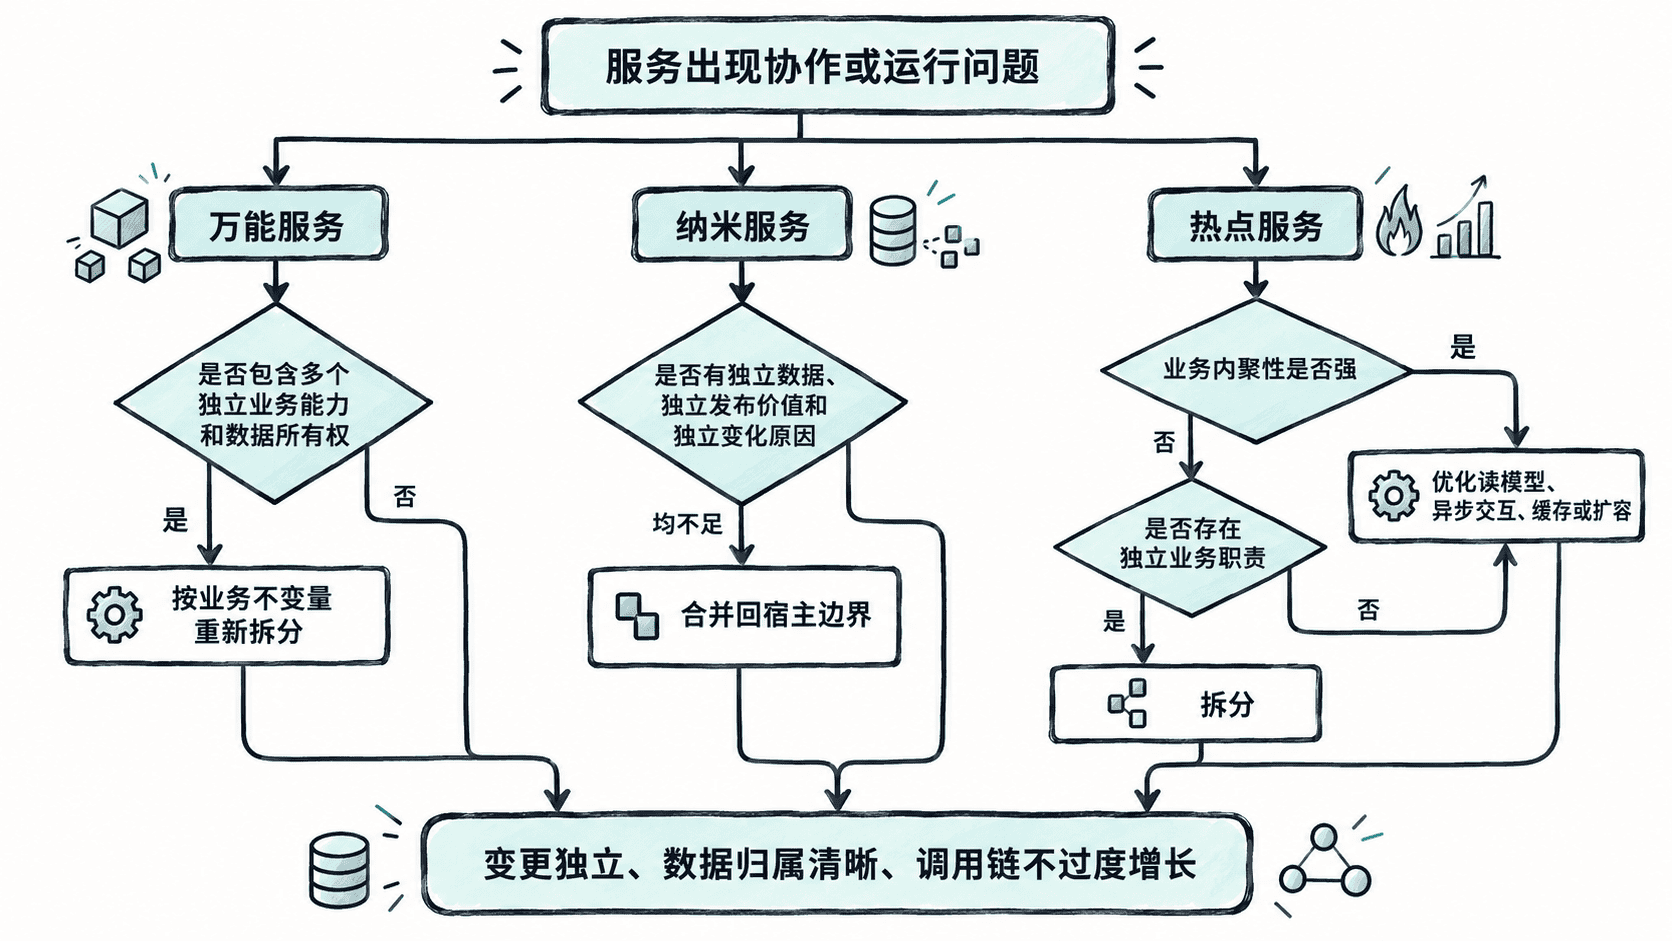
用职责、数据和调用三条线判断
先看职责:一个服务是否存在多个互不相关的变化原因,例如促销规则、履约编排、账单结算都集中在同一边界。若答案是“是”,万能服务信号成立,但拆分仍应围绕业务能力,而不是按 Controller、Repository 或表名分层切开。
再看数据:一个纳米服务如果没有自己拥有的数据,只是读取另一个服务的数据再做一层转发,通常缺乏独立边界的基础。反过来,若它拥有明确的数据生命周期和业务规则,即使代码量小,也可能值得保持独立。
最后看调用:热点服务的高流量可能来自“职责太多”,也可能只是因为它位于关键读路径。前者适合重新拆分,后者更可能通过缓存、异步事件、读模型或水平扩展解决。
用一个评分脚本建立讨论起点
指标只能帮助筛选候选对象,不能替代领域判断。下面的完整 Python 示例用简化规则标出三类服务,便于评审时先找到需要重点讨论的对象:
services = [
    {
        "name": "order-core",
        "capabilities": 7,
        "owned_tables": 12,
        "sync_calls_in": 18,
        "release_per_week": 9,
        "team_count": 3,
    },
    {
        "name": "coupon-validator",
        "capabilities": 1,
        "owned_tables": 0,
        "sync_calls_in": 2,
        "release_per_week": 1,
        "team_count": 1,
    },
    {
        "name": "inventory",
        "capabilities": 2,
        "owned_tables": 5,
        "sync_calls_in": 27,
        "release_per_week": 14,
        "team_count": 1,
    },
]

def classify(service):
    if service["capabilities"] >= 6 and service["team_count"] >= 2:
        return "万能服务候选"
    if (
        service["capabilities"] == 1
        and service["owned_tables"] == 0
        and service["sync_calls_in"] <= 3
    ):
        return "纳米服务候选"
    if service["sync_calls_in"] >= 20 and service["release_per_week"] >= 10:
        return "热点服务候选"
    return "暂不调整"

for service in services:
    print(f'{service["name"]}: {classify(service)}')
预期输出:
order-core: 万能服务候选
coupon-validator: 纳米服务候选
inventory: 热点服务候选
这些阈值只是演示用的筛选规则。落到真实系统时,应根据团队规模、发布节奏和调用基线重新定义指标,否则很容易把正常的核心服务误判成“过大”或“过热”。
选择合并、拆分还是改调用关系
万能服务如果包含多个独立业务能力,而且这些能力有不同的数据所有权和变化节奏,应按业务不变量重新拆分。不要为了降低代码量而机械切成多个 CRUD 服务,否则只会把进程内调用换成网络调用。
纳米服务如果没有独立数据、独立规则和独立发布价值,通常应合并回最相关的宿主边界。合并后要删除多余的同步接口和跨服务事务,而不是保留原有远程模型只把代码搬到一个仓库。
热点服务先判断“热”是不是职责过多造成的。如果它业务内聚很强,只是读取压力高,优先优化缓存、读模型、异步订阅或扩容;只有当热点内部存在可以独立演化的业务职责时,拆分才真正降低耦合。
用运行结果验收新粒度
调整完成后,不要只看服务数量是否变少或变多。更有价值的验收指标包括:一次业务变化是否更集中、服务能否独立发布、数据所有权是否更明确、同步调用链是否缩短,以及故障是否被限制在更小的业务范围。
如果拆分后每次需求仍要同时修改多个服务,或合并后团队发布冲突反而上升,说明新的粒度仍没有贴合真实变化方向。服务粒度的目标不是“越小越好”,而是让业务变化、数据一致性和团队协作尽量落在同一个可独立演化的边界内。