
架构与系统设计 / 系统课时
逐步拆开共享数据库
逐步拆开共享数据库
共享数据库不能靠一次搬表安全拆除。更稳妥的做法是先确定每类数据的唯一所有者,再逐步收口写入、迁移读取和回填历史数据,经过对账后切断跨服务直连,从而在不中断业务的情况下建立真正的数据边界。
学习目标
- 根据业务职责确定表和字段的数据所有者
- 设计写路径收口、双读校验与历史数据回填的迁移顺序
- 在切换完成后验证并禁止跨服务直接访问数据库
先确定数据所有者
拆共享库的第一步不是创建新数据库,而是回答“谁有权修改这份数据”。所有者应由业务不变量决定,而不是由当前哪段代码写表决定。例如客户基本资料可以归客户服务,账户余额归账务服务,订单履约状态归订单服务。
一份数据只能有一个权威写入方。其他服务需要它时,通过服务接口、领域事件或经过授权的数据副本获取,而不是继续执行跨服务 UPDATE。如果两个服务都能直接改同一行,就还没有建立真正的所有权。
| 数据 | 权威所有者 | 其他服务的访问方式 |
|---|---|---|
| 客户资料 | 客户服务 | API 或客户变更事件 |
| 账户余额 | 账务服务 | 查询 API 或只读投影 |
| 订单履约状态 | 订单服务 | API 或订单状态事件 |
按阶段迁移读写路径
数据库拆分最重要的顺序是先收口写,再迁移读,最后撤销旧访问。写路径决定真实数据由谁负责;如果在写入仍然分散时就搬读取,很容易出现新旧数据长期漂移。
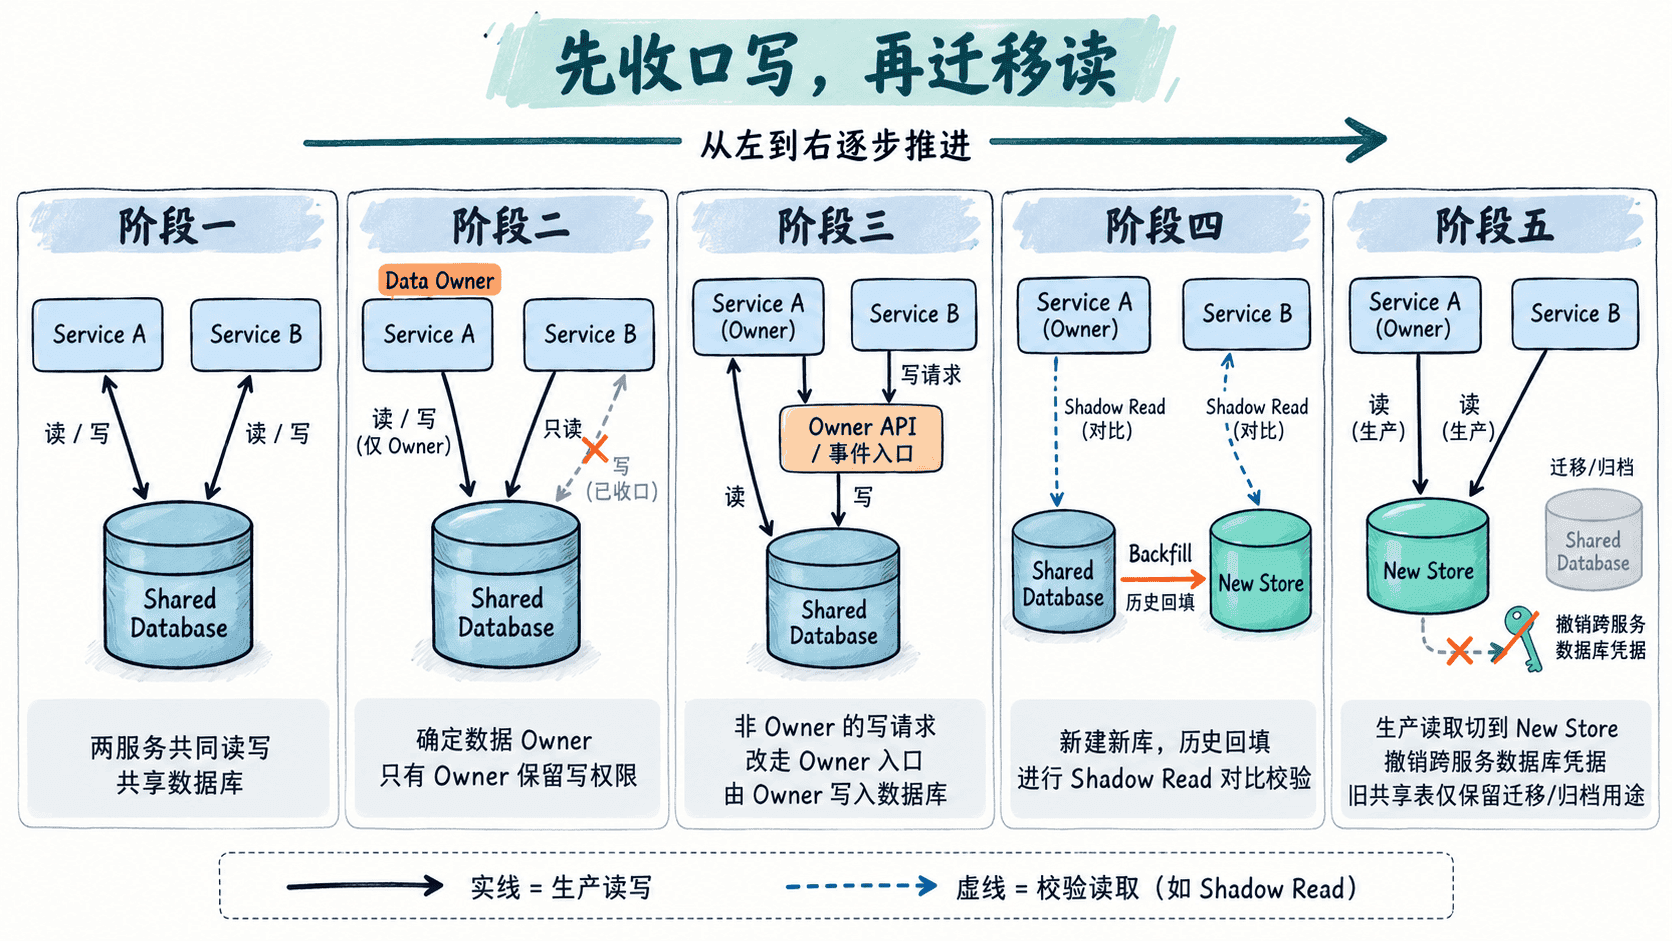
实际迁移可以按以下顺序执行:先禁止新增跨服务写入,让所有修改都经过数据所有者;随后建立新存储并持续同步增量;再做历史数据回填和影子读取对账;确认差异消失后切换生产读取;最后撤销其他服务的数据库账号、权限和旧 SQL。
只读副本可以作为过渡手段,但它不是最终边界。只要其他服务仍依赖所有者的物理表结构,表字段调整就仍会变成跨团队兼容性问题。
用幂等回填迁移历史数据
历史数据搬迁应支持重复执行。这样即使一次任务中断,也可以从检查点重新运行,而不必人工判断哪些记录已经写入。下面用 PostgreSQL 模拟从遗留余额表回填到账务服务拥有的新表;示例在实验数据库中创建临时表,不会修改持久业务表。
CREATE TEMP TABLE legacy_customer_balance (
    customer_id VARCHAR(20) PRIMARY KEY,
    balance NUMERIC(12, 2) NOT NULL,
    updated_at TIMESTAMP NOT NULL
);

CREATE TEMP TABLE billing_customer_balance (
    customer_id VARCHAR(20) PRIMARY KEY,
    balance NUMERIC(12, 2) NOT NULL,
    source_updated_at TIMESTAMP NOT NULL
);

-- 模拟共享库中已经存在的历史数据。
INSERT INTO legacy_customer_balance VALUES
('C-1001', 125.50, TIMESTAMP '2026-09-01 10:00:00'),
('C-1002', 80.00, TIMESTAMP '2026-09-01 10:05:00');

-- 使用 upsert 保证回填任务可以安全重复执行。
INSERT INTO billing_customer_balance AS target
SELECT customer_id, balance, updated_at
FROM legacy_customer_balance
ON CONFLICT (customer_id) DO UPDATE
SET balance = EXCLUDED.balance,
    source_updated_at = EXCLUDED.source_updated_at
WHERE target.source_updated_at <= EXCLUDED.source_updated_at;

SELECT customer_id, balance
FROM billing_customer_balance
ORDER BY customer_id;
预期结果(最后一条 SELECT)
 customer_id | balance
-------------+---------
 C-1001      |  125.50
 C-1002      |   80.00
这里用主键解决重复插入,用源数据更新时间避免较旧记录覆盖较新结果。真实迁移还需要记录批次进度,并对总行数、关键金额汇总和抽样业务记录进行核对,而不能只以“脚本执行成功”作为验收标准。
控制双读和双写的风险
双读适合做切换前校验:生产请求仍读取旧数据,同时异步或旁路读取新存储,对比关键字段并记录差异。等差异稳定为零或进入允许阈值后,再把生产读取切过去。这样回滚读取路径通常只需要修改路由,而不需要反向搬一次数据。
应用层同时向两个数据库直接写入则风险更高。两个独立数据库无法天然共享本地事务,一个写成功、另一个失败就会产生分叉。更可靠的做法是让数据所有者只提交一次权威写入,再通过事务性 Outbox、CDC 或可靠事件把变化传播到迁移目标和只读投影。
切断最后的数据库耦合
读取切换成功后,还要主动删除旧依赖,否则临时路径很容易变成永久路径。撤销非所有者的表级写权限和数据库凭据,删除跨服务 SQL,在监控中检查是否还有旧账号连接,并把需要共享的数据改由 API、事件或服务拥有的只读投影提供。
最终验收标准不是“表已经搬到另一台数据库”,而是每份业务数据都有唯一所有者,其他服务不能绕过公开契约直接修改它,同时新存储能够独立演进。达到这一点,共享数据库造成的部署和模型耦合才真正被解除。