
架构与系统设计 / 系统课时
搭建订单履约案例基线
搭建订单履约案例基线
后续做事件风暴和微服务拆分前,必须先让所有人讨论同一条业务链。本篇建立一个最小订单履约基线:从商品信息进入下单,到支付、库存和配送完成,同时标出现有系统边界与关键失败点,供后续拆分复用。
学习目标
- 画出商品、下单、支付、库存和配送之间的最小端到端流程。
- 区分业务流程边界与当前系统边界,避免直接按系统拆服务。
- 形成一份可复查的案例基线,为后续事件风暴提供统一输入。
先固定案例范围
这份基线的目的不是设计最终架构,而是冻结一个所有人都能重复讲清楚的业务场景。范围从“用户基于商品信息确认下单”开始,到“配送完成”结束;退款、售后、促销等支线暂不展开,避免案例在拆分前就失去焦点。
同时要记录两类边界。第一类是业务阶段,例如下单、支付、库存和配送;第二类是现有系统边界,例如这些能力今天分别落在哪些系统。两者可以重合,也可能完全不同,后续拆分不能默认二者等价。
串起最小端到端主流程
先只保留成功主线,再补最关键的失败点。一个可用于后续讨论的最小流程可以这样描述:
- 商品信息可被查询,并提供下单所需的商品标识与价格依据。
- 下单创建订单,记录购买项和应付金额。
- 支付成功后,订单获得可继续履约的支付事实。
- 库存为订单预留或扣减可售数量;库存不足时流程不能继续。
- 配送接收可履约订单并创建配送任务,最终完成交付。
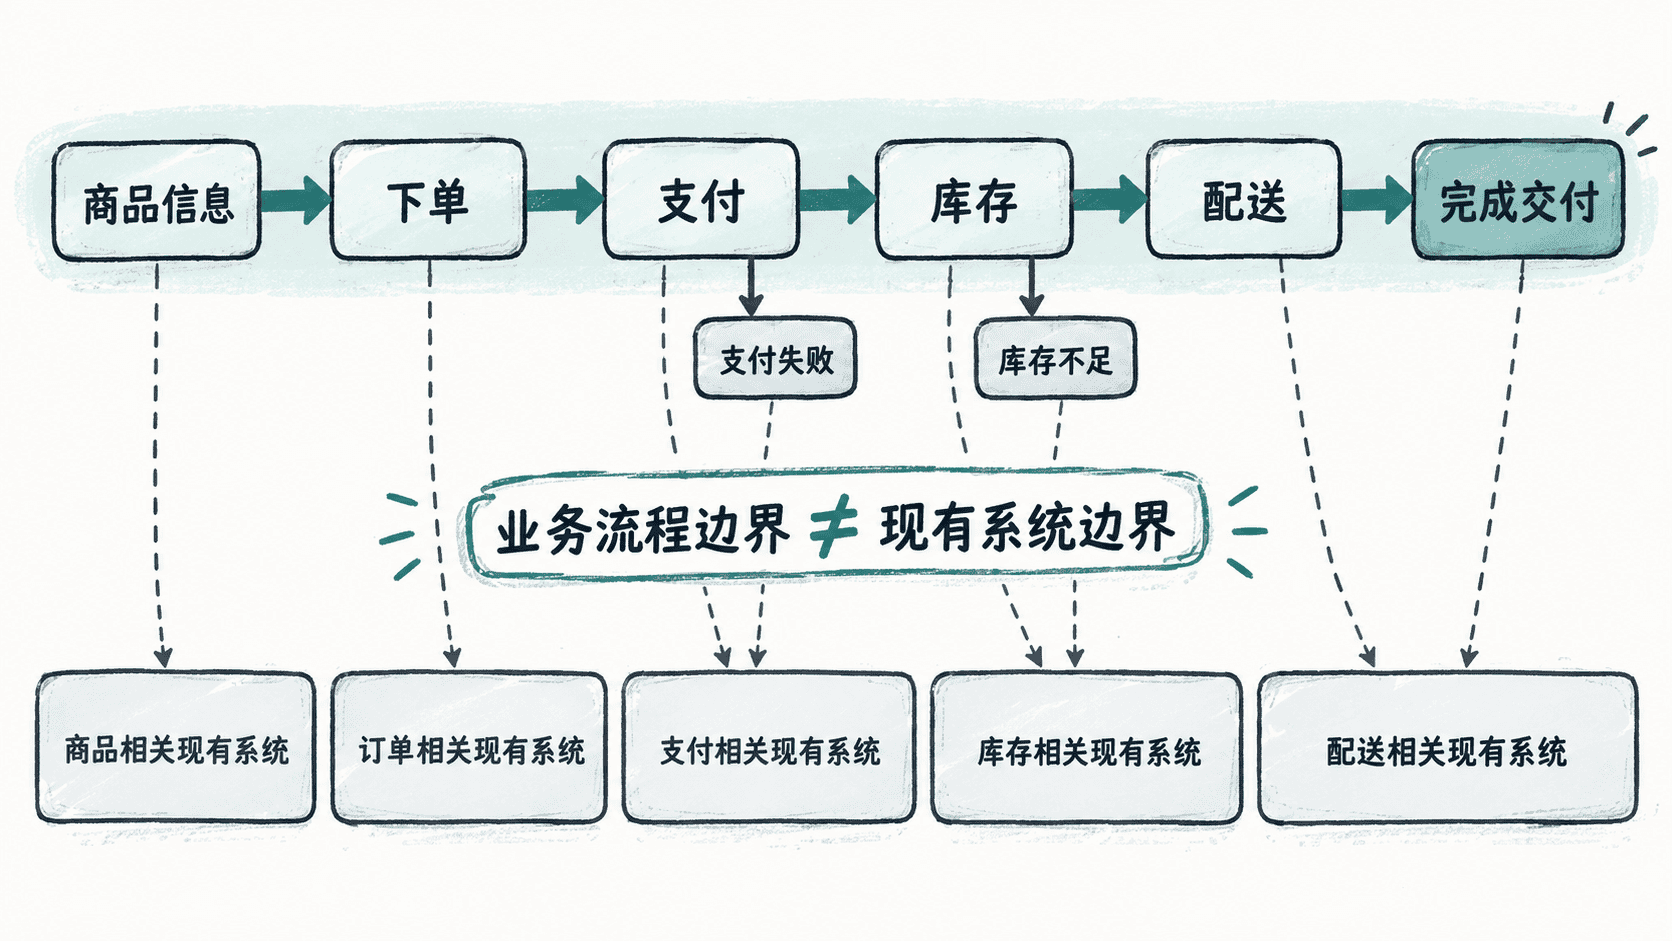
这里的先后顺序只是本案例的基线,不代表所有企业都必须“支付后再处理库存”。如果团队现状是先锁库存再支付,应直接修改基线并记录原因;关键是后续所有讨论都引用同一个版本。
把业务事实写成可评审记录
除了图,还应留下一份机器可读或至少结构稳定的基线记录,避免不同会议各自维护一套口头版本。下面是数据结构示例,不执行程序;可以保存为 order-fulfillment-baseline.yaml,字段和值应按实际业务评审结果调整。
case: order-fulfillment
scope:
  start: 商品信息进入下单
  end: 配送完成

stages:
  - 下单
  - 支付
  - 库存
  - 配送

businessFacts:
  - 订单已创建
  - 支付已成功
  - 库存已预留
  - 配送任务已创建
  - 配送已完成

criticalFailures:
  - 支付失败
  - 库存不足
这份数据结构的生效方式不是驱动运行时,而是作为评审基线:图、业务叙述和结构化记录必须描述同一条链路。验证时逐项核对每个阶段是否有明确输入、产生的业务事实和失败后果;任何人无法唯一解释的字段,都应回到统一语言讨论,而不是先猜服务归属。
不要把当前系统直接当成领域边界
现有系统往往由历史项目、组织分工或采购方案塑造,不能直接证明业务边界。例如一个“订单系统”可能同时包含下单、支付状态和配送信息;反过来,库存能力也可能分散在多个应用中。若直接按这些系统一比一拆微服务,只是把旧边界换成更多部署单元。
更有价值的做法是把现状系统当作约束层:先标出“今天谁保存数据、谁发起调用、谁承担故障”,再在后续事件风暴里观察哪些业务事实总是一起变化、哪些规则由同一类专家维护。新的服务边界应由业务一致性和变化原因决定,而不是由当前数据库或应用名称决定。
用基线验收后续讨论输入
进入事件风暴或服务拆分前,基线至少应满足四个条件:
- 主流程的起点和终点明确,团队能按同一顺序复述。
- 支付失败、库存不足等关键失败点已经标出,不只描述理想路径。
- 当前系统边界已记录,但没有被提前当作目标服务边界。
- 每个关键业务事实都使用稳定术语,不需要额外口头翻译。
满足这些条件后,案例就足够稳定:后续出现的领域事件、聚合或候选服务都可以回到同一条履约链验证,而不会因为参与者讨论的是不同版本的“订单流程”而得到伪差异。