
架构与系统设计 / 系统课时
按数据所有权切分服务
按数据所有权切分服务
服务边界一旦落到数据层,最重要的规则是:一类业务事实只能有一个权威写入方。本篇从事实源、写路径和数据库权限三个层面建立数据所有权,避免两个服务共同修改同一张表,导致事务、发布和故障恢复重新绑在一起。
学习目标
- 为核心业务数据指定唯一事实来源和唯一写入服务。
- 把跨服务修改改造成命令、API 或事件驱动的协作,而不是共享表写入。
- 用数据库权限验证“其他服务可读但不可直接写”的边界是否真实存在。
先给每类事实指定唯一主人
数据所有权不是“哪支团队最常查这张表”,而是“谁有权定义并修改这类业务事实”。例如订单服务拥有订单状态,支付服务拥有支付流水;支付成功后,支付服务不能直接更新订单表,而应把“支付已确认”传给订单服务,由订单服务决定订单状态如何变化。
同一个服务可以拥有多张表,但同一张核心业务表不应被多个服务共同写入。报表、搜索索引和缓存可以复制数据,但它们是派生视图,不应反过来成为交易事实的写入口。
让跨服务修改经过业务接口
当服务 B 想改变服务 A 拥有的数据时,正确路径是把“想做什么”交给 A,而不是绕过 A 直接写库。同步场景可以调用业务 API,异步场景可以发送命令或消费领域事件;最终写入仍由数据拥有者完成。
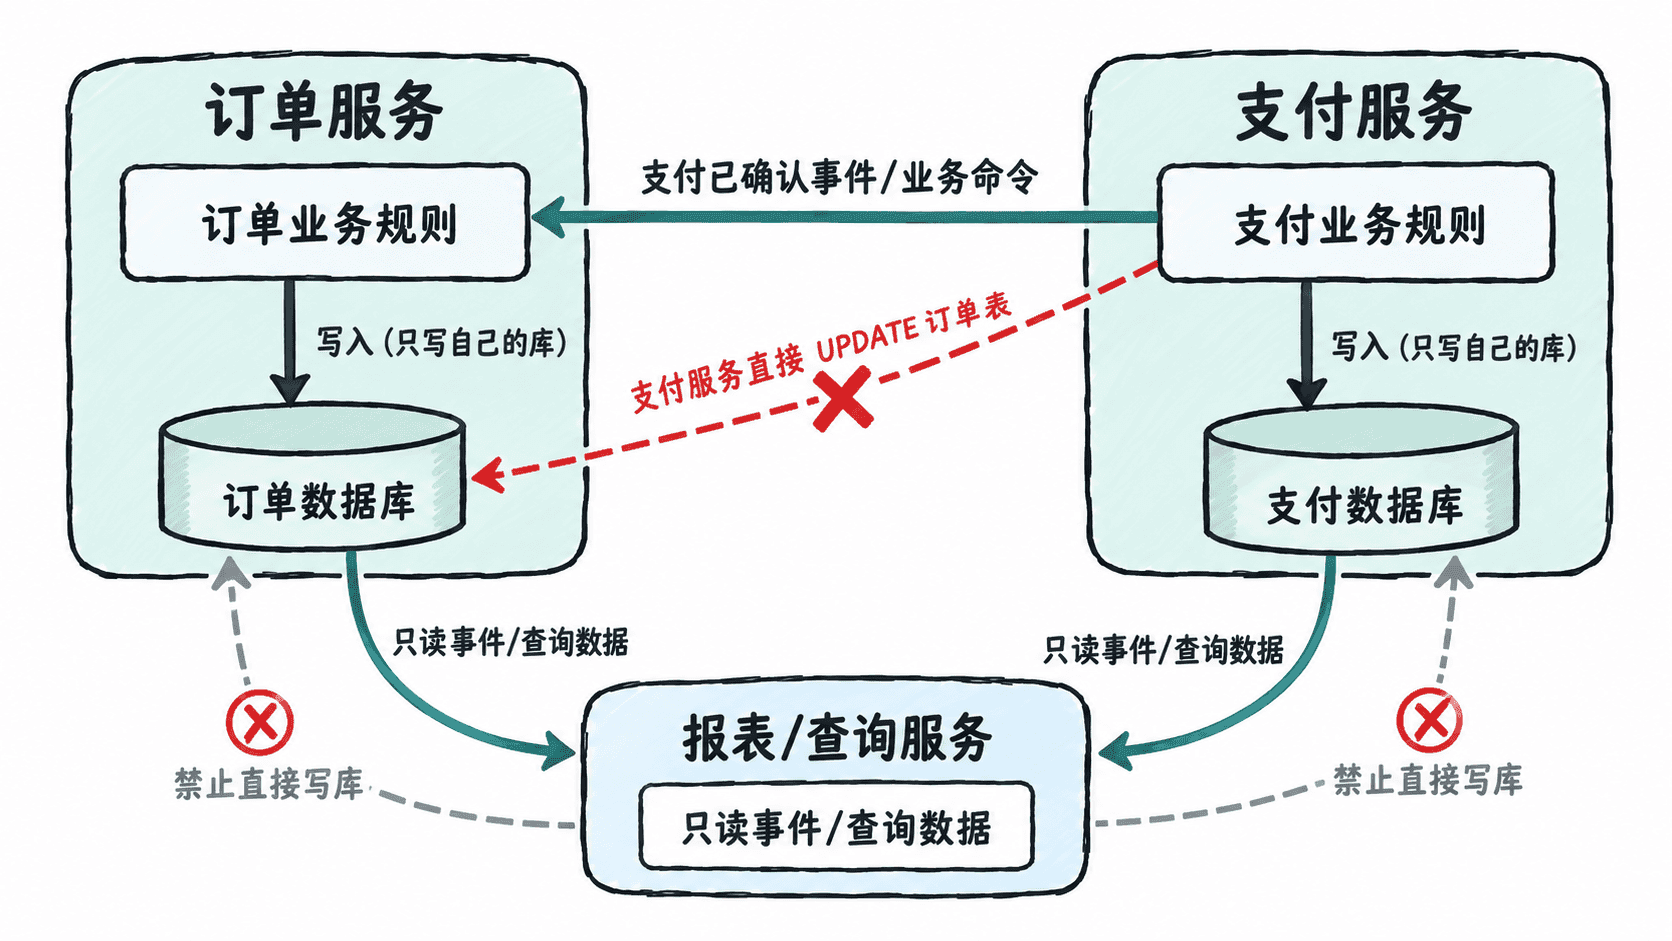
这样做的关键收益是把业务校验留在拥有者内部。否则服务 B 一旦直接更新 A 的表,就必须理解 A 的字段约束、状态机和事务规则,数据库结构会变成事实上的跨服务 API。
用数据库权限把共享写入暴露出来
下面是 PostgreSQL 测试库中的最小示例,假设以具备创建角色和切换角色权限的管理员执行。订单服务拥有 orders.order_record,支付服务只被授予读取权限,因此它可以查询订单,却不能直接修改订单状态。
CREATE ROLE order_service NOLOGIN;
CREATE ROLE billing_service NOLOGIN;

CREATE SCHEMA orders AUTHORIZATION order_service;

SET ROLE order_service;
CREATE TABLE orders.order_record (
    id BIGINT PRIMARY KEY,
    status TEXT NOT NULL
);
INSERT INTO orders.order_record (id, status)
VALUES (1001, 'PENDING');
RESET ROLE;

GRANT USAGE ON SCHEMA orders TO billing_service;
GRANT SELECT ON orders.order_record TO billing_service;

SET ROLE billing_service;
SELECT id, status FROM orders.order_record;
UPDATE orders.order_record
SET status = 'PAID'
WHERE id = 1001;
预期输出:
CREATE ROLE
CREATE ROLE
CREATE SCHEMA
SET
CREATE TABLE
INSERT 0 1
RESET
GRANT
GRANT
SET
  id  | status
------+---------
 1001 | PENDING
(1 row)

ERROR:  permission denied for table order_record
如果这条 UPDATE 在真实系统中仍能成功,就说明“服务边界”只存在于代码仓库里,数据库层并没有兑现。生产环境通常还应使用独立数据库账号、最小权限和审计日志,避免所有服务共用一个高权限连接账号。
处理读取、关联和一致性
切开写所有权后,最常见的问题是“那别的服务怎么查”。如果只是少量实时查询,可以调用拥有者的 API;如果读取量大或需要跨服务聚合,应通过事件构建本地只读副本、搜索索引或报表模型。不要为了一个查询方便,就重新开放共享写库。
跨服务流程也不再依赖一个数据库事务一次提交全部修改。订单与支付分别提交自己的本地事务,再通过消息、幂等处理和补偿机制推进整体流程。这里的目标不是追求所有数据瞬时一致,而是确保每个事实只有一个地方能最终裁决。
判断边界是否成立,可以做一个简单验收:停掉订单服务后,支付服务仍能记录支付事实,但不能偷偷改订单;订单服务恢复后,能够依据消息或重试完成状态推进。做到这一点,数据所有权才真正转化成可自治的服务边界。