
架构与系统设计 / 系统课时
识别分布式单体信号
识别分布式单体信号
把一个应用拆成多个部署单元,并不代表获得了微服务自治。如果一次请求必须串行穿过许多服务、一次改动要求多个团队联合发布,或任意节点故障都会拖垮整条链路,那么系统很可能只是把单体的耦合搬到了网络上。本篇给出一套可操作的识别方法。
学习目标
- 从调用、发布、模型和故障四个维度识别分布式单体
- 区分合理的服务协作与必须同步变化的强耦合
- 根据观察到的信号确定优先修复的边界问题
不要用服务数量判断拆分成功
分布式单体的核心问题不是“服务太多”或“同步调用存在”,而是多个服务无法独立变化和独立失败。如果修改一个业务规则必须同时修改五个仓库,再按固定顺序发布五个服务,那么这些部署单元仍然共同组成一个不可分割的变化单元。
判断时应关注两个问题:一个服务能否在不协调其他服务版本的情况下发布,以及一个服务故障时,其余服务能否维持合理的部分能力。两个答案都是否定时,拆分通常只增加了网络、部署和排障成本,却没有换来自治能力。
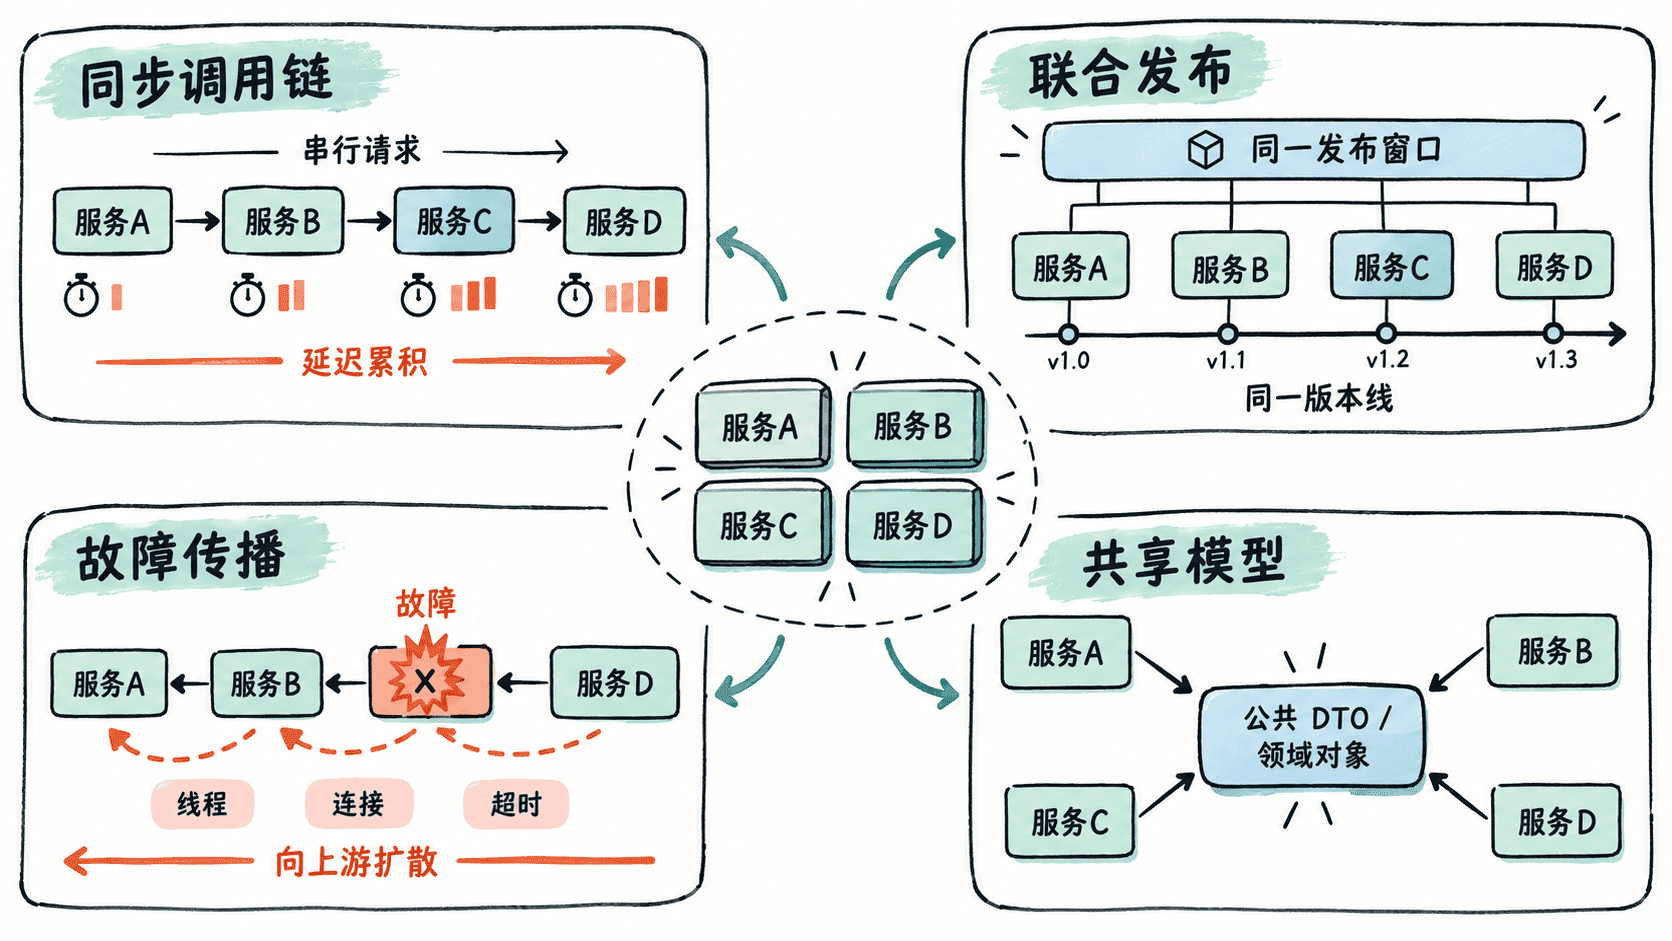
同步调用链是否变成远程函数调用
同步调用本身并不是错误。问题出现在服务只是为了完成一个本应完整的业务动作,就必须逐层询问其他服务的内部细节。例如入口服务调用订单,订单调用客户,客户调用会员,会员再调用营销;任何一层延迟都会增加整体响应时间,任何一层超时都可能让整条请求失败。
一个明显信号是:为了保证某个接口成功,团队必须同时讨论四五个下游服务的可用性。另一个信号是调用链存在大量“拿一个字段再继续”的细粒度请求,这通常说明边界切得过细,业务决策所需的数据和行为被拆散了。
修复时不应机械地把所有同步调用改成消息。先确认哪个服务应该拥有这次业务决策,把必须同时判断的数据尽量收回同一边界;只有已经发生、无需立即返回结果的事实,才适合通过事件异步传播。
发布是否必须绑在一起
联合发布是最容易从工程流程中观察到的信号。若服务 A 的新版本只有配合服务 B、C 的特定版本才能运行,接口虽然通过 HTTP 或 RPC 暴露,实际却没有形成兼容契约。
可以从最近几次需求反推:一个普通字段变更需要改多少个服务;发布顺序是否严格固定;是否频繁出现“先等另一个团队上线”;回滚其中一个服务是否会导致其他服务立即不可用。若这些情况成为常态,服务边界仍然共享同一个变化节奏。
解决重点是缩小契约表面并允许独立演进,例如新增字段保持向后兼容、消费者只依赖真正需要的数据、事件采用可演进的版本策略。不要为了减少重复代码,把内部领域对象封装成一个所有服务都必须同步升级的公共模型包。
共享模型是否重新制造全局领域模型
共享一个通用的技术类型没有问题,危险的是多个服务共同依赖同一份具有业务语义的 Customer、Order 或状态枚举,并认为这些对象在所有上下文中必须完全一致。
在领域驱动设计中,同一个现实对象可以在不同上下文拥有不同模型。结算服务关心订单的金额和支付状态,配送服务关心地址、包裹和履约状态。强迫两者使用同一个完整订单模型,会使一个上下文新增字段或状态时,另一个上下文也被迫理解并升级。
| 观察到的现象 | 更像自治服务 | 更像分布式单体 |
|---|---|---|
| 接口模型 | 面向当前契约,只暴露必要信息 | 直接暴露内部领域对象 |
| 版本变化 | 消费者可在兼容窗口内独立升级 | 提供者和消费者必须同时升级 |
| 公共依赖 | 共享基础技术能力 | 共享大量业务实体和状态枚举 |
| 数据解释 | 各上下文拥有自己的语义 | 多个服务争夺同一模型定义权 |
故障是否沿依赖链扩散
真正自治的服务不要求完全隔离故障,但应为依赖失败定义清晰边界。下游不可用时,上游可能返回部分结果、进入待处理状态或明确失败,而不是无限重试直到线程池、连接池和队列全部耗尽。
分布式单体常见的传播路径是:一个下游响应变慢,上游请求开始堆积;重试进一步增加流量;连接池被占满后,原本健康的其他接口也无法获得资源;最终看起来像整个系统同时故障。这类问题说明服务之间不仅业务耦合,运行时资源也通过同步依赖绑在一起。
检查时应关注超时是否逐层递减、重试是否有上限、调用方是否具备降级路径,以及关键异步流程是否能够重放。熔断和限流可以阻止传播,但如果每个核心业务动作仍必须依赖十几个同步服务,它们只能缓解症状,不能修复错误边界。
用自治能力决定是否需要重新划界
发现一两个信号不必立即合并服务。先判断问题来自契约设计、调用方式,还是领域边界本身。如果两个服务长期同时修改、同时发布、共享大量业务模型,并且一个离开另一个就无法完成任何有价值的业务能力,那么把它们重新合并到一个边界,往往比继续增加消息队列、熔断器和适配层更简单。
反过来,如果服务拥有独立业务职责,只是某条调用链过长或契约缺乏兼容性,则应优先修复调用和契约,而不是推翻拆分。衡量拆分是否成功的最终标准,是服务能否独立理解自己的规则、独立发布大多数变化,并在其他服务出现故障时维持清晰且可预期的行为。