
架构与系统设计 / 系统课时
判断边界是否值得独立部署
判断边界是否值得独立部署
限界上下文划清以后,不必立即把每个边界做成一个微服务。本篇用变更频率、伸缩需求、故障隔离和团队自治四类信号判断独立部署的收益,并把分布式复杂度作为反证,避免为了“边界完整”而机械拆服务。
学习目标
- 区分逻辑边界与独立部署单元
- 用四类运行与组织信号评估拆分价值
- 在拆分前识别网络、数据一致性和运维成本
逻辑边界不等于部署边界
限界上下文首先回答“这套模型由谁拥有、使用什么语言、哪些规则属于这里”。部署边界回答的则是“能否独立发布、扩容和故障恢复”。两者相关,但不是一一对应关系。
一个应用完全可以先在同一进程中保留多个清晰的上下文模块,等运行压力或组织需求出现后再拆。反过来,如果模型边界本身含糊,仅仅把代码部署成多个进程,并不会自动得到良好的微服务。
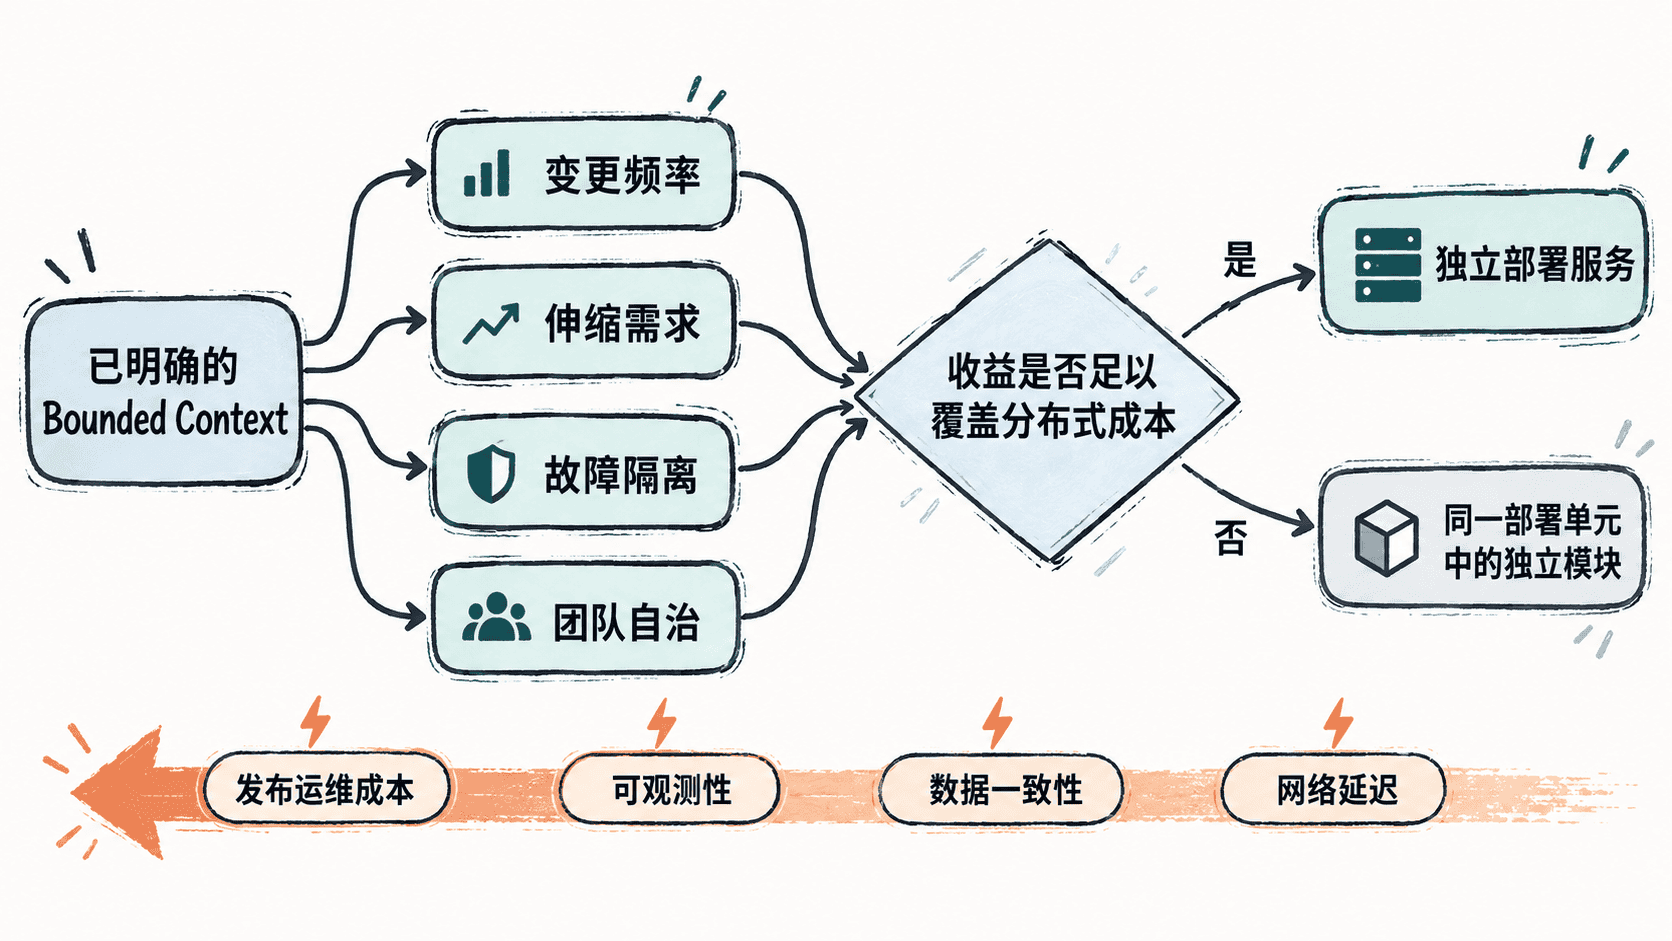
从四个压力判断是否值得拆
变更频率关注的是发布耦合。如果库存规则每周多次调整,而订单核心数月才改一次,把两者绑在同一个发布单元中会让低频模块被迫跟随高频模块重新测试和发布。差异越长期、越稳定,独立部署价值越高。
伸缩需求关注资源曲线是否不同。例如搜索上下文在活动期间需要大量 CPU,而结算上下文更依赖数据库事务。若只能整体扩容,就会为不需要的部分一起付出资源成本。
故障隔离关注一个上下文的异常是否应该拖垮另一个上下文。推荐、报表等非核心能力如果发生内存泄漏或外部依赖超时,而核心交易仍应继续运行,那么进程级甚至部署级隔离就有实际意义。
团队自治关注团队能否真正独立交付。只有当团队拥有代码、数据、发布流水线和运行责任时,独立部署才能减少协调;如果几个服务仍由同一个团队同时修改、同时上线,拆分反而可能增加操作负担。
用小评分做第一轮筛选
下面的脚本不是架构公式,而是一种评审辅助工具。每个维度按 0、1、2 分别表示弱、中、强信号,用总分强迫团队把“为什么要拆”说清楚,再结合实际证据做最终决策。
criteria = {
    "change_frequency": 2,
    "scaling_need": 1,
    "fault_isolation": 2,
    "team_autonomy": 2,
}

score = sum(criteria.values())

if score >= 6:
    decision = "建议进入独立部署验证"
elif score >= 3:
    decision = "保留逻辑边界,先共享部署"
else:
    decision = "暂不独立部署"

print(f"score={score}, decision={decision}")
预期输出
score=7, decision=建议进入独立部署验证这里的“进入验证”并不等于立即拆分。高分只说明存在较强收益信号,接下来仍要检查调用关系、数据所有权和运维成本,确认没有被评分掩盖的反证。
拆分前先找反证
独立部署会把原本的进程内调用变成跨进程协作,因此至少要重新审视四类成本:
- 原本简单的方法调用是否变成高频网络调用,并引入不可接受的延迟。
- 原本单数据库事务是否会被拆成跨服务一致性问题,需要事件、补偿或幂等机制。
- 服务数量增加后,日志关联、指标、链路追踪和告警是否具备支撑能力。
- 是否需要新增镜像构建、配置管理、发布流水线、容量管理和值班责任。
用可验证结果决定是否保留拆分
真正完成独立部署后,应观察它是否兑现了原先的理由。例如高频变更的上下文能否单独上线,流量高峰时能否只扩容目标服务,故障演练时能否阻止异常传播,以及团队是否减少了跨团队发布协调。
如果这些收益没有出现,却新增了大量远程调用、分布式事务和运维工作,应允许架构回退。限界上下文负责保护业务模型,微服务负责解决部署与运行问题;只有后者的收益足够明确时,逻辑边界才值得升级为独立部署边界。