
AI Agent / 系统课时
优化上下文与使用成本
优化上下文与使用成本
Claude Code 的成本不是只由“问了多少次”决定,而是取决于每轮需要处理的上下文、会话是否持续膨胀、任务是否过宽以及模型是否匹配任务。本课把这些因素变成一套可执行的控制方法,让你在不牺牲结果质量的前提下减少无效消耗。
学习目标
- 识别会话中持续占用上下文的主要来源,并用内置命令检查使用情况
- 正确选择
/clear、/compact与更小的任务边界,避免历史信息反复计费 - 按任务难度选择模型,并建立以结果质量为约束的成本控制习惯
先定位上下文为什么变大
同一会话越长,每次请求通常需要携带的历史越多。除此之外,项目级 CLAUDE.md、已加载的工具说明、MCP 工具结果和大段文件内容也会进入上下文。优化的第一步不是盲目缩短提示词,而是先看“哪些信息正在持续占空间”。
在 Claude Code 会话中运行:
/context
/usage
预期输出:
/context:显示当前会话中主要的上下文占用来源。
/usage:显示当前会话的使用量、模型分布等信息;具体数值会随账号、模型和会话变化。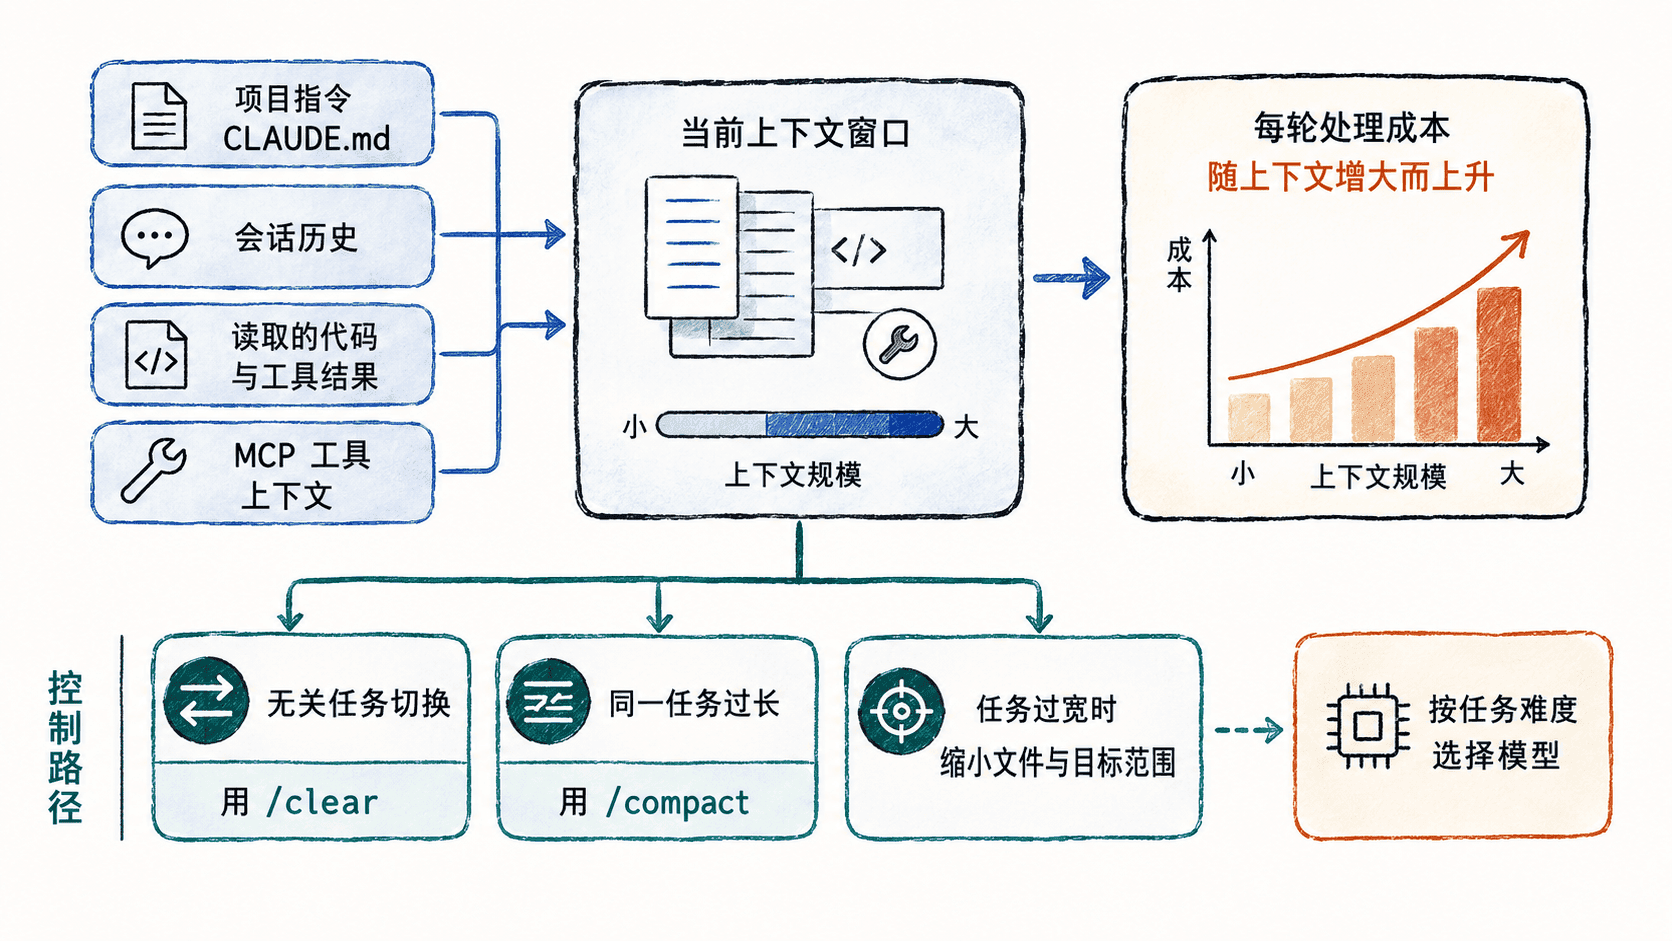
如果 /context 显示某个长期不使用的 MCP 或过大的项目指令占比明显,应先精简这些固定成本;如果主要是长会话历史,则优先处理会话边界,而不是继续往同一会话里追加说明。
用会话边界代替无限续聊
切换到无关任务时,最有效的动作是开启干净上下文。/clear 适合“上一件事已经结束,下一件事不需要它的历史”;/compact 适合“仍在做同一件事,但对话已经很长”,它会压缩旧历史并保留继续工作所需的信息。
例如,在一次持续数小时的重构中,可以明确告诉压缩过程保留什么:
/compact 保留已修改文件、仍失败的测试、已确认的设计约束和下一步任务预期结果:
旧会话历史被压缩为更短的摘要,后续仍能围绕当前重构继续工作;具体摘要内容因会话而异。当你准备从“修复支付回调”转去“设计搜索索引”时,不要继续依赖压缩后的旧会话,应直接使用 /clear。两个任务没有共享决策时,保留历史只会让后续每轮都携带无关信息。
缩小输入范围和任务粒度
高成本任务常见的问题不是代码库大,而是指令让 Claude 一开始就“阅读整个仓库、理解所有模块、顺便重构”。更稳妥的方式是先给目标、边界和验收条件,再允许按需要扩展读取范围。
可以把任务写成:
只处理 packages/billing/src 下的退款逻辑。
先读取入口、相关测试和直接依赖,不要扫描其他包。
目标:修复重复退款;保持公开 API 不变。
完成后运行 billing 包的单元测试,并说明仍存在的失败。
预期结果:
Claude 优先围绕指定目录和验收目标工作,只在确有依赖时扩大读取范围,并以测试结果验证修改。这种写法同时控制了输入范围和任务粒度。如果任务仍然跨越多个独立目标,把它拆成“定位原因 → 修改 → 回归验证”或按模块拆开,比让一个会话长期追踪多个分支更容易控制上下文。
让模型与任务难度匹配
不要把“最强模型”设成所有工作的固定答案。日常代码阅读、局部修改和常规测试通常适合默认的均衡型模型;复杂架构取舍、长链路排障或高风险重构再切换到更强的推理模型;简单、边界明确的子任务可以使用更轻量的模型。
在会话中使用 /model 查看并切换当前账号可用的模型,而不是在团队规范里长期硬编码可能过时的具体模型编号。成本优化的判断标准也不是“单次最便宜”,而是在满足验收条件的前提下,减少总重试、无效读取和重复上下文。
最终应形成一个简单习惯:先用 /context 和 /usage 看证据;无关任务用 /clear;长任务用带保留要求的 /compact;提示词限制目标和文件范围;模型只为任务所需能力付费。这样控制的是整条工作链路,而不是只压缩某一句提示词。