
AI Agent / 系统课时
实现功能并修复测试
实现功能并修复测试
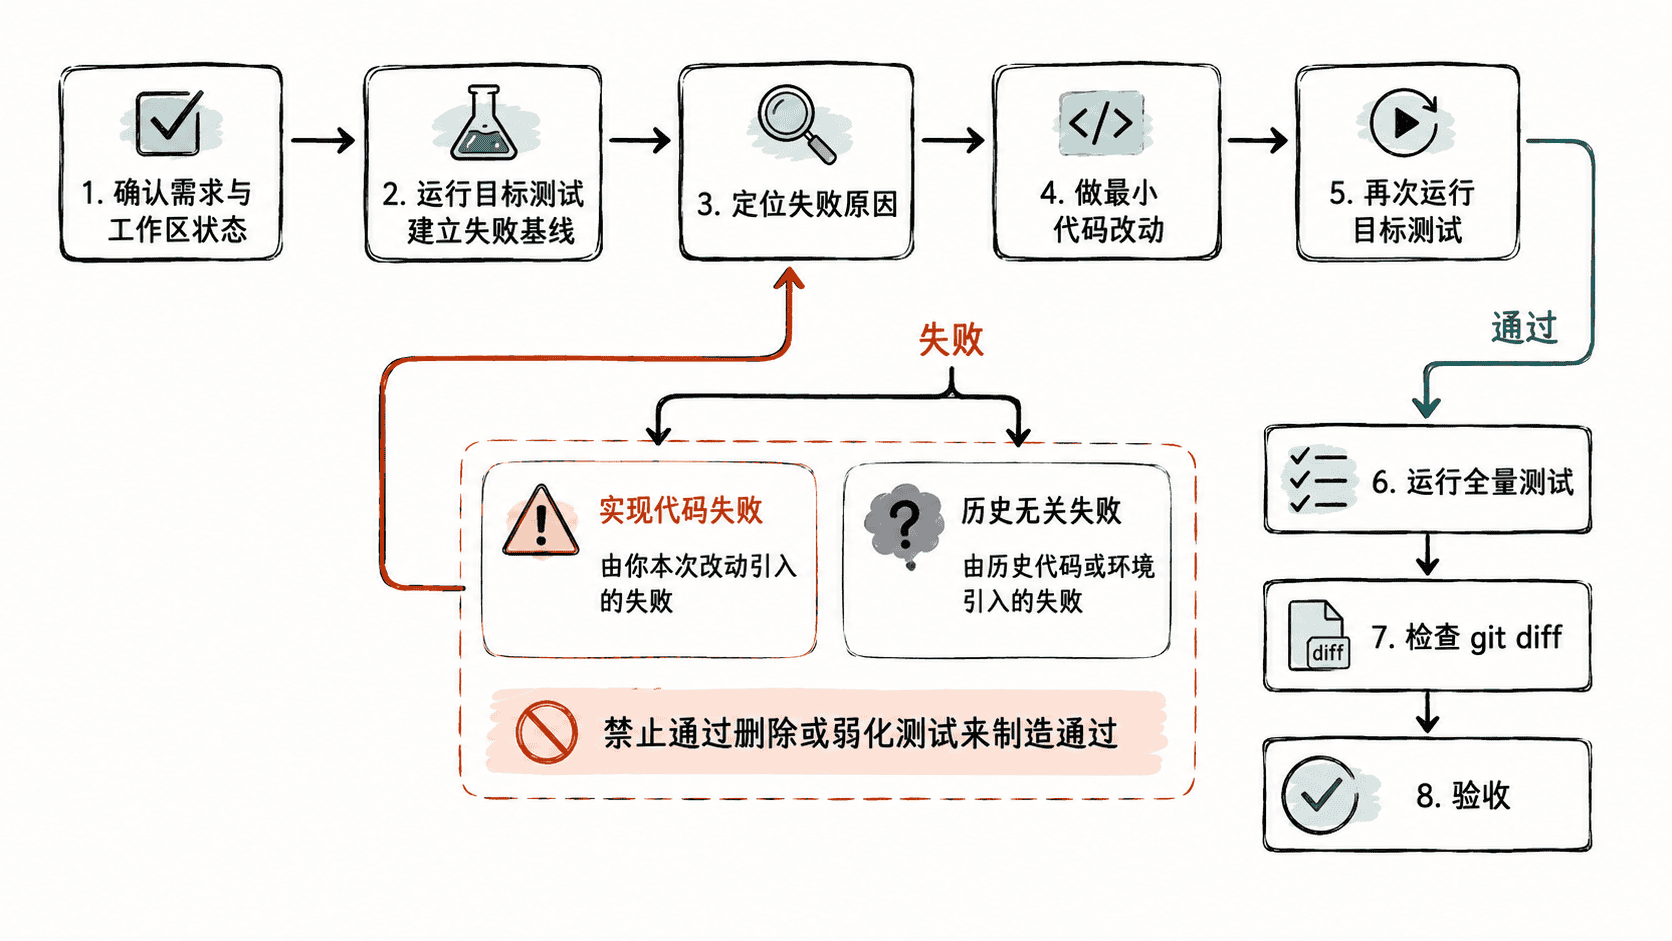
这一节把一次真实改动拆成可验证的小循环:先确认需求与失败基线,再让 Claude Code 做最小实现,随后根据失败测试修正,最后跑全量测试和差异检查,确保“功能能用”与“没有引入回归”同时成立。
学习目标
- 把功能需求转换成可执行、可验收的修改任务
- 用“局部测试 → 修复 → 全量测试”的节奏控制改动范围
- 在交付前检查代码差异,避免为了过测试误改测试或扩大重构
先建立失败基线
不要一上来就让 Claude Code 修改全部相关文件。先告诉它读取需求、实现和现有测试,再运行最小测试集,确认失败确实来自待实现功能,而不是依赖、环境或历史脏状态。
下面假设项目使用 Vitest,package.json 中已经配置 test 脚本,目标测试文件为 test/shipping.test.ts。进入仓库后启动 Claude Code:
claude预期结果
<CLAUDE_CODE_SESSION_READY>在会话中给出一个约束明确的任务,而不是只说“把测试修好”:
读取 package.json、test/shipping.test.ts 和对应实现文件。
先运行目标测试并说明当前失败原因,再实现“订单金额达到 100 或 VIP 用户免运费,否则运费为 12;负金额必须报错”。
只修改完成该需求所必需的文件。不要为了让测试通过而删除、跳过或弱化测试。
每次修改后先运行目标测试;目标测试通过后再运行全量测试,并汇报仍然存在的失败。
这类提示把“先调查、再改动、再验证”写成验收条件。Claude Code 可以自行定位文件,但你仍然保留了范围边界:需求不允许它顺手重构无关模块,测试也不能被当作障碍直接删掉。
根据失败类型决定下一步
测试失败不等于“继续改实现”。先看失败属于哪一层:断言差异通常指向业务逻辑,模块找不到或构建失败多半是依赖与路径问题,超时可能来自异步流程或外部服务。让 Claude Code 先解释失败证据,再允许它修改,可以显著减少盲修。
如果一次修改引出新的失败,要求它回答三个问题:失败是否与本次需求直接相关、哪一处代码改变了行为、能否用更小的补丁恢复预期。这样每轮都有因果关系,而不是连续试错。
用分层测试收敛改动
目标测试通过后,再运行完整测试套件和 Git 差异检查。局部测试证明当前功能成立,全量测试检查回归,git diff --check 则能发现空白错误等基础问题。
npm test -- --run test/shipping.test.ts
npm test -- --run
git diff --check
git diff -- src test
预期输出
Test Files  <VALUE> passed
Tests       <VALUE> passed
<NO_OUTPUT_FROM_GIT_DIFF_CHECK>
diff --git a/<PATH> b/<PATH>
<VALUE>测试数量、路径和差异内容会随仓库而变化;关键验收是目标测试和全量测试都成功,git diff --check 没有错误,同时最终差异只覆盖需求需要的文件。
测试仍然失败时怎么收尾
如果全量测试还有失败,不要把它们统称为“环境问题”。让 Claude Code 逐个给出失败测试、首个关键错误、与本次改动的关联证据,并把“本次引入的回归”和“修改前已经存在的失败”分开。无法证明是历史问题时,就继续修复。
真正可交付的状态不是“Claude 说已经完成”,而是需求有对应实现、目标测试通过、全量测试没有新增失败、差异范围可解释。达到这四个条件后,再提交代码或进入代码评审。