
AI Agent / 系统课时
能力边界与人工责任
能力边界与人工责任
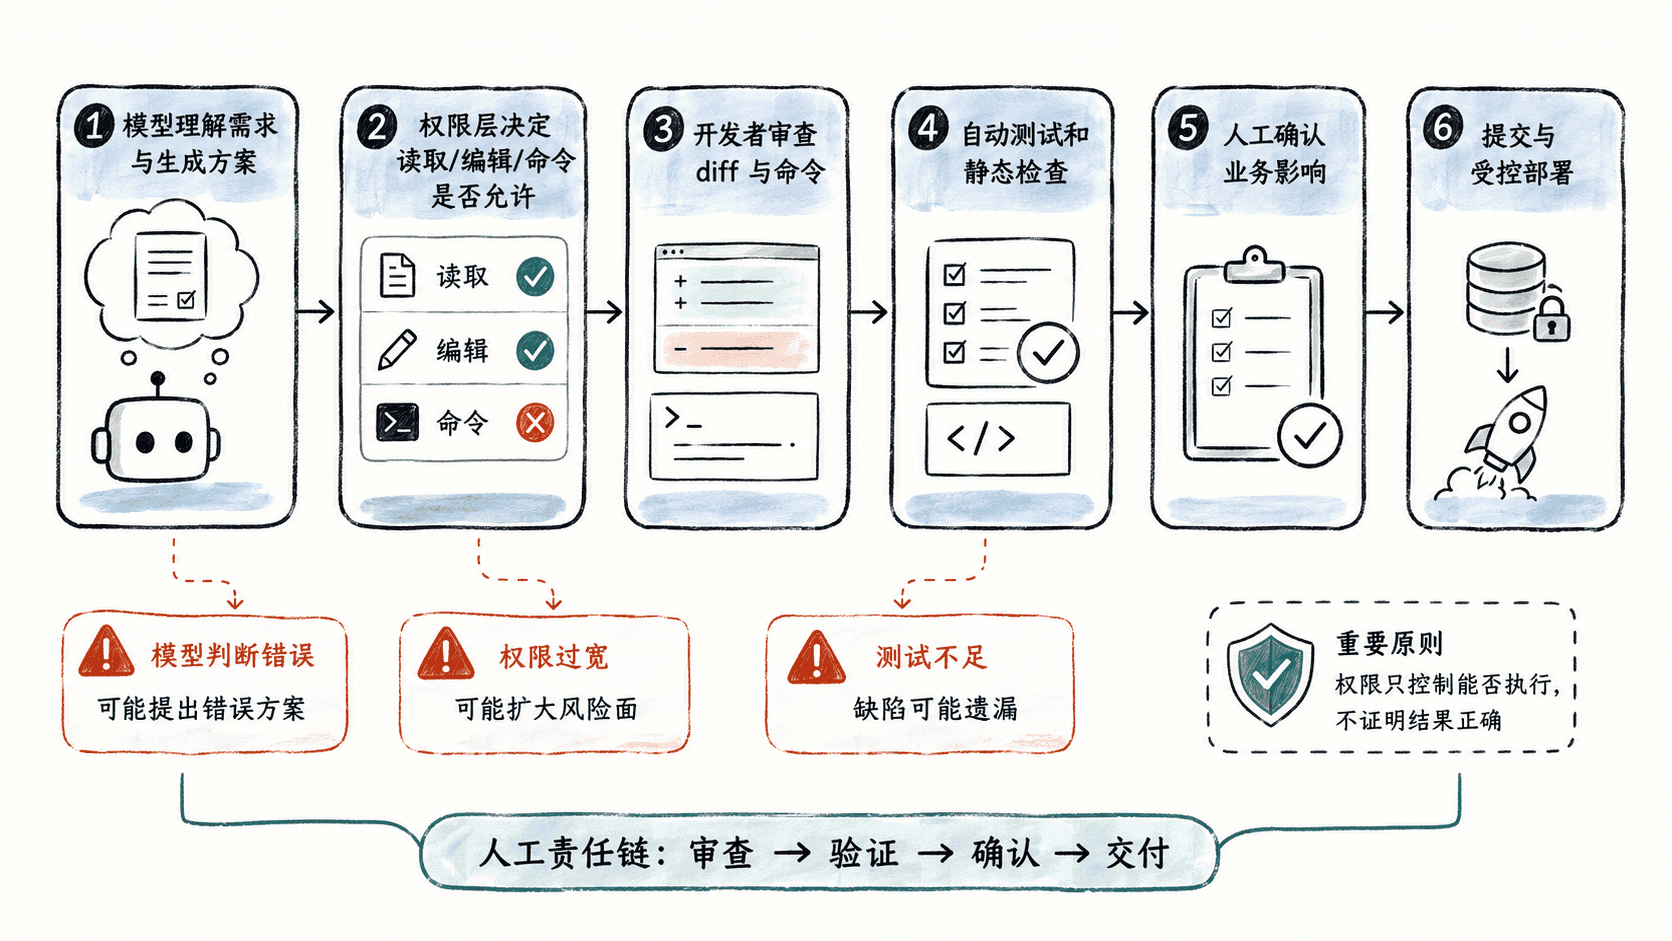
Claude Code 能读取项目、修改文件并调用命令,但“能执行”不等于“结果一定正确”。本节把模型判断、工具授权和开发者责任拆开,建立一条从授权到审查、测试再到交付的最小安全闭环。
学习目标
- 识别 Claude Code 可能出错的主要环节,不把工具权限误当成正确性保证
- 根据动作风险决定是否授权,并为高风险操作保留人工确认
- 用差异审查、测试与交付检查把模型输出转化为可负责的工程变更
先划清能力边界
Claude Code 的结果受三类边界共同影响:模型可能误解需求或遗漏上下文;工具只能在当前权限和环境中行动;真实系统还包含模型未必看到的业务规则、外部依赖与组织流程。因此,代码“看起来合理”、命令“成功退出”都不能单独证明变更正确。
最常见的错误并不一定是语法错误,而是改错范围、遗漏边界条件、删除仍被使用的接口、根据过期假设修改配置,或者把只适用于本机的方案当成通用方案。开发者需要把模型输出视为待验证的工程候选,而不是最终事实。
授权只代表允许执行
默认权限机制会区分读取、编辑和命令执行,并可通过允许、询问和拒绝规则收紧边界。批准某个动作的含义只是“允许 Claude Code 做这件事”,不是“我确认它的业务后果正确”。删除文件、修改发布配置、执行数据库迁移、推送远端分支、接触凭据或写入外部服务时,都应提高审查强度。
审查与测试形成闭环
先看变更范围,再看关键逻辑,最后运行项目既有验证。git diff 用来回答“到底改了什么”,测试用来回答“已有行为是否仍满足约束”,两者互相不能替代。下面的命令适合在准备提交前检查补丁中的空白错误:
git diff --check预期输出
<no output>没有输出表示 Git 未发现空白错误;它不代表功能测试已经通过。随后仍要运行项目既有测试套件,并对失败用例逐项判断原因,不能让 Claude Code 通过删除测试或放宽断言来“修复”失败。
交付责任不能外包
最终交付责任仍在开发者和团队。至少要确认变更范围符合需求、敏感信息没有进入提交、关键测试通过、构建或运行路径可复现,并检查数据库、权限、网络调用和兼容性等不可逆影响。必要时让另一位开发者做代码审查,或先在测试环境验证。
最稳妥的工作方式不是降低 Claude Code 的能力,而是把能力放进清晰的边界中:低风险读取可以放宽,高风险写入要保留确认;模型负责加速分析和实现,人负责定义约束、核验事实并对最终结果签字。