
AI Agent / 系统课时
终端智能体如何工作
终端智能体如何工作
终端智能体不会在收到请求后一次性生成完整答案。它通常先观察项目,再选择工具执行动作,并把工具返回的新信息继续加入判断。本节用一个最小开发任务拆解这个循环,让你知道 Claude Code 为什么会连续读取、执行、修改和验证。
学习目标
- 理解获取上下文、选择操作、观察结果和继续推进的基本循环
- 识别文件内容、项目说明和命令输出在上下文中的不同作用
- 能根据智能体的操作记录判断它为什么继续执行或停止
基本循环是什么
假设你要求 Claude Code“检查当前改动并修复失败的测试”。它通常不能仅凭这句话知道问题在哪里,因此会先收集证据,然后根据证据选择下一项操作。每次工具返回结果后,原先的判断都可能被修正。
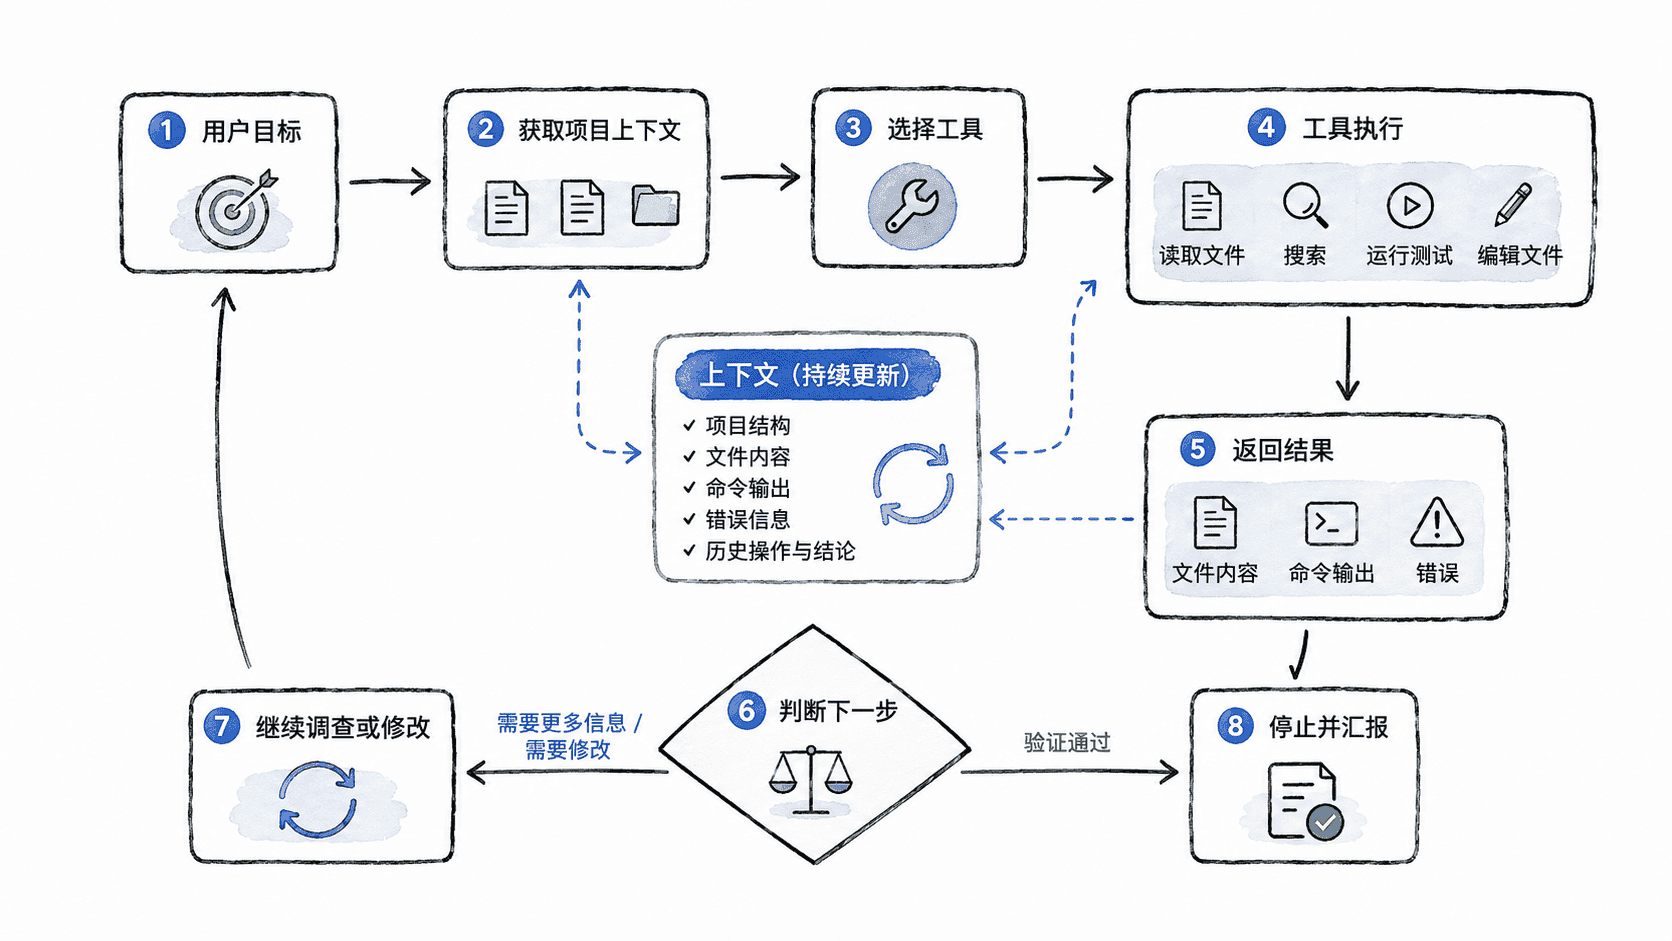
这个过程可以概括为:观察 → 决策 → 操作 → 获取结果 → 再决策。重要的是回环,因为软件开发中的第一次判断经常不完整。例如测试失败可能来自代码错误,也可能来自配置、依赖或测试数据,只有看到实际结果后才能继续缩小范围。
上下文从哪里来
终端智能体能够利用的上下文并不等于“整个硬盘都自动进入模型”。它需要通过当前会话已有信息和工具读取结果逐步获得与任务相关的材料。
常见来源包括当前对话中的目标与限制、仓库中的源代码和配置、项目级说明文件(例如 CLAUDE.md)、Git 工作区状态,以及构建或测试命令产生的输出。不同任务需要的上下文不同,好的执行过程会优先读取能够缩小问题范围的证据。
工具调用怎样改变下一步
下面用 Git 状态演示一次只读的上下文获取。假设示例仓库已经修改了 src/auth.ts,并新增了 test/auth.spec.ts,智能体可以执行:
git status --short预期输出:
 M src/auth.ts
?? test/auth.spec.ts
实际文件名和状态取决于当前仓库。这里的关键不是 git status 本身,而是输出会改变智能体的下一步:它现在知道工作区存在尚未提交的改动,因此在继续编辑之前,应先检查这些文件,避免覆盖用户已有工作。
同样地,如果随后运行测试得到失败信息,错误堆栈会成为新的上下文;如果修改代码后测试通过,成功结果又会成为判断任务是否可以结束的证据。工具调用因此既是“做事情”,也是“获得事实”。
一次任务为什么会执行多轮
多轮并不意味着智能体没有计划,而是开发任务存在大量只能在执行后才能知道的信息。读取文件可能发现真正逻辑位于另一个模块;运行测试可能暴露新的边界条件;修改一个接口后,类型检查又可能指出其他调用点需要同步调整。
智能体通常会在两种情况下结束循环:一是已经获得足够证据证明目标完成,例如相关测试和检查通过;二是遇到无法安全自行解决的阻塞,例如缺少必要凭据、需要用户作产品决策,或下一步操作超出当前权限。
因此,使用 Claude Code 时不要只观察它最终写出了什么代码,还要观察整个证据链:它为何读取这些内容、工具实际返回了什么、修改依据是什么,以及验证是否真正覆盖了任务目标。理解这个循环后,你就能更有效地判断一次智能体执行是否可靠。