
FPGA 与数字 IC 设计 / 系统课时
验证异步 FIFO 边界
验证异步 FIFO 边界
异步 FIFO 最容易在满、空、复位和跨频率边界暴露问题。本节用独立读写时钟、突发和停顿场景验证数据不丢失、不重复、不乱序,并把 DUT 的读数据延迟明确纳入参考模型,避免同步 RAM 或 FWFT 接口因采样时机错误产生误报。
学习目标
- 能构造写快读慢、写慢读快以及突发访问的边界场景
- 能用无竞争的参考模型验证数据顺序、满空保护与复位清理
- 能按 DUT 的读接口延迟选择正确的数据采样和比较时机
先确定边界与采样协议
至少覆盖四类条件:读写时钟频率明显不同;任一侧时钟或请求短暂停顿;连续写入逼近满状态;连续读取逼近空状态。复位还要分别覆盖空闲复位和传输中复位,因为两个时钟域对复位释放的观察时刻可能不同。
验证时持续检查三个不变量:只有 wr_en && !full 的事务才算写成功;只有 rd_en && !empty 的事务才算读成功;每个成功读出的数据都必须与先前成功写入的数据保持相同顺序。
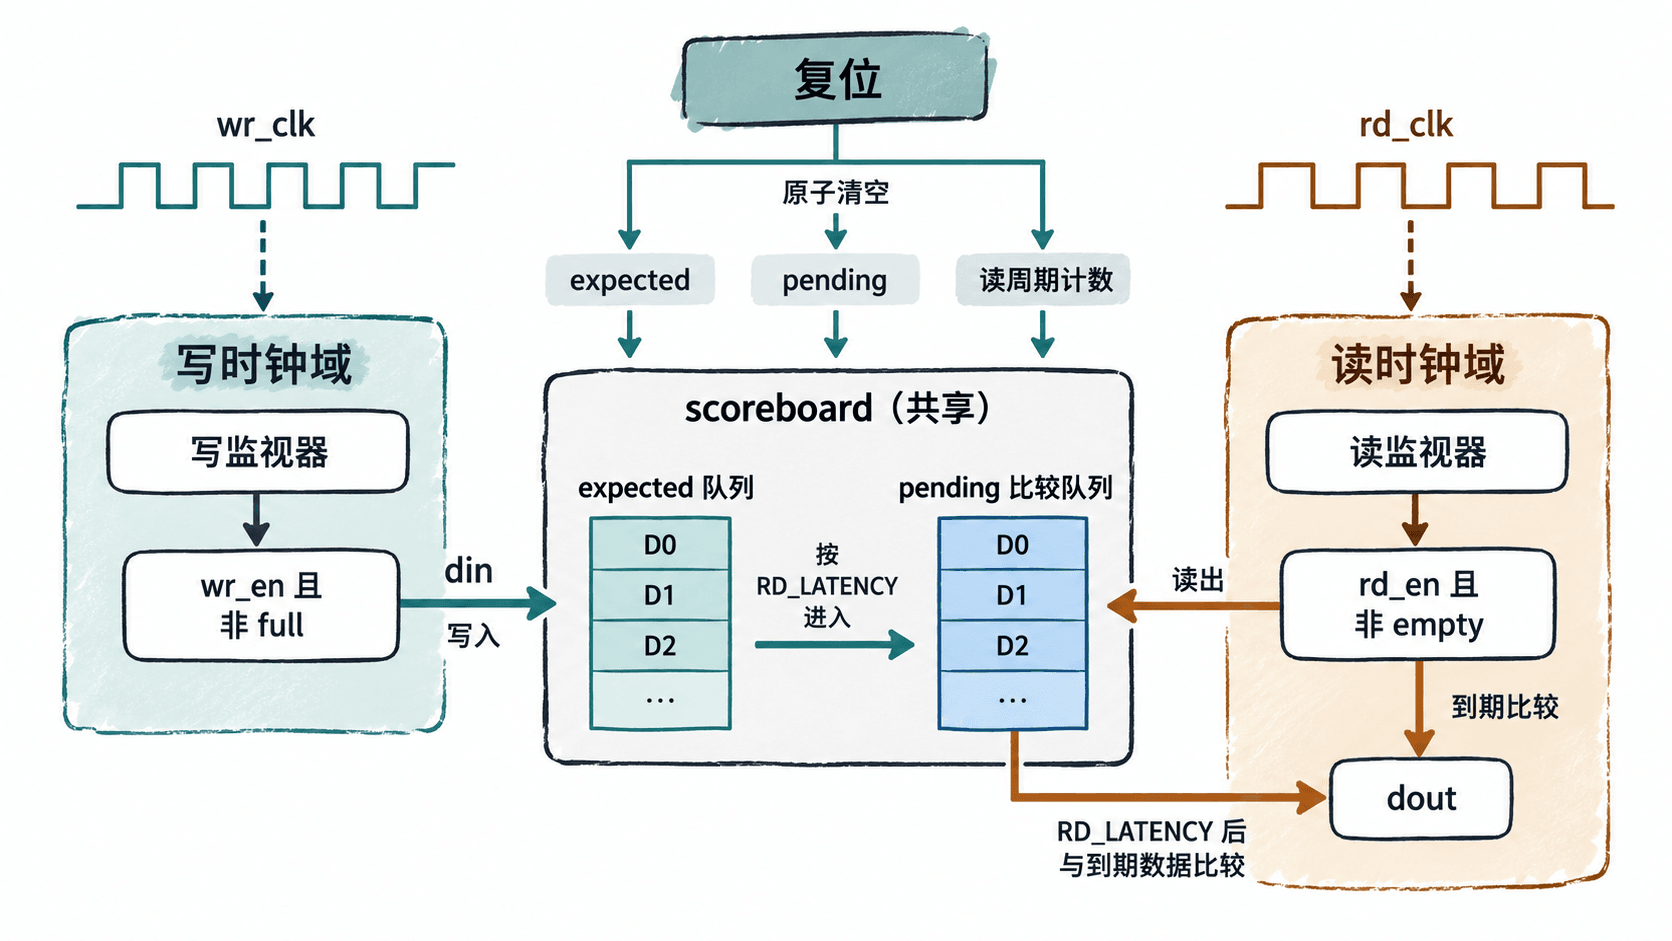
边界测试必须先定义 DUT 的读接口语义。这里把 RD_LATENCY 定义为“一个读事务被接受后,需要经过多少个读时钟边沿,当前请求对应的数据才会出现在约定采样点”。组合/FWFT 读通常取 0,一拍同步读取 1,更深流水按实际级数增加。
用串行化 scoreboard 消除模型竞争
参考模型不能在一个时钟线程中直接用 expected = new() 替换共享 mailbox,而让另一个异步线程同时访问旧句柄。即使 DUT 完全正确,这种模型级竞争也可能造成丢数据或访问不同对象。更稳妥的方式是让期望队列、待读比较项和复位操作都属于同一个 scoreboard,并用 semaphore 串行化访问。
下面是片段示例,假定 testbench 已定义 DATA_W、wr_clk、rd_clk、rst_n、wr_en、rd_en、full、empty、din 和 dout。代码使用 clocking block 的 #1step 输入采样,在有效边沿之前取得稳定接口值:这既避免 testbench 与 DUT 在同一仿真区域竞争,也让 RD_LATENCY=0 能比较边沿前的组合读头,而一拍同步输出可在下一读时钟边沿被采到。
localparam int RD_LATENCY = 1;
typedef logic [DATA_W-1:0] data_t;

class fifo_scoreboard #(parameter type T = logic [7:0]);
  typedef struct {
    int unsigned due_cycle;
    T data;
  } pending_t;

  T expected[$];
  pending_t pending[$];
  semaphore lock;
  int unsigned rd_cycle;
  int unsigned rd_latency;

  function new(int unsigned latency);
    lock = new(1);
    rd_latency = latency;
    rd_cycle = 0;
  endfunction

  task reset();
    lock.get(1);
    expected.delete();
    pending.delete();
    rd_cycle = 0;
    lock.put(1);
  endtask

  task on_write(bit accepted, T data);
    lock.get(1);
    if (accepted)
      expected.push_back(data);
    lock.put(1);
  endtask

  task on_read(bit accepted, T actual);
    T exp;
    pending_t item;

    lock.get(1);

    // 事务被接受时只取出期望数据,真正比较时间由读接口延迟决定。
    if (accepted) begin
      if (expected.size() == 0)
        $fatal(1, "unexpected read: reference queue is empty");
      exp = expected.pop_front();
      item.due_cycle = rd_cycle + rd_latency;
      item.data = exp;
      pending.push_back(item);
    end

    // 即使本周期没有新读请求,也必须处理此前已经到期的比较项。
    while ((pending.size() != 0) &&
           (pending[0].due_cycle == rd_cycle)) begin
      item = pending.pop_front();
      if (actual !== item.data)
        $fatal(1, "data mismatch exp=%0h act=%0h", item.data, actual);
    end

    rd_cycle++;
    lock.put(1);
  endtask
endclass

fifo_scoreboard #(data_t) sb = new(RD_LATENCY);

clocking wr_cb @(posedge wr_clk);
  default input #1step;
  input rst_n, wr_en, full, din;
endclocking

clocking rd_cb @(posedge rd_clk);
  default input #1step;
  input rst_n, rd_en, empty, dout;
endclocking

// 复位通过同一个受保护对象原子清理状态,不替换共享句柄。
always @(negedge rst_n) begin
  sb.reset();
end

initial begin
  forever begin
    @(wr_cb);
    if (wr_cb.rst_n)
      sb.on_write(wr_cb.wr_en && !wr_cb.full, data_t'(wr_cb.din));
  end
end

initial begin
  forever begin
    @(rd_cb);
    if (rd_cb.rst_n)
      sb.on_read(rd_cb.rd_en && !rd_cb.empty, data_t'(rd_cb.dout));
  end
end
预期结果
正常场景下不触发 $fatal。
每个成功写事务只进入 expected 一次,每个成功读事务只取出一个期望值。
读数据在 RD_LATENCY 对应的采样周期到达时进行比较。
复位断言后,expected、pending 和读周期计数被同一次受保护操作清空。
该模型不会让“满时继续拉高 wr_en”或“空时继续拉高 rd_en”污染参考队列。复位激励应避免故意与活动时钟边沿落在完全相同的仿真时刻;若 DUT 使用异步断言、分域同步释放,还应使用各域的 reset-done 条件代替原始 rst_n 作为监视器重新工作的门控。
正确处理读数据延迟
不能假定 rd_en && !empty 成立的同一边沿上,dout 一定就是本次读事务的数据。组合读头、同步 RAM 和额外流水寄存器的可见时机不同,检查器若没有统一采样协议,就可能把旧值或下一项数据误判为当前读结果。
在本例中,RD_LATENCY=0 表示 clocking block 在当前读边沿前采到的 dout 就是即将被消费的数据;RD_LATENCY=1 表示当前接受的请求在下一读边沿前可观察;更深流水继续增加延迟。如果 DUT 提供明确的 dout_valid,应优先根据该有效信号完成比较,并让参考模型只负责维护事务顺序,而不是依赖固定周期数猜测数据何时有效。
覆盖频率、突发和复位组合
频率组合至少包含“写快读慢”和“写慢读快”,再加入连续写、连续读、随机停顿和读写交替。突发长度必须足以把 FIFO 占用量推向容量两端,否则随机测试可能长期只停留在中间水位,看不到真正的满空转换。
复位要覆盖空闲时和传输过程中两种场景。断言复位后,DUT 与参考模型都应丢弃复位前尚未完成的事务;释放后应等待写域和读域各自重新进入有效状态,再开始新的写读序列。原始复位信号拉高并不等价于两个域已经同时恢复工作。
验收满空边界
满边界要证明最后一个被接受的写入仍能按序读出,并且 full 有效期间的额外写请求不会破坏已有数据。空边界要证明最后一个有效数据能够正确返回,并且 empty 有效期间的额外读请求不会制造新的有效事务。
异步 FIFO 的 full 和 empty 通常依赖同步后的对端指针,因此状态解除可能比真实空间变化更晚,这种保守延迟可以降低瞬时吞吐,但不能导致溢出、欠读或顺序破坏。最终验收应确认接近满、接近空、满后继续写、空后继续读、不同频率、不同突发长度和复位恢复都被实际触发,并通过同一套无竞争参考模型。