
游戏引擎 / 系统课时
比较两个版本的帧时间
比较两个版本的帧时间
拿到两个构建的性能数据后,不能只比较一次平均 FPS。本节建立一套版本对比方法:先保证采样条件一致,再同时观察帧时间、CPU、GPU、内存和加载指标,并用统计量区分真实回归与正常波动。
学习目标
- 在相同采样条件下比较两个 Unreal 构建
- 用平均值、P95 等指标识别帧时间和线程耗时变化
- 联合 CPU、GPU、内存与加载指标判断回归方向
先保证两份数据真的可比
版本对比的第一步不是计算差值,而是检查采样条件。两个版本必须运行同一张测试地图、同一条 Sequence 路径、相同预热和采样区间,并使用相同机器、分辨率、画质、VSync 设置和构建类型。
如果其中一个版本在 Development 构建下采样,另一个使用 Shipping;或者一个版本包含首次加载资源,另一个版本已经完成缓存预热,那么结果只能说明测试条件不同,不能直接证明代码发生性能回归。
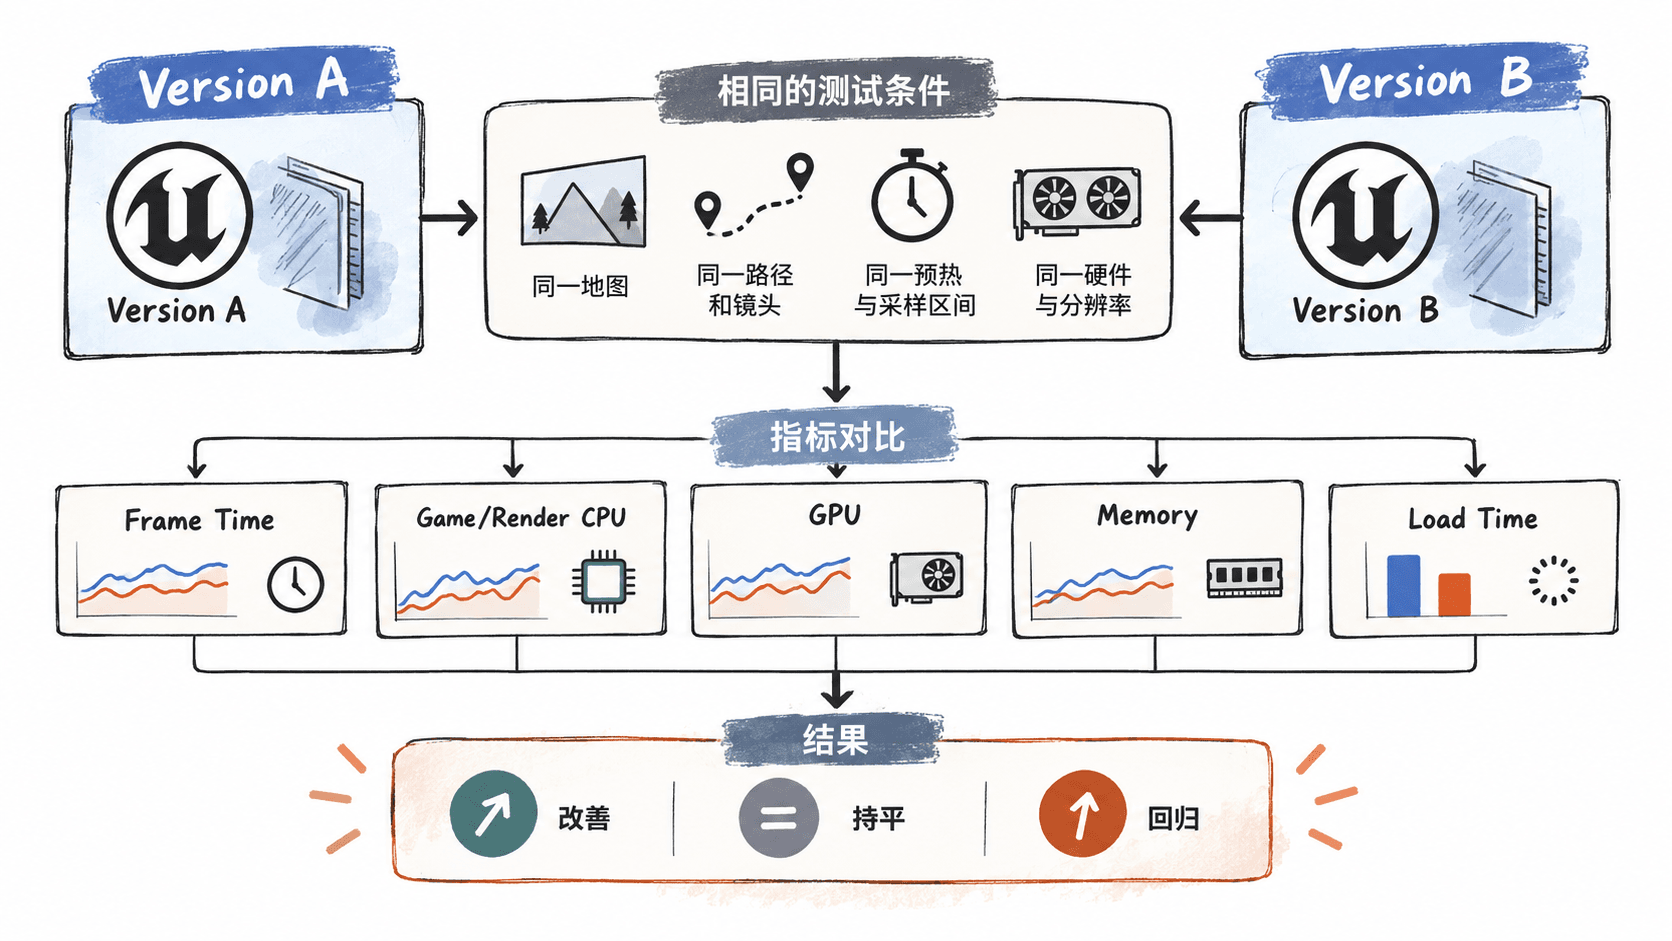
每次测试最好保留构建版本、提交号、机器标识和测试配置。这样出现异常时,能够回到原始数据确认差异究竟来自代码、资源还是测试环境。
不要用 FPS 掩盖帧时间问题
FPS 是帧时间的倒数,但优化分析通常更适合直接看毫秒。例如 60 FPS 对应约 16.67 ms,而 30 FPS 对应约 33.33 ms。使用帧时间后,CPU 与 GPU 各阶段的预算更容易直接比较。
平均帧时间仍然不足以描述卡顿。假设大多数帧都在 10 ms 左右,但少量帧突然达到 40 ms,平均值可能仍然很好看,玩家却能明显感觉到顿挫。因此版本回归至少应同时观察平均值与高分位数,例如 P95;需要分析更严重的尾部卡顿时,还可以增加 P99。
用统一摘要比较两个版本
实际项目可以从 Unreal Insights、CSV Profiler 或自己的自动化采集链路得到原始数据。由于不同项目启用的统计项并不完全一致,持续回归系统最好先把需要长期追踪的指标整理成自己的稳定摘要格式,再做版本比较。
下面的 compare_perf.py 比较两份项目自定义 JSON 摘要。字段分别表示帧时间平均值和 P95、Game Thread、Render Thread、GPU、峰值内存以及指定加载阶段耗时,单位全部固定在字段名中。
import json
import sys

METRICS = [
    "frame_mean_ms",
    "frame_p95_ms",
    "game_thread_ms",
    "render_thread_ms",
    "gpu_ms",
    "peak_memory_mb",
    "load_ms",
]


def load_summary(path: str) -> dict[str, float]:
    with open(path, "r", encoding="utf-8") as f:
        data = json.load(f)

    missing = [name for name in METRICS if name not in data]
    if missing:
        raise ValueError(f"missing metrics: {', '.join(missing)}")
    return data


def main() -> None:
    if len(sys.argv) != 3:
        raise SystemExit("usage: python compare_perf.py <baseline.json> <candidate.json>")

    baseline = load_summary(sys.argv[1])
    candidate = load_summary(sys.argv[2])

    print(f"{'metric':<20} {'baseline':>10} {'candidate':>10} {'change':>9}")
    for name in METRICS:
        old = float(baseline[name])
        new = float(candidate[name])
        change = 0.0 if old == 0 else (new - old) / old * 100.0
        print(f"{name:<20} {old:>10.2f} {new:>10.2f} {change:>8.1f}%")


if __name__ == "__main__":
    main()
例如准备如下基线数据 baseline.json:
{"frame_mean_ms":12.4,"frame_p95_ms":16.8,"game_thread_ms":7.1,"render_thread_ms":5.6,"gpu_ms":10.9,"peak_memory_mb":4210,"load_ms":1840}候选版本 candidate.json:
{"frame_mean_ms":13.1,"frame_p95_ms":19.2,"game_thread_ms":7.2,"render_thread_ms":5.7,"gpu_ms":12.5,"peak_memory_mb":4380,"load_ms":1810}执行:
python compare_perf.py baseline.json candidate.json预期输出:
metric                 baseline  candidate    change
frame_mean_ms             12.40      13.10      5.6%
frame_p95_ms              16.80      19.20     14.3%
game_thread_ms             7.10       7.20      1.4%
render_thread_ms           5.60       5.70      1.8%
gpu_ms                    10.90      12.50     14.7%
peak_memory_mb          4210.00    4380.00      4.0%
load_ms                  1840.00    1810.00     -1.6%
这个结果不能直接得出“整个版本变慢了”这样的结论,但它已经把调查方向收窄:P95 和 GPU 时间都上升约 14%,而 Game Thread 与 Render Thread 变化较小,因此应优先检查 GPU 相关变化,而不是先优化游戏线程。
联合指标判断瓶颈方向
帧时间变化要和子系统指标一起读。如果 Game Thread 明显上涨而 GPU 基本不变,可以继续在 Unreal Insights 中检查游戏线程事件、Actor Tick、物理或 Gameplay 逻辑;如果 GPU 时间同步上涨,则应进一步检查渲染 Pass、阴影、材质、后处理和可见物体变化。
内存增长也不能只看一个瞬时值。应固定测量时刻或统计区间,并区分稳定驻留增长与不断增长的泄漏迹象。加载时间同样必须明确边界,例如“从发起地图加载到目标地图可交互”,而不是版本 A 测整个启动流程、版本 B 只测关卡流送。
| 观察到的变化 | 优先调查方向 |
|---|---|
| Game Thread 上升,GPU 基本稳定 | Gameplay、Tick、物理、任务调度 |
| Render Thread 上升 | Draw Call 提交、场景代理、渲染线程工作量 |
| GPU 上升,CPU 线程稳定 | 阴影、材质、后处理、分辨率相关负载 |
| 峰值内存持续上升 | 资源驻留、对象生命周期、缓存与泄漏 |
| 加载时间上升 | IO、资源体积、解压、异步加载与初始化 |
这种对应关系只是定位入口,不是最终根因。一次资源改动可能同时增加 GPU 时间、显存压力和加载耗时,因此仍需要回到时间线或具体资源继续确认。
用多轮数据决定是否触发回归
自动化系统不应因为单轮数据高出 2% 就立刻判定失败。先在同一构建上连续运行若干轮,观察自然波动范围,再根据项目的性能预算制定阈值。对用户体验敏感的 P95 帧时间,可以设置比平均帧时间更严格的关注规则;对内存和加载耗时则使用各自独立的预算。
更重要的是保存原始数据而不只保存“通过/失败”。当某个版本越过阈值时,开发者应能查看基线、候选版本、多轮分布以及对应 Unreal Insights 或 CSV 捕获,再判断差异来自代码、资源还是环境噪声。这样版本回归系统才是定位工具,而不是只会制造红灯的报警器。