
游戏引擎 / 系统课时
服务器为什么会掉 Tick
服务器为什么会掉 Tick
多人服务器“掉 Tick”本质上是一次服务器更新循环无法在目标时间预算内完成。并发玩家增加后,Game Thread 需要处理更多移动、Actor Tick、AI、物理和复制准备工作;当单次循环持续超过预算,下一次 Tick 只能延后,客户端就会感到状态更新变稀、抖动或延迟增大。
学习目标
- 用目标 Tick Rate 换算单次服务器更新的时间预算。
- 判断掉 Tick 是 Game Thread 过载,还是网络带宽、I/O 等其他问题。
- 按玩家数和工作量增长关系定位最值得优化的服务器路径。
Tick 预算是最先看的边界
假设目标服务器 Tick Rate 为 30 Hz,每次更新大约只有 ms。若 Game Thread 一次循环经常需要 40 ms,服务器就不可能稳定按 30 Hz 完成更新;即使网络带宽还有余量,Tick 也会下降。
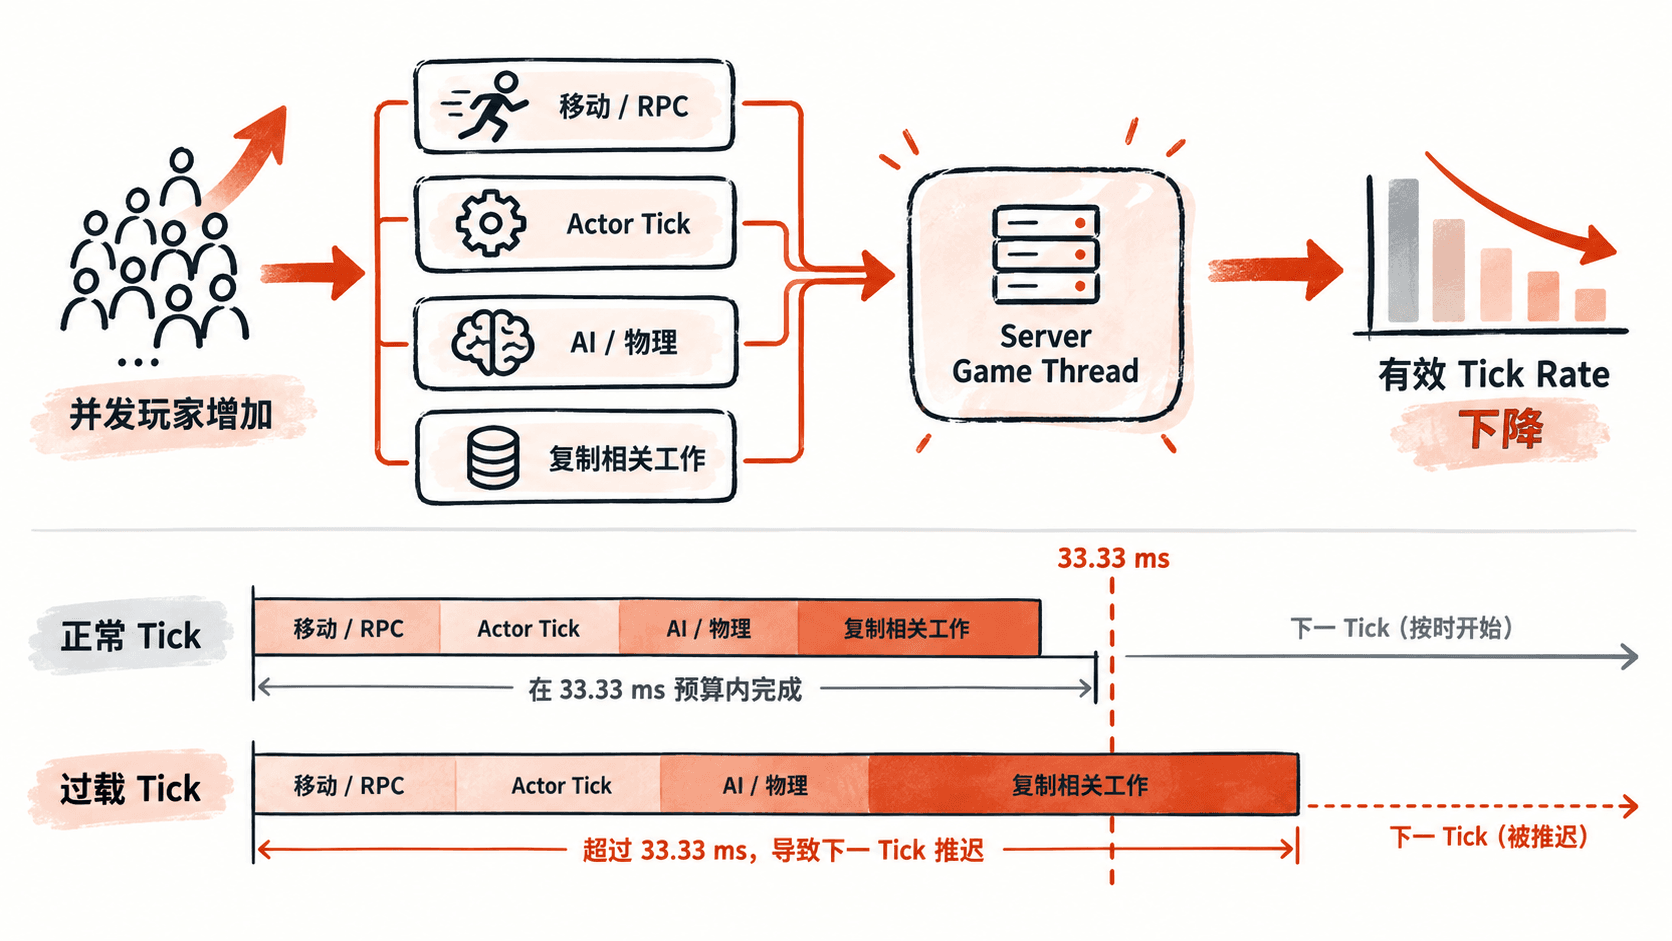
并发玩家与 CPU 成本通常不是简单线性关系。每个玩家除了自己的 Pawn,还可能扩大相关 Actor 集、移动更新、RPC、AI 激活范围和复制检查量;某些系统会随“玩家 × 相关对象数”一起增长。因此,服务器从 20 人升到 40 人时,Game Thread 成本可能不只是翻倍某一个函数。
先证明是 CPU Tick 过载
不要看到客户端延迟就直接认定“服务器掉 Tick”。网络拥塞、丢包、队列积压和服务器 CPU 超预算都会制造相似体验。最可靠的顺序是先看服务器帧/线程时间,再看网络。
对 Dedicated Server,推荐直接采集 Unreal Insights CPU 与 Frame trace。以下以 Windows 服务器程序和本机 Insights 为例,实际可执行文件路径可能不同。
& "<PATH>\MyProjectServer.exe" -log -trace=cpu,frame -tracehost=127.0.0.1预期结果
服务器启动并向本机 Trace 服务发送会话;Unreal Insights 中可看到 Frame 与 CPU Timing 轨迹。如果服务器 Tick 变慢的时间段里 Game Thread 持续超过目标预算,就已经证明核心矛盾在 CPU 更新循环。随后再放大该区间,看最宽、最频繁的 CPU timer,并比较它们在低并发与高并发场景下的调用次数和总耗时。
用玩家阶梯测试找增长项
一次只压到最大人数,很难判断成本从哪里开始失控。更有效的方法是固定地图和机器人行为,按 10、20、40、60 玩家这样的阶梯分别采样同样时长,并记录 Game Thread 平均值、P95、P99 与目标预算的距离。
若某个 timer 的单次耗时差不多,但调用次数随玩家数快速上升,问题通常是规模;若调用次数稳定但单次耗时突然变长,要继续找锁竞争、缓存失效、路径复杂化或 I/O 等原因。优化对象应该是“随并发增长最快且占据主要预算”的路径,而不是单纯选择名字看起来最复杂的系统。
对于 Actor Tick,可检查是否所有对象都必须每 Tick 更新;对于 AI 和物理,可降低不重要对象的更新频率或缩小活跃范围;对于复制相关 CPU,可减少无意义的状态变化、缩小相关对象集合,并避免高频发送可由客户端推导的信息。每次只改一个主要变量,再用同一并发阶梯复测。
不要把网络问题和掉 Tick 混成一个指标
服务器 Game Thread 仍在预算内,但客户端仍出现延迟时,应转向网络指标:带宽是否接近上限、包是否持续积压、RPC 是否过密、复制数据量是否异常。反过来,即使网络流量正常,只要 Game Thread 长期超出 33.33 ms,30 Hz 目标也无法稳定维持。
因此验收不能只看“在线人数达到多少”。更可操作的标准是:在目标并发、固定场景和固定测试时长下,服务器 Game Thread 的 P95/P99 仍留在 Tick 预算内,同时网络吞吐和包行为没有出现持续恶化。这样才能区分“服务器算不动”与“服务器发不动”,并把优化投入到真正限制 Tick 的那条路径上。