
图形渲染与 Shader / 系统课时
移动端 Shader 为什么更怕带宽
移动端 Shader 为什么更怕带宽
移动 GPU 经常不是“算不动”,而是大量像素、纹理和中间缓冲需要在有限内存带宽中搬运数据。本节把分辨率、纹理格式和渲染目标放到同一条数据链路里,理解为什么桌面端看似轻松的效果到了手机上会明显变贵。
学习目标
- 能解释分辨率、像素格式和读写次数如何共同决定带宽压力。
- 能识别全屏采样、多中间缓冲和高精度格式带来的额外数据搬运。
- 能从降低数据量和减少往返读写两个方向优化移动端 Shader。
带宽瓶颈本质是搬了多少数据
Shader 的 ALU 指令负责计算,而纹理、深度缓冲和颜色缓冲需要在 GPU 的缓存、片上存储与显存之间传递。移动设备受功耗、封装和共享内存架构限制,可持续使用的内存带宽通常比高端桌面 GPU 更紧张,因此大量读写更容易直接拖慢一帧。
可以用一个简化估算建立直觉:一个渲染目标每帧的数据量近似为“宽 × 高 × 每像素字节数”。如果它既被写入又被后续 Pass 读取,还要把对应的数据访问次数继续乘进去。
例如 1920×1080 的 RGBA8 缓冲,每像素 4 字节,仅保存一份像素数据就约为 7.9 MiB。若一帧中先写入一次、随后全屏读取一次,理论数据流量已经翻倍,而且这里还没有计算深度、其他纹理、缓存失效和额外 Pass。
分辨率会同时放大所有全屏成本
全屏后处理尤其容易暴露带宽问题,因为 Shader 会覆盖几乎所有屏幕像素。分辨率从 1920×1080 提升到 2560×1440,像素数量不是增加约三成,而是从约 207 万增加到约 369 万,所有逐像素读取和写入都会一起增长。
因此移动端常见的动态分辨率、半分辨率 Bloom、低分辨率 SSAO,本质上都在减少需要搬运的数据量。一个效果如果可以在半宽半高缓冲上工作,像素数量只有全分辨率的四分之一,往往比只删几条简单算术指令更有效。
格式决定每个像素有多重
相同分辨率下,像素格式直接决定一次读写涉及多少字节。RGBA8 通常是 4 字节每像素,而四通道 16 位浮点格式通常达到 8 字节每像素。如果一个中间缓冲并不需要 HDR 范围,却仍使用更宽的格式,就会增加显存占用和读写流量。
格式选择不能只追求最小字节数,还要确认数值范围、精度、混合和平台支持是否满足需求。法线、遮罩、光照累积和最终颜色对精度的要求并不相同,应分别选择,而不是让所有 Render Target 都使用同一种高精度格式。
下面的 GLSL ES 片段展示了一个典型全屏 Pass。代码本身只有一次纹理采样,但它会对整个渲染目标的每个片元执行,因此分辨率和源纹理格式会直接放大总访问量。该代码属于片段示例,需要宿主程序提供 sourceTexture 与纹理坐标。
#version 300 es
precision mediump float;

uniform sampler2D sourceTexture;
in vec2 vUv;
out vec4 fragColor;

void main() {
    vec3 color = texture(sourceTexture, vUv).rgb;
    fragColor = vec4(color, 1.0);
}
在 1920×1080 目标上,这段 Shader 每帧会执行约 207 万个片元。若源纹理和输出目标都是 RGBA8,一次完整读取与一次完整写入就需要处理两份全屏像素数据;实际 GPU 流量还会受缓存、压缩和架构影响,因此不能把这个估算直接当作真实显存总线读数。
中间缓冲会让数据来回搬
多 Pass 效果通常先把结果写入一个中间 Render Target,再让下一 Pass 读取。如果依次执行亮度提取、横向模糊、纵向模糊、合成,就会产生多轮全屏读写。每增加一个中间目标,不只是多占一块显存,还可能增加一次完整写入和后续读取。
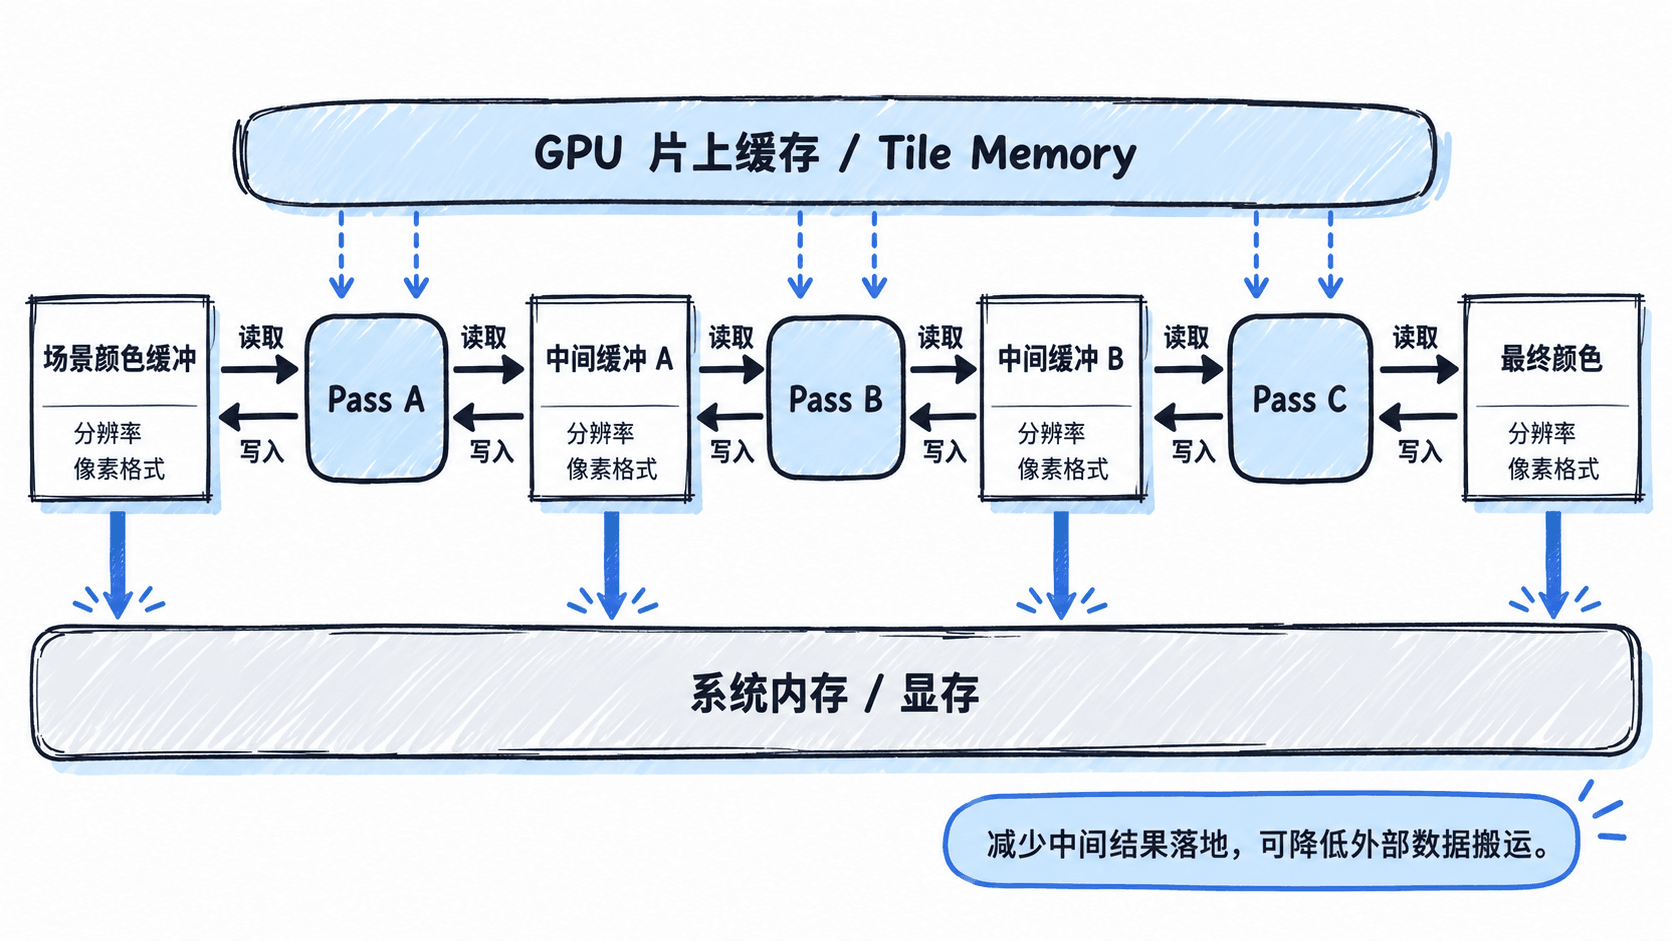
采用 Tile-Based Rendering 的移动 GPU 会尽量在片上完成一部分工作,但这并不意味着中间缓冲可以无限增加。Render Pass 被切断、需要采样前一个目标、执行额外拷贝或使用无法保留在片上的数据时,仍可能发生外部内存访问。
优化先减少字节和往返次数
遇到移动端 GPU 带宽瓶颈时,可以优先检查三件事:全屏效果是否必须使用当前分辨率,中间缓冲是否真的需要当前像素格式,以及连续 Pass 是否存在可以合并或避免落地的结果。它们都直接作用于数据量,而不只是源代码长度。
例如 Bloom 模糊允许降低分辨率时,先缩小处理目标通常比优化几个乘法更有价值;只保存单通道遮罩时,也没有必要使用四通道高精度颜色缓冲。若多个计算可以在同一次 Pass 内完成,还可以减少一次中间目标写入和再次读取。
移动端 Shader 的带宽优化可以归结为两个问题:每个像素要搬多少字节,以及同一份数据一帧要搬几次。分辨率、格式和中间缓冲正是这两个问题最直接的控制点。