
图形渲染与 Shader / 系统课时
GPU 为什么能并行执行 Shader
GPU 为什么能并行执行 Shader
Shader 之所以适合 GPU,不是因为单次计算特别复杂,而是因为屏幕上存在大量结构相似、彼此相对独立的顶点和像素任务。理解 GPU 如何把这些任务成批执行,可以解释为什么 Shader 擅长吞吐大量数据,也能理解分支、邻近像素和线程间依赖带来的限制。
学习目标
- 理解大量 Shader Invocation 如何被组织并行执行
- 区分 GPU 的 SIMD/SIMT 风格执行与 CPU 顺序执行思维
- 识别动态分支和跨像素依赖对并行效率的影响
为什么 Shader 天然适合并行
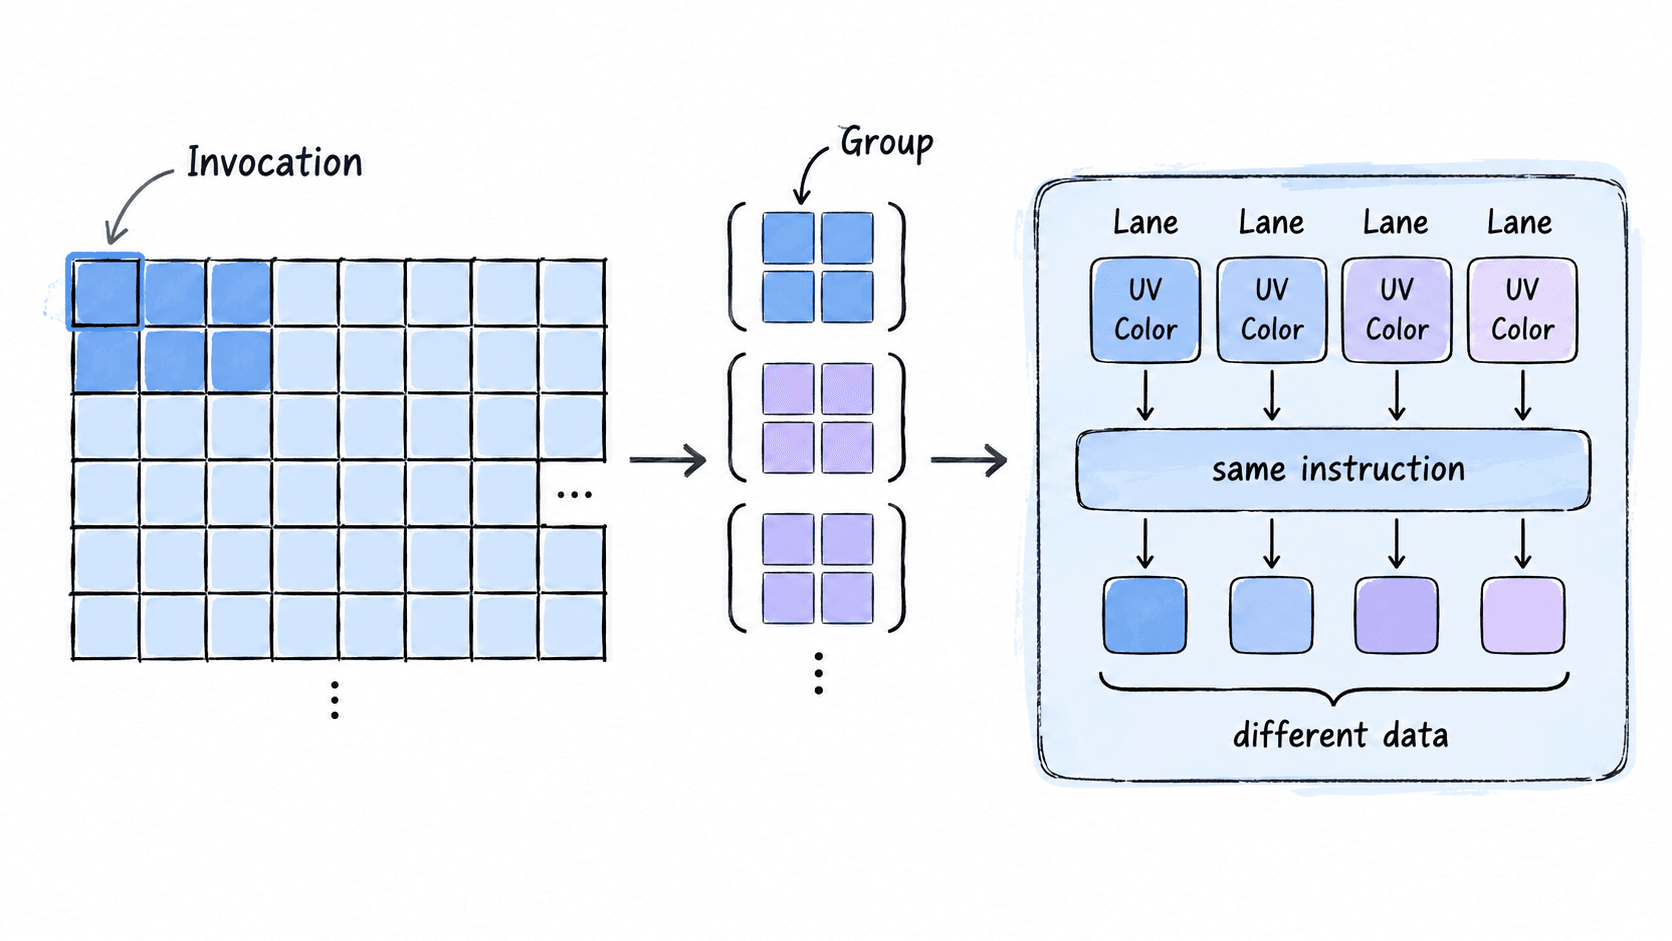
以片元着色为例,一个 1920×1080 的画面可能产生数百万个片元任务。每个任务通常读取自己的插值数据、纹理和常量,然后独立计算颜色。任务执行的是同一段 Shader,只是输入数据不同,因此 GPU 可以同时调度大量相似计算。
GPU 不需要先算完左上角像素,再计算它右边的像素。只要数据依赖允许,大量 Shader Invocation 可以同时处于执行状态,这种以吞吐量为目标的设计正适合渲染工作负载。
SIMD 风格执行意味着什么
现代 GPU 的具体硬件术语因厂商而异,但编程时可以把一组相邻执行单元理解为:多个 lane 在同一时间推进相同或相近的指令,每个 lane 处理自己的数据。这常被描述为 SIMD 或 SIMT 风格执行。
因此 Shader 最舒服的工作模式是“大量线程走相似控制流”。下面的片元 Shader 根据 UV 左右两侧返回不同颜色,它能表达正确结果,但也展示了动态分支可能造成的执行分歧。
片段示例,需要由渲染管线提供插值后的 UV,并作为像素着色阶段执行:
float4 PSMain(float2 uv : TEXCOORD0) : SV_Target
{
    // 相邻像素若落在分支两侧,同一执行组可能出现不同控制流。
    if (uv.x < 0.5)
    {
        return float4(1.0, 0.2, 0.2, 1.0);
    }

    return float4(0.2, 0.4, 1.0, 1.0);
}
验证时把该 Shader 绘制到覆盖屏幕的矩形上:画面左半部分应为偏红色,右半部分应为偏蓝色。具体是否产生明显性能损失取决于硬件、编译器以及同一执行组内实际发生的分支分歧,不能仅看到 if 就认定它一定很慢。
分支为什么可能降低利用率
假设同一执行组中的一部分 lane 进入 if,另一部分进入 else。硬件必须保证两条路径都得到正确结果,一种常见执行效果是先让满足条件的 lane 工作,再让另一部分 lane 工作,而暂时屏蔽不属于当前路径的 lane。
这意味着执行组仍在推进指令,但部分计算资源暂时没有产生有效结果。相邻像素通常具有相近数据,因此完全一致的分支并不一定昂贵;真正需要警惕的是同一执行组内部高度不规则的数据相关分支。
相邻像素并行带来的约束
普通片元 Shader 应把当前 invocation 看成一次独立计算,不要假设“左边像素已经算完,所以我可以直接读取它刚写出的结果”。相邻任务可能同时执行、顺序不确定,甚至处于不同执行组。
如果算法确实需要线程之间共享结果或同步,例如 Compute Shader 中的分块计算,应使用该阶段提供的线程组共享内存、同步原语等机制,而不是依赖看似自然的屏幕顺序。渲染算法只有在数据依赖明确受控时,GPU 的大规模并行能力才能真正转化为高吞吐量。