
图形渲染与 Shader / 系统课时
Shader 慢在哪里:ALU 还是纹理
Shader 慢在哪里:ALU 还是纹理
Shader 变慢不能只看代码行数。相同的像素着色器,可能卡在算术吞吐、纹理采样延迟,也可能真正受限于显存带宽。本节建立一套从现象到验证的定位方法,让你能针对瓶颈减少正确的成本,而不是盲目删计算或降低贴图数量。
学习目标
- 区分 ALU、纹理采样和显存带宽三类常见 GPU 压力
- 通过替换实验判断 Shader 更接近哪种瓶颈
- 避免仅凭指令数或纹理数量下性能结论
三类成本并不是一回事
ALU 指加减乘除、点积、归一化、插值和部分特殊函数等算术工作。纹理采样则要经过坐标计算、纹理单元、缓存与显存访问。带宽压力关注的是单位时间搬运了多少数据,例如读取高分辨率纹理、写入多个渲染目标或频繁读写大尺寸缓冲区。
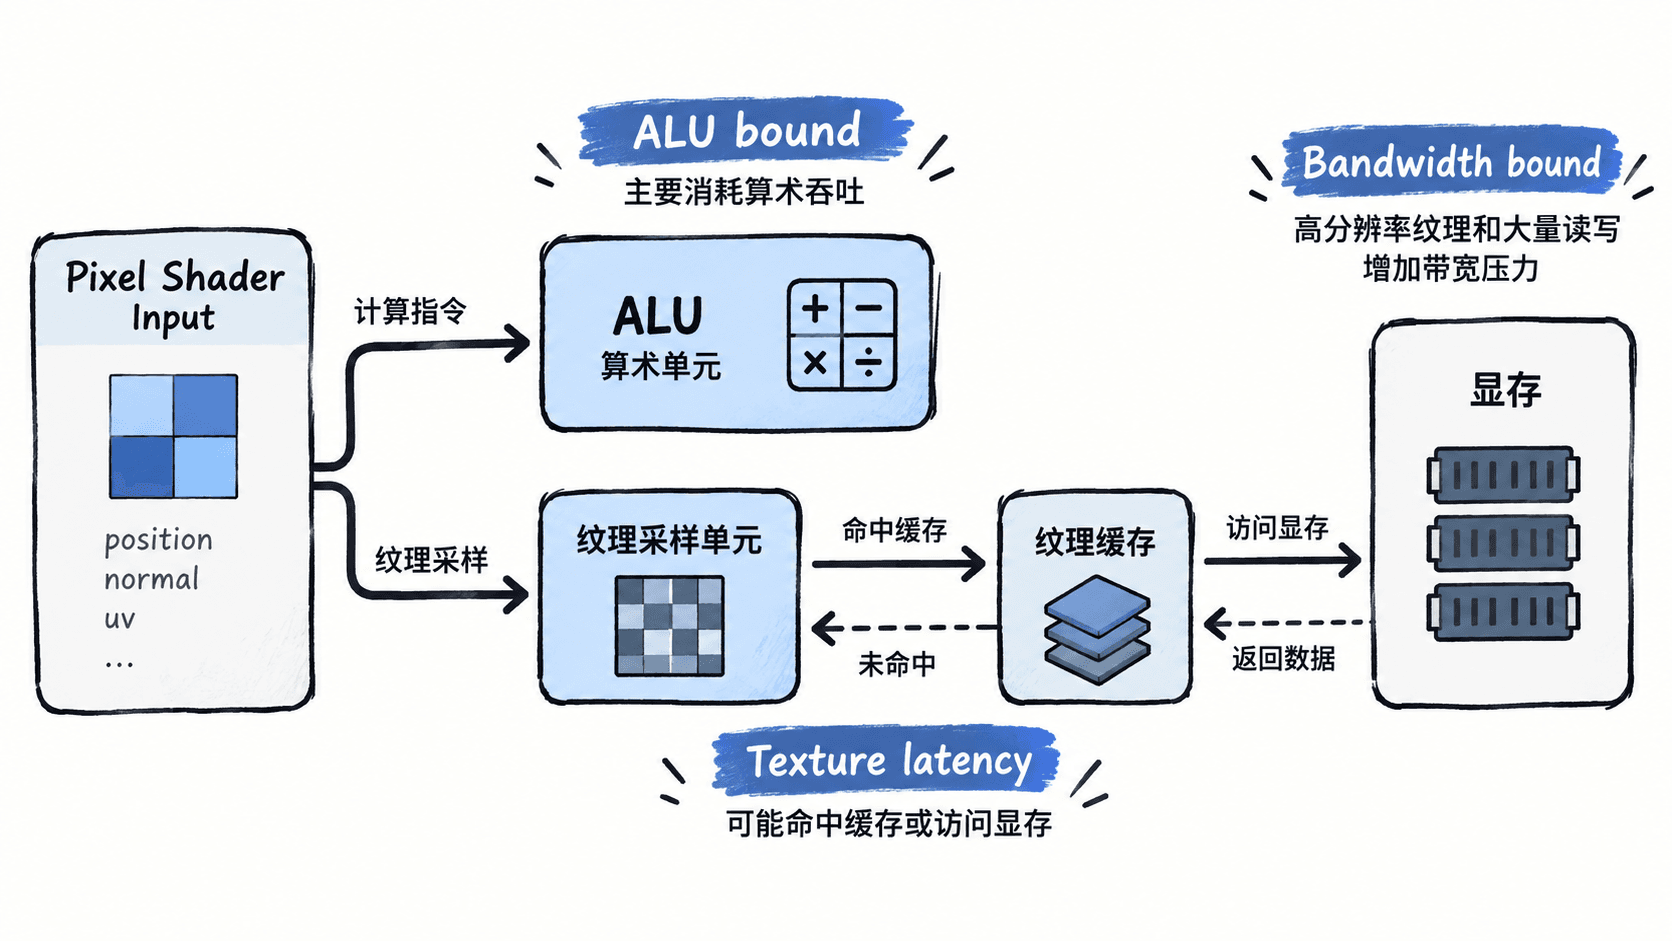
三者还能互相掩盖。例如纹理访问存在延迟时,GPU 可以穿插执行其他算术指令,因此增加少量 ALU 不一定增加帧时间。反过来,如果算术单元已经接近饱和,再增加复杂光照计算就更容易直接拉长执行时间。
用替换实验判断瓶颈
最实用的方法不是猜,而是一次只减少一种成本并观察 GPU 时间。下面是 HLSL 片段示例,假设材质原本要采样底色和法线纹理,再进行光照计算;它依赖引擎提供的纹理、采样器和输入结构,不能单独编译运行。
float4 ShadePixel(float2 uv, float3 lightDir)
{
    float3 baseColor = BaseMap.Sample(BaseSampler, uv).rgb;
    float3 normal = NormalMap.Sample(NormalSampler, uv).xyz * 2.0 - 1.0;

    // 用一组算术运算模拟材质中的光照计算。
    normal = normalize(normal);
    float ndotl = saturate(dot(normal, normalize(lightDir)));
    float3 lit = baseColor * (0.15 + ndotl * 0.85);

    return float4(lit, 1.0);
}
预期结果:正常材质同时包含两次纹理采样和一组光照运算。接下来分别制作测试版本:先保持采样不变并把复杂光照替换为常量,再保持主要算术结构但用常量替代纹理采样。每次只改变一个变量,并在相同场景、分辨率和相机位置下比较 GPU 时间。
如果大幅减少算术后 GPU 时间明显下降,而移除纹理采样变化较小,说明当前负载更偏向 ALU。若减少采样或降低纹理读取成本收益明显,则要继续检查纹理延迟、缓存命中和带宽,而不是继续删数学运算。
纹理慢还要区分延迟与带宽
纹理采样多并不等于一定带宽不足。重复读取附近纹素可能获得很高的缓存命中率,此时成本更多体现在采样单元吞吐或等待延迟。相反,大纹理、低局部性访问、多层高精度纹理和多个渲染目标,会更容易把压力推向显存带宽。
一个常见验证方法是临时降低纹理分辨率或精度。如果画面流程不变,仅减少数据量后 GPU 时间明显下降,带宽或缓存压力值得重点调查。如果变化很小,则应继续查看采样次数、过滤模式以及 Shader 中是否还有更强的其他瓶颈。
优化必须对准真正受限的资源
ALU 受限时,应先减少重复计算、昂贵函数和不必要的高精度运算;纹理采样受限时,优先减少无价值采样、改善访问局部性或合理合并数据;带宽受限时,则更应关注纹理格式、分辨率、渲染目标数量和读写的数据规模。
性能优化的关键不是让 Shader 看起来更短,而是通过受控实验确认哪种 GPU 资源真正限制了执行时间,再针对那一类资源降低成本。