
图形渲染与 Shader / 系统课时
动态分支什么时候真的昂贵
动态分支什么时候真的昂贵
GPU Shader 中的 if 并不天然昂贵。真正的问题通常出在线程发散:同一执行组里的线程选择不同分支后,GPU 可能需要分别执行两条路径,并屏蔽暂时不属于当前路径的线程。本节用执行模型判断哪些分支值得担心,以及怎样验证分支是否真的拖慢 Shader。
学习目标
- 理解 GPU 并行执行中的分支发散及其成本来源
- 判断均匀分支与像素级动态分支的差异
- 通过对照测试验证条件分支是否值得优化
成本来自同组线程走了不同路径
GPU 会把多个线程组织成执行组并以相近节奏运行。不同硬件对这种执行组有不同名称和宽度,但理解性能时只需要抓住一点:同组线程如果判断结果一致,可以只执行被选择的路径;如果一部分走 if、另一部分走 else,两条路径都可能需要执行。
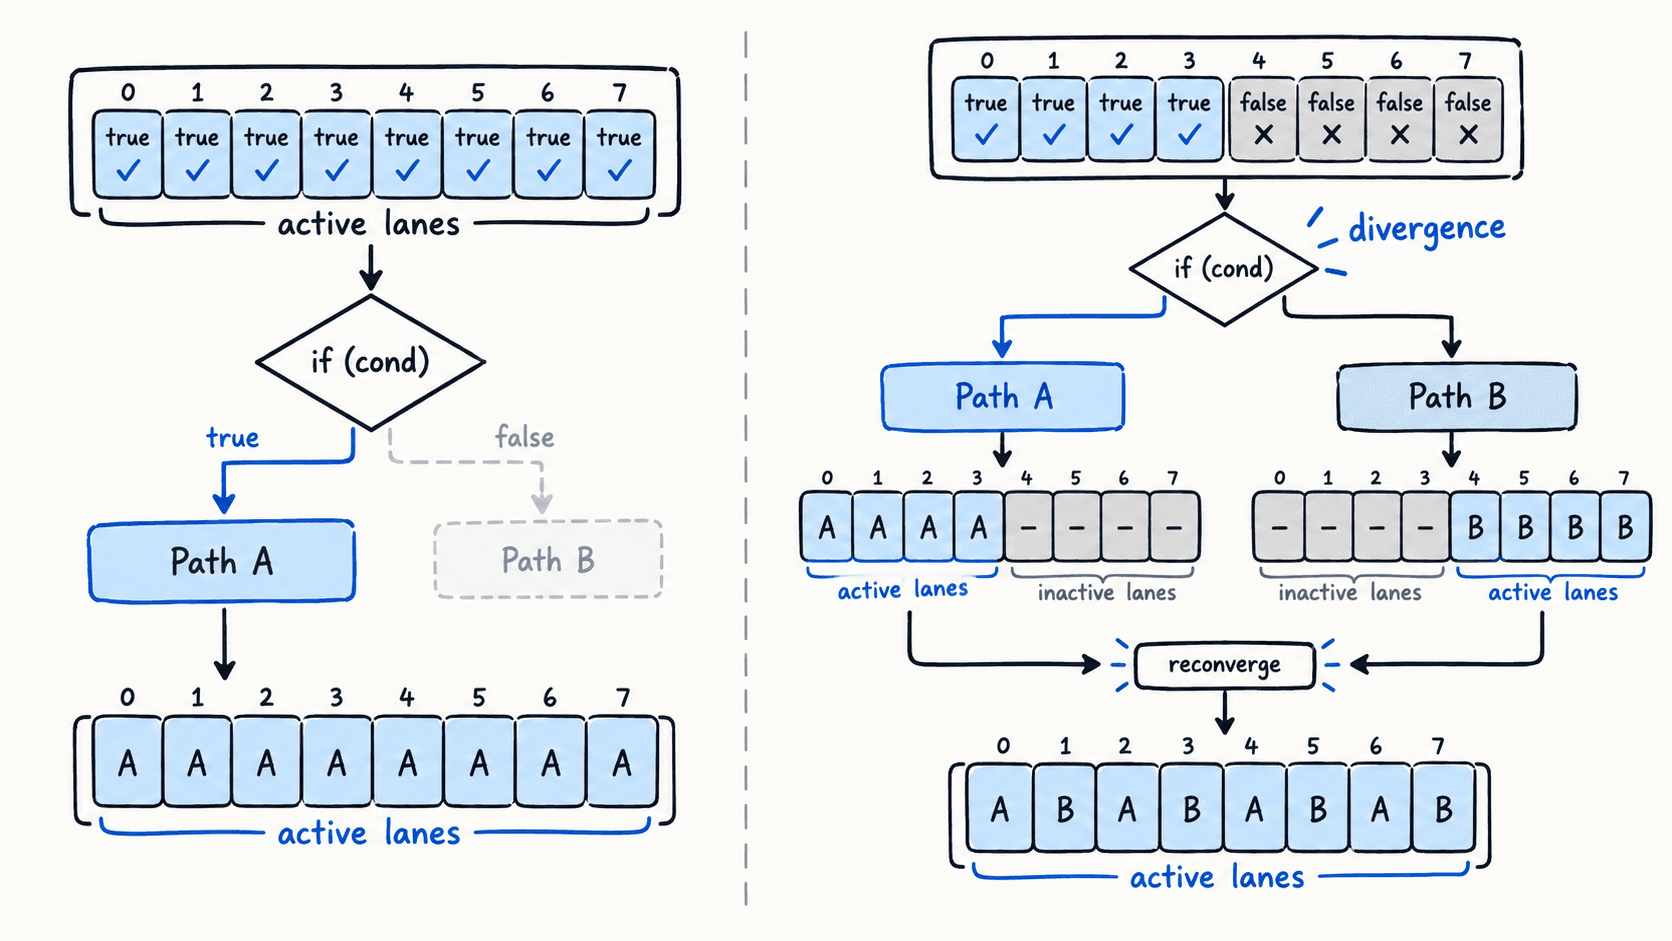
因此,动态分支的危险程度取决于条件在空间上是否一致,以及分支两边各自有多重。一个由整批绘制统一控制的条件,通常比根据每个像素噪声、纹理值或随机结果决定的条件更容易保持一致。
看两个条件就能理解差异
下面是 HLSL 片段示例。它依赖引擎传入的材质参数与像素输入,不能独立运行,但可以直接对比两类条件的行为。
float3 ShadePixel(float3 normal, float3 baseColor, float detailMask, bool enableDetail)
{
    float3 n = normalize(normal);
    float lighting = saturate(n.z) * 0.8 + 0.2;
    float3 color = baseColor * lighting;

    // enableDetail 通常对整批像素一致,较容易形成一致分支。
    if (enableDetail)
    {
        color *= 1.08;
    }

    // detailMask 若逐像素变化,边界区域更容易产生线程发散。
    if (detailMask > 0.5)
    {
        color = sqrt(saturate(color));
    }

    return color;
}
预期结果:当 enableDetail 对同一次绘制中的像素保持一致时,同组线程通常选择同一路径,不需要同时承担两侧分支。detailMask 如果来自纹理并在相邻像素间频繁跨过 0.5,同一执行组就更可能同时出现 true 和 false,从而产生发散。
这里不能仅从源码断言第二个分支一定更慢。编译器可能把很短的条件改写成无分支选择,硬件也可能用不同策略执行,因此最终仍要结合编译结果和 GPU 计时验证。
哪些分支最值得警惕
像素级条件在屏幕上形成细碎、高频变化时,最容易让相邻线程作出不同选择。典型例子包括噪声阈值、棋盘状遮罩、粒度很细的材质分类,以及依据复杂纹理数据进入完全不同的计算路径。
分支内部的工作量同样重要。两边如果只有一两次简单运算,即使发生发散,额外成本也可能很小;如果一边包含多次纹理采样、循环或复杂光照,另一边也有大量计算,那么同时执行两条路径的代价就更明显。
用对照版本而不是经验规则判断
定位时可以准备三个版本:保留原动态分支、强制所有线程走路径 A、强制所有线程走路径 B。保持场景和输入一致后比较 GPU 时间。如果原版本接近两条路径成本之和,而单一路径明显更快,说明发散很可能正在吞噬收益。
还可以改变条件的空间分布做验证。例如让原本细碎变化的遮罩暂时变成大面积连续区域。如果视觉覆盖比例大致相近,但连续区域版本明显更快,说明性能差异与线程一致性高度相关,而不只是 true 和 false 的像素数量。
分支优化先看一致性再看语法
适合保留的分支通常具有两个特征:同一执行组里的条件较一致,而且跳过的工作足够昂贵。需要重点处理的则是高频发散、分支两侧都很重、并且处于高覆盖率像素阶段的条件判断。
实际优化时,优先改变数据组织和条件分布,让相邻像素更可能走同一路径;只有在测量确认分支成本显著后,才考虑改写成无分支表达式。动态分支是否昂贵不是 if 语法本身决定的,而是由线程一致性、分支工作量和具体 GPU 执行方式共同决定。