
图形渲染与 Shader / 系统课时
顶点 Shader 和片元 Shader 分工
顶点 Shader 和片元 Shader 分工
顶点 Shader 与片元 Shader 都能做数学计算,但它们面对的数据规模和可获得的信息不同。正确分工的关键不是“哪边都能写”,而是判断计算是否依赖每个像素的细节,以及结果能否安全地从顶点插值到片元。
学习目标
- 区分顶点 Shader 与片元 Shader 的输入、输出和执行频率
- 判断某段计算更适合按顶点执行还是按片元执行
- 理解插值为什么既能节省计算,也可能带来视觉误差
两个阶段处理的数据粒度不同
顶点 Shader 以顶点为工作单位,常见输入包括模型空间位置、法线、切线、UV、顶点色和蒙皮权重。它通常负责坐标变换、蒙皮、顶点动画,以及准备后续片元阶段需要插值的数据。
片元 Shader 以光栅化生成的片元为工作单位,常见输入是顶点 Shader 输出经过插值后的属性,以及纹理、材质参数等资源。它更适合执行纹理采样、逐像素光照、法线贴图、透明度判断等依赖屏幕细节的工作。
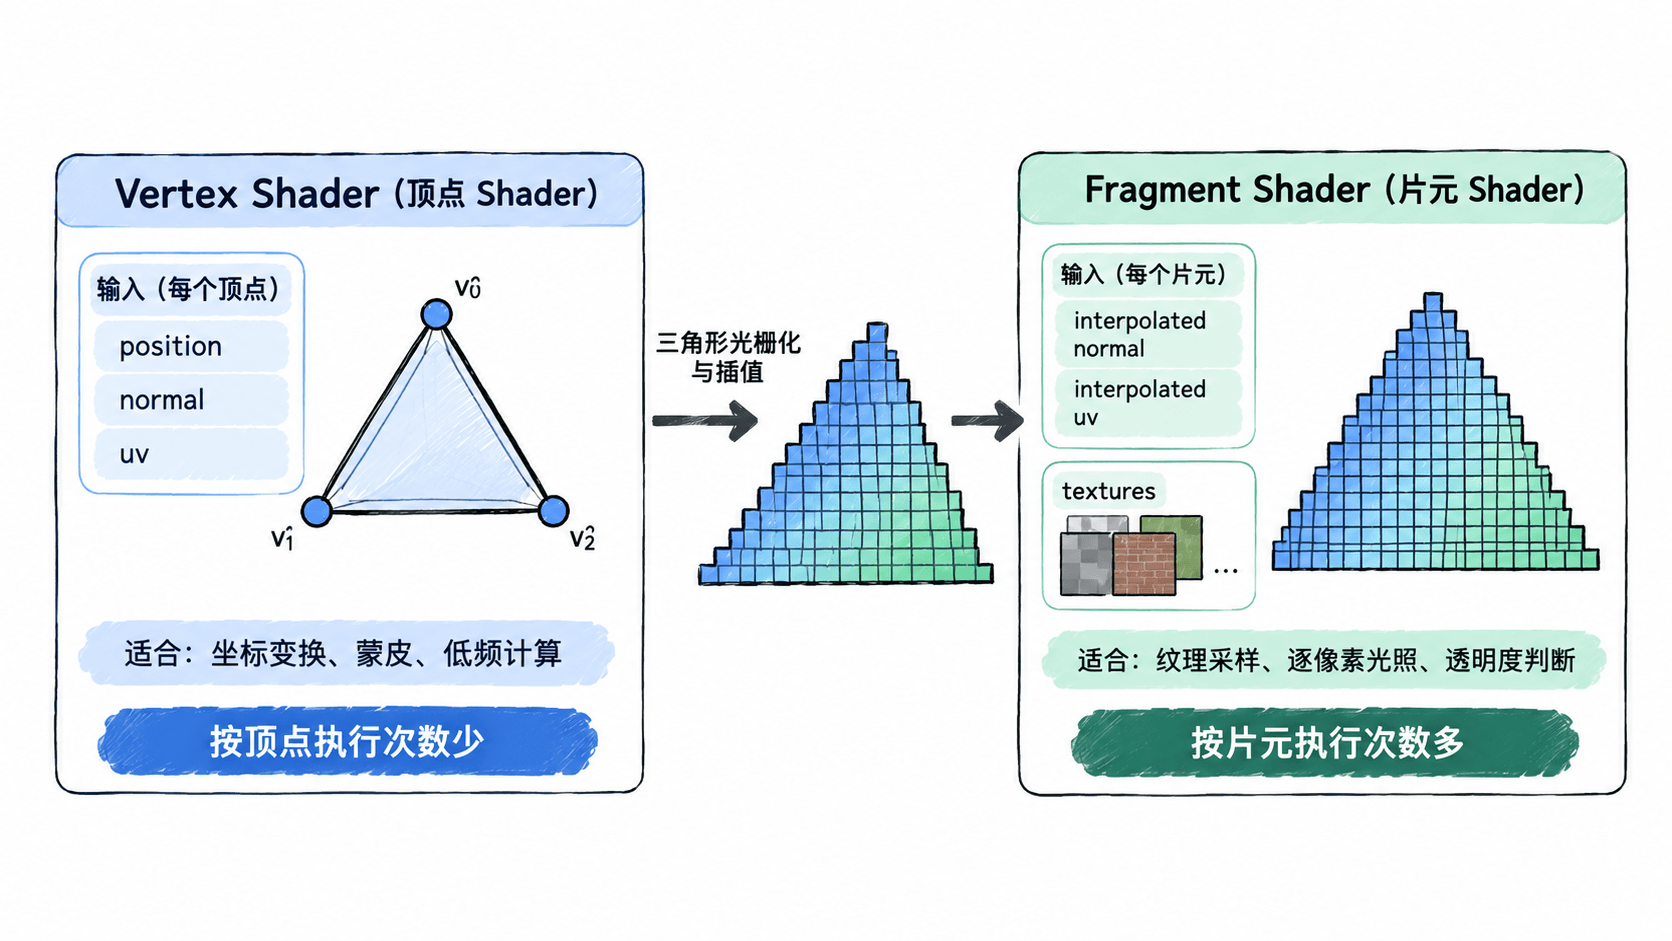
能插值的结果可以提前算
如果某个值只随顶点平滑变化,并且线性插值后的结果足够准确,就可以优先在顶点 Shader 计算,再把结果传给片元 Shader。这样能减少高分辨率画面中的重复计算。
下面的 HLSL 片段把世界空间法线先在顶点阶段变换,再传给片元阶段。它依赖宿主程序提供矩阵并完成管线绑定,因此属于片段示例。
cbuffer ObjectBuffer {
    float4x4 modelViewProjection;
    float3x3 normalMatrix;
};

struct VSInput {
    float3 position : POSITION;
    float3 normal : NORMAL;
};

struct VSOutput {
    float4 position : SV_POSITION;
    float3 worldNormal : TEXCOORD0;
};

VSOutput VSMain(VSInput input) {
    VSOutput output;
    output.position = mul(modelViewProjection, float4(input.position, 1.0));

    // 法线在顶点阶段变换,片元阶段接收插值结果
    output.worldNormal = mul(normalMatrix, input.normal);
    return output;
}

float4 PSMain(VSOutput input) : SV_Target {
    float3 n = normalize(input.worldNormal);
    return float4(n * 0.5 + 0.5, 1.0);
}
生效后,模型表面会以 RGB 显示归一化后的世界空间法线方向。即使法线在顶点阶段已经计算过,片元阶段仍要再次 normalize,因为插值后的向量长度通常不再等于 1。
依赖像素细节的计算必须留在片元阶段
纹理采样通常需要片元级 UV,法线贴图需要当前片元对应的纹理法线,镜面高光也可能对视线方向和法线变化非常敏感。把这类计算提前到顶点阶段,会让低面数模型出现明显的块状或失真。
一个实用判断是:如果三角形内部的真实结果并不能由三个顶点结果平滑近似,就不要只在顶点阶段算。例如用三角形三个顶点分别计算高光强度再插值,可能直接丢失本应出现在三角形中央的高光峰值。
性能优化不是简单地把代码往前搬
顶点阶段执行次数通常更少,因此把可插值的重复计算前移,常常能降低成本;但代价是插值精度和可表达性。片元阶段虽然更贵,却能获得更细的屏幕空间结果,并能访问纹理采样、导数等与片元相关的信息。
实际优化时先确认瓶颈,再决定迁移计算。一个阶段代码更短,并不代表整个 GPU 更快;增加顶点输出还会提高插值寄存器和带宽压力。最稳妥的分工原则是:几何变换和低频变化尽量放顶点阶段,依赖纹理与细节的高频变化保留在片元阶段。