
图形渲染与 Shader / 系统课时
减少采样次数从哪里下手
减少采样次数从哪里下手
当 Shader 的纹理访问成为主要成本时,最有效的优化通常不是删掉几行算术,而是减少真正发生的纹理采样。本节从通道合并、邻域缩小和结果复用三个入口出发,把“少采样”落实为可检查的代码改动。
学习目标
- 能区分纹理采样次数与纹理数量,找到真正增加访问成本的位置。
- 能通过通道打包、缩小邻域和复用采样结果减少纹理访问。
- 能在优化后验证采样数量,同时避免因为减少采样而破坏画面效果。
先把一次采样看清楚
纹理采样不是简单读取一个变量。GPU 需要计算纹理坐标、选择 mip、访问纹理缓存并取得过滤后的结果,因此同一像素中重复执行 texture() 或引擎提供的采样宏,会形成真实的纹理访问成本。
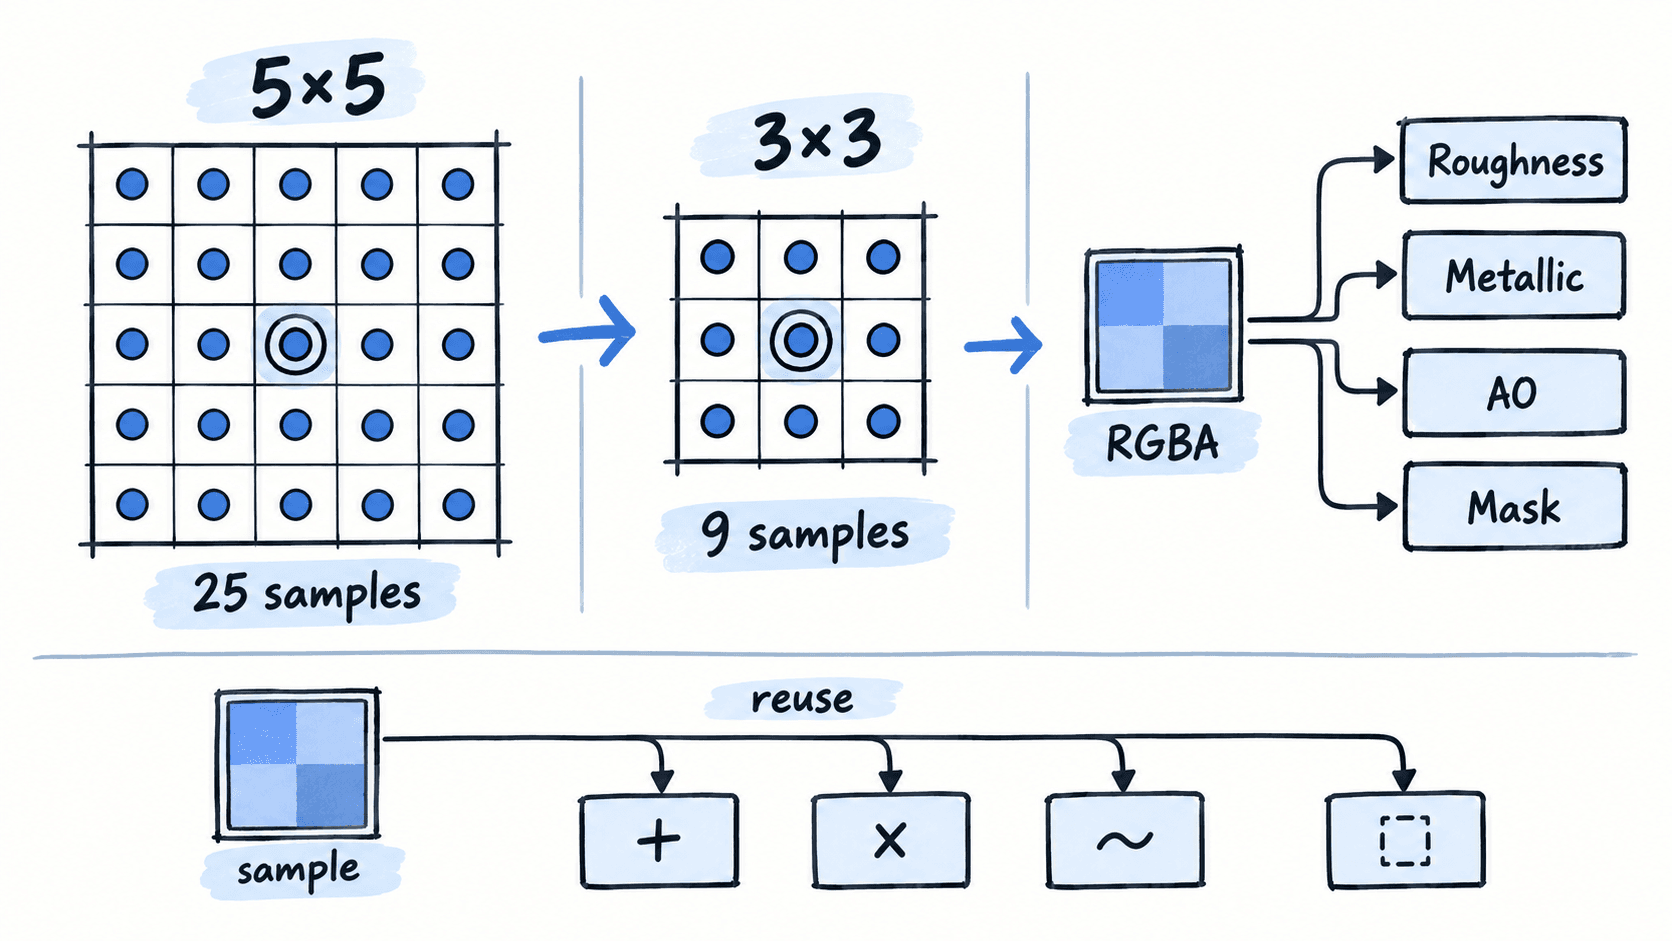
先不要只数材质绑定了几张纹理,而要看片元路径中实际执行了多少次采样。例如同时读取基础色、粗糙度、金属度和遮罩的材质,如果这些信息分别存于四张纹理,就可能产生四次采样。
片段示例,假设 baseMap、roughnessMap、metallicMap 与 maskMap 已由宿主程序绑定:
vec3 baseColor = texture(baseMap, uv).rgb;
float roughness = texture(roughnessMap, uv).r;
float metallic = texture(metallicMap, uv).r;
float mask = texture(maskMap, uv).r;
这段代码包含 4 次显式纹理采样。即使每张纹理只使用一个通道,访问次数仍然不会因此自动减少。
把标量信息合并到同一张纹理
粗糙度、金属度、AO、遮罩等数据通常只有一个标量通道。如果它们具有相同或可接受的分辨率与 UV,可以将多个数据打包到一张 RGBA 纹理中,一次采样后再拆出各通道。
片段示例,约定 packedMap.r 保存粗糙度、g 保存金属度、b 保存 AO、a 保存遮罩:
vec4 packed = texture(packedMap, uv);
float roughness = packed.r;
float metallic = packed.g;
float ao = packed.b;
float mask = packed.a;
这里四项数据只需要 1 次纹理采样。通道打包真正节省的是访问次数和纹理切换压力,而不是把四个数字“计算得更快”。
邻域效果先缩小采样范围
模糊、描边、边缘检测、SSAO 等效果经常访问中心像素周围的多个位置。一个 5×5 邻域若逐点采样,需要 25 次访问;如果视觉目标允许缩小为 3×3,就只需要 9 次。相比微调几条乘加指令,这类变化通常更值得优先测试。
片段示例,下面是一个 3×3 邻域的简单均值采样。它依赖已经定义的 sourceMap、uv 与单个纹素尺寸 texelSize:
vec3 sum = vec3(0.0);

for (int y = -1; y <= 1; ++y) {
    for (int x = -1; x <= 1; ++x) {
        vec2 offset = vec2(x, y) * texelSize;
        sum += texture(sourceMap, uv + offset).rgb;
    }
}

vec3 blurred = sum / 9.0;
这段片段固定执行 9 次邻域采样。若原方案使用 5×5 全采样,则单像素理论采样数可从 25 降到 9,但模糊半径和边缘质量也会随之改变,因此必须结合画面验证。
同一坐标的结果不要重复取
另一类常见浪费来自重复表达式。材质代码经过函数拆分后,不同函数可能各自对同一纹理、同一 UV 再采样一次。只要语义一致,就应先采样并保存结果,再把值传给后续计算。
片段示例,下面两项计算都依赖同一法线纹理,因此先取一次值再复用:
vec3 encodedNormal = texture(normalMap, uv).xyz;
vec3 normalTS = normalize(encodedNormal * 2.0 - 1.0);

float facing = max(normalTS.z, 0.0);
float edgeFactor = 1.0 - facing;
关键不是把结果保存成局部变量本身,而是确保编译后的执行路径中没有因为函数边界、宏或不同 UV 表达式产生额外采样。某些编译器会消除完全相同的重复操作,但性能优化不应依赖它一定发生。
用采样预算决定先改哪里
定位时可以先按“每像素采样次数 × 覆盖像素数”估算优先级。一个只覆盖小物体但采样很多次的材质,未必比全屏后处理更贵;全屏效果即使每像素只多一次采样,也会随分辨率放大成本。
优化顺序通常是先检查明显重复采样,再检查可合并的标量纹理,最后评估邻域半径、采样核和效果质量是否允许收缩。修改后应重新观察 GPU 时间和画面差异,而不是只以源码中 texture() 数量减少作为成功标准。