
PostgreSQL / 系统课时
处置事务年龄逼近风险线
处置事务年龄逼近风险线
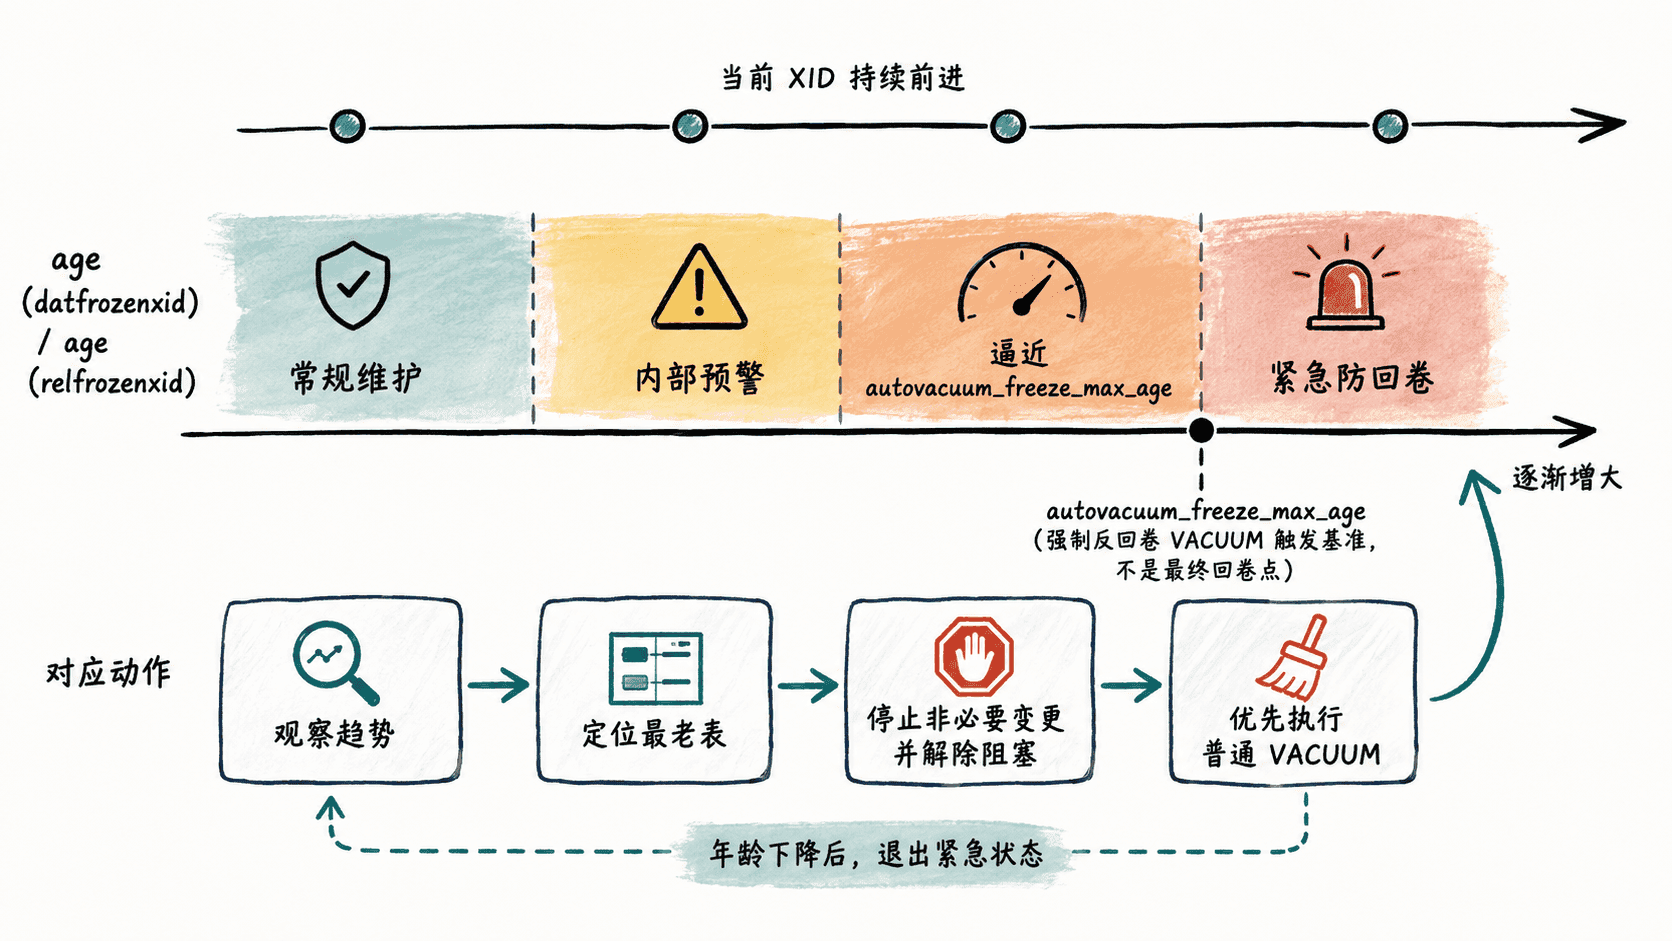
事务 ID 年龄问题的核心不是某个固定数字,而是“最老未冻结 XID 距离保护边界还有多少余量”。本篇从数据库级年龄筛出高风险对象,再下钻到表和 TOAST,最后给出停止普通变更、解除阻塞并执行应急 VACUUM 的顺序。
学习目标
- 用
datfrozenxid与relfrozenxid年龄定位最需要先处理的数据库和表。 - 结合当前
autovacuum_freeze_max_age与增长趋势制定分级处置,而不是套固定百分比。 - 在风险持续上升时设置停止条件,并按最短路径恢复 VACUUM 推进能力。
先按数据库年龄确定优先级
PostgreSQL 会通过冻结旧事务 ID 避免 XID 回卷风险。数据库的 datfrozenxid 可以看作该数据库最老未冻结 XID 的下界,因此首先按 age(datfrozenxid) 排序,比先随机挑大表更有效。
SELECT
    datname,
    age(datfrozenxid) AS datfrozenxid_age,
    current_setting('autovacuum_freeze_max_age')::bigint AS freeze_max_age,
    round(
        100.0 * age(datfrozenxid)
        / current_setting('autovacuum_freeze_max_age')::numeric,
        1
    ) AS pct_of_freeze_max
FROM pg_database
ORDER BY age(datfrozenxid) DESC;
预期结果
 datname | datfrozenxid_age | freeze_max_age | pct_of_freeze_max
---------+------------------+----------------+------------------
 appdb   | <VALUE>          | <VALUE>        | <VALUE>
<VALUE> 取决于集群现场。这里的比例只适合做集群级初筛,因为表级存储参数可以使用更低的冻结上限,而且真正的紧急程度还取决于 XID 消耗速度和 VACUUM 吞吐。生产告警应同时观察“当前年龄”和“单位时间增长量”,不要把某个固定百分比误当成 PostgreSQL 的硬安全线。
下钻到最老表与 TOAST
进入风险数据库后,应从该数据库内部继续找最老关系。只看主表的 relfrozenxid 可能漏掉 TOAST,因此把主表和它的 TOAST 年龄取较大值更稳妥。
SELECT
    c.oid::regclass AS table_name,
    greatest(
        age(c.relfrozenxid),
        age(t.relfrozenxid)
    ) AS xid_age,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size,
    c.reloptions
FROM pg_class AS c
LEFT JOIN pg_class AS t
    ON c.reltoastrelid = t.oid
WHERE c.relkind IN ('r', 'm')
ORDER BY xid_age DESC
LIMIT 30;
预期结果
 table_name    | xid_age | total_size | reloptions
---------------+---------+------------+-----------
 public.events | <VALUE> | <VALUE>    | <VALUE>
最老的表优先级最高,但处置顺序还要考虑表大小、业务热度和 VACUUM 完成时间。一个年龄略低却体量极大的表,可能比一个很小的最老表更早需要安排维护窗口,因为它需要更长时间才能扫描完成。若 reloptions 中存在表级 autovacuum 冻结配置,也要按实际参数判断,而不是只套集群默认值。
设置停止条件而不是继续观察
当年龄快速逼近内部风险线时,必须提前定义“什么情况下停止常规变更并进入应急维护”。推荐把以下任一情况视为升级信号:年龄持续上升且 VACUUM 无法追平;反回卷 autovacuum 反复被锁冲突或人工取消;日志已经出现要求尽快 VACUUM 的回卷警告;剩余 XID 余量按当前消耗速度不足以覆盖预计维护完成时间。
进入应急状态后,应暂停非必要 DDL、批处理和高事务量写入,保留维护操作所需资源。然后按阻塞源从外到内清理:老的 prepared transaction、长事务、长期保留 xmin 或 catalog_xmin 的复制槽,以及阻塞 VACUUM 所需锁的会话。
下面的查询一次列出三类常见阻塞证据,便于决定先处理谁。
SELECT
    'prepared_xact' AS source,
    gid AS identity,
    age(transaction) AS xid_age
FROM pg_prepared_xacts
UNION ALL
SELECT
    'backend' AS source,
    pid::text AS identity,
    greatest(
        coalesce(age(backend_xid), 0),
        coalesce(age(backend_xmin), 0)
    ) AS xid_age
FROM pg_stat_activity
WHERE backend_xid IS NOT NULL
   OR backend_xmin IS NOT NULL
UNION ALL
SELECT
    'replication_slot' AS source,
    slot_name AS identity,
    greatest(
        coalesce(age(xmin), 0),
        coalesce(age(catalog_xmin), 0)
    ) AS xid_age
FROM pg_replication_slots
WHERE xmin IS NOT NULL
   OR catalog_xmin IS NOT NULL
ORDER BY xid_age DESC;
预期结果
 source           | identity | xid_age
------------------+----------+---------
 backend          | <PID>    | <VALUE>
 replication_slot | <ID>     | <VALUE>
 prepared_xact    | <ID>     | <VALUE>
复制槽不能因为“年龄大”就直接删除:仍被有效副本使用的槽一旦丢弃,副本可能需要重新构建。prepared transaction 也必须根据业务语义选择 COMMIT PREPARED 或 ROLLBACK PREPARED,不能机械回滚。
用最短路径推进冻结
阻塞解除后,优先对最老表执行普通 VACUUM。已经足够老的表会进入更积极的冻结扫描;在事故窗口里,目标是尽快推进 relfrozenxid,而不是顺手做表重写。
VACUUM public.events;预期结果
VACUUM如果多个表都处于高龄,可以先按上一节的 xid_age 排序逐个处理,再根据剩余时间执行数据库级 VACUUM。此时不要用 VACUUM FULL 代替普通 VACUUM:它需要重写关系并获取更强锁,解决的是物理空间回收,不是回卷应急的最短路径。
VACUUM 运行期间可用进度视图确认它确实在向前扫描,而不是仅凭进程存在判断。
SELECT
    pid,
    relid::regclass AS table_name,
    phase,
    heap_blks_scanned,
    heap_blks_total
FROM pg_stat_progress_vacuum
ORDER BY pid;
预期结果
 pid   | table_name    | phase         | heap_blks_scanned | heap_blks_total
-------+---------------+---------------+-------------------+----------------
 <PID> | public.events | scanning heap | <VALUE>           | <VALUE>
完成后重新查询数据库级和表级年龄。只有 datfrozenxid_age 与目标表 xid_age 明显回落、风险日志停止出现、VACUUM 能持续完成,才应逐步恢复被暂停的写入和变更。若年龄仍增长,则说明还有更老的关系或保留源未解除,不能因为某一次 VACUUM 返回成功就宣布风险解除。