
PostgreSQL / 系统课时
设计 Autovacuum 日志与告警
设计 Autovacuum 日志与告警
这一课把 Autovacuum 从“后台自动运行”变成可观测对象:先控制日志量,再用统计视图补齐实时状态,最后为死元组积压、事务年龄和清理延迟建立分级阈值,使告警能够直接指向需要处理的表和风险类型。
学习目标
- 配置可控的 Autovacuum 日志采集,并理解时长阈值与真正随机采样的区别
- 用
pg_stat_user_tables、pg_database等视图构造死元组和事务年龄指标 - 设计能抑制瞬时噪声、又能提前暴露清理风险的分级告警
先把 Autovacuum 日志变成可用证据
log_autovacuum_min_duration 按执行时长筛选 Autovacuum/Autoanalyze 日志,它不是随机采样器。生产环境通常不应长期把全库设为 0;更稳妥的做法是先记录较慢操作,再对少数重点表临时使用表级覆盖,以获得完整样本。
下面给出一个可作为基线期起点的 postgresql.conf 片段。30s 只是示例,应根据表规模和现有日志吞吐调整。
log_autovacuum_min_duration = '30s'
log_line_prefix = '%m [%p] %d '
修改配置并 reload 后,用统计参数视图确认实际生效值。
SELECT name, setting, unit
FROM pg_settings
WHERE name IN ('log_autovacuum_min_duration', 'log_line_prefix')
ORDER BY name;
预期结果
name                         | setting        | unit
-----------------------------+----------------+------
log_autovacuum_min_duration  | <VALUE>        | ms
log_line_prefix              | %m [%p] %d     | <VALUE>
<VALUE> 的显示形式会受版本和单位规范化影响;关键是时长参数不再为禁用值,并且日志前缀能提供时间、进程和数据库上下文。对单个高风险表需要短期全量观察时,可设置表级 log_autovacuum_min_duration=0,采样完成后再恢复继承全局配置,避免长期放大日志量。
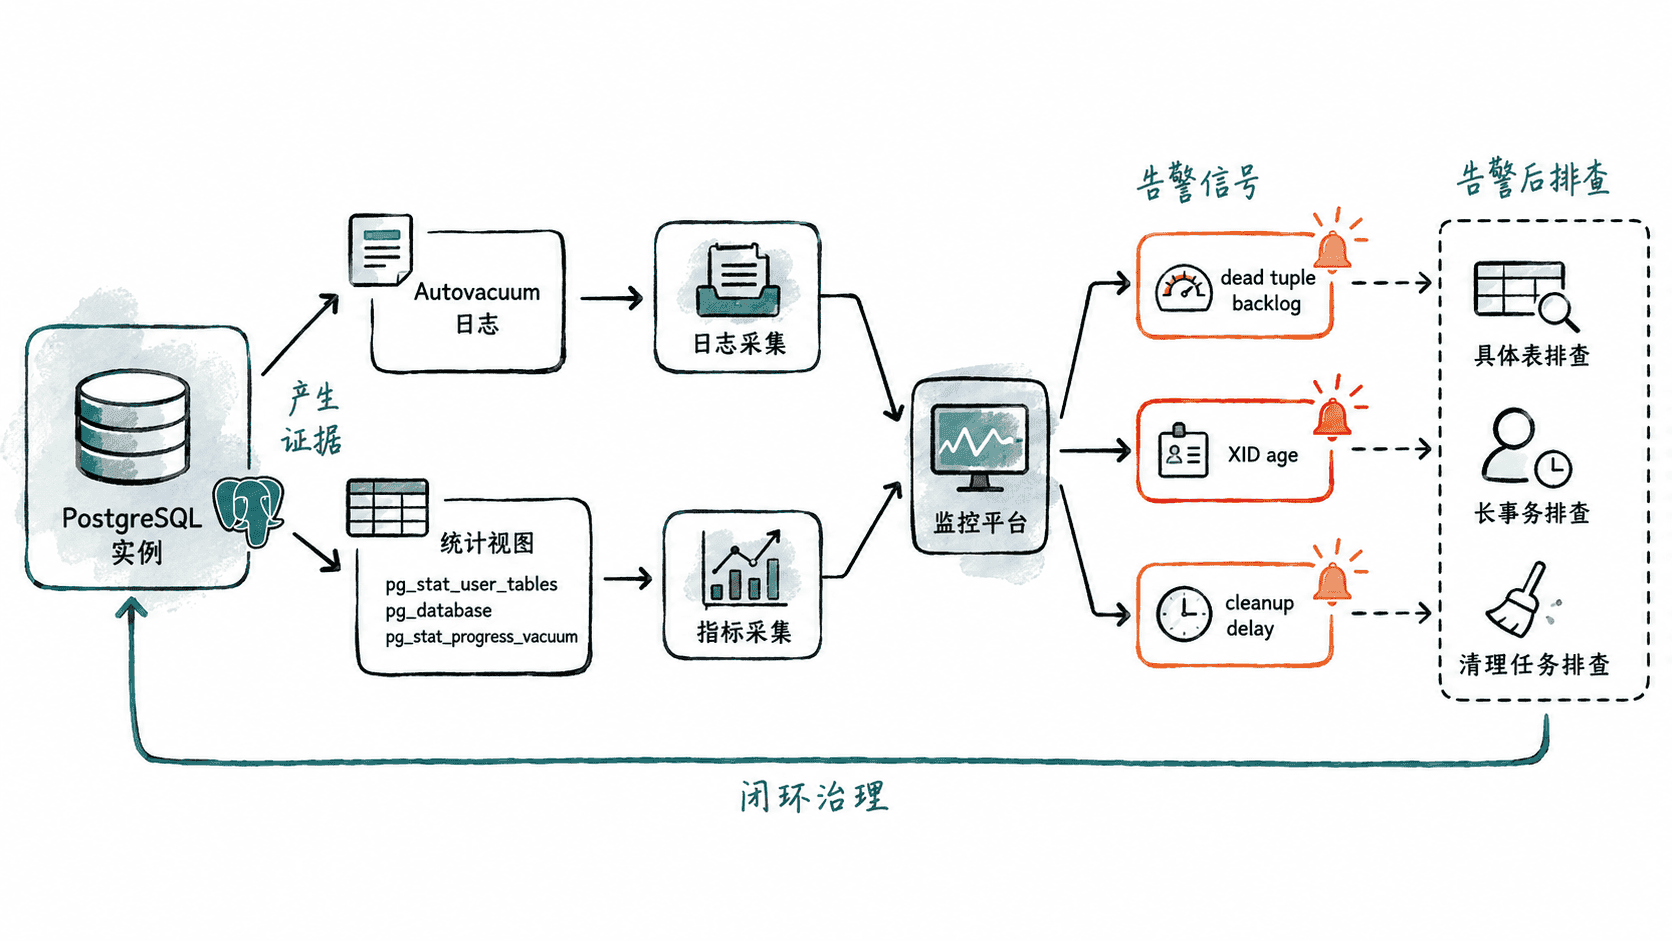
建立三条互补的告警信号
只盯 n_dead_tup 绝对值容易误报:一百万死元组对十亿行表和一千万行表含义不同。更实用的办法是把死元组与“有效 vacuum 触发阈值”比较。当前版本中,普通 UPDATE/DELETE 触发阈值可理解为基础阈值加规模因子,并受最大阈值约束;表级 storage parameter 会覆盖全局参数。
可以把告警设计成三条互补信号,而不是一个万能阈值:
| 信号 | Warning 起点 | Critical 起点 | 必要约束 |
|---|---|---|---|
| 死元组积压 | n_dead_tup 连续 15 分钟高于有效触发阈值约 2 倍且仍上升 |
连续 15 分钟高于约 5 倍 | 仅对持续写入表;同时检查是否已有 vacuum 在运行 |
| XID 年龄 | age(datfrozenxid) 达 autovacuum_freeze_max_age 的 50% |
达 75%;90% 进入应急等级 | 按数据库持续采样,并下钻到最老表 |
| 清理延迟 | 写活跃且积压超过触发阈值,同时距最近成功 Autovacuum 超过历史周期 P95 的 2 倍 | 超过 P95 的 4 倍 | 没有历史基线时先用临时阈值,积累一周后改为动态基线 |
这些比例是治理起点,不是 PostgreSQL 的硬性安全线。高事务吞吐系统应更早告警,因为相同的 XID 余量可能在更短时间内消耗完;低频更新表则不应仅因很久没有 Autovacuum 就报警。
用 SQL 验证告警数据源
先找出当前死元组最多、且最近 Autovacuum 信息异常的用户表。n_live_tup 和 n_dead_tup 都是估算值,适合监控趋势,不应当作逐行精确计数。
SELECT
    schemaname,
    relname,
    n_live_tup,
    n_dead_tup,
    round(
        100.0 * n_dead_tup / greatest(n_live_tup + n_dead_tup, 1),
        2
    ) AS dead_pct,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
预期结果
schemaname | relname  | n_live_tup | n_dead_tup | dead_pct | last_autovacuum | autovacuum_count
-----------+----------+------------+------------+----------+-----------------+-----------------
app        | <TABLE>  | <VALUE>    | <VALUE>    | <VALUE>  | <TIME>          | <VALUE>
再单独监控数据库级 XID 年龄,使反事务号回卷风险不会被表级死元组告警掩盖。
SELECT
    datname,
    age(datfrozenxid) AS xid_age,
    round(
        100.0 * age(datfrozenxid)
        / current_setting('autovacuum_freeze_max_age')::bigint,
        1
    ) AS pct_of_freeze_max
FROM pg_database
WHERE datallowconn
ORDER BY xid_age DESC;
预期结果
datname    | xid_age | pct_of_freeze_max
-----------+---------+------------------
<DATABASE> | <VALUE> | <VALUE>
告警系统应保存这些时间序列,而不是只执行一次 SQL。真正需要处理的是“持续偏离基线”:死元组不断增长、XID 年龄持续逼近上限,或高更新表在多个预期周期内没有成功清理。
让告警直接指向处理动作
告警标签至少应包含数据库、schema、表、当前值、阈值和持续时间。死元组积压告警进入后续排查时,应先看 pg_stat_progress_vacuum 是否已有清理任务;XID 年龄告警应立即定位最老 relfrozenxid;清理延迟告警则优先关联 Autovacuum 日志中的耗时和跳过信息。
最终目标不是记录更多日志,而是让日志、统计视图和时间序列互相校验:日志解释一次清理做了什么,指标说明风险是否在积累,告警只在趋势持续偏离时升级。这样才能既发现 Autovacuum 真正落后,又避免把正常空闲表变成告警噪声。