
PostgreSQL / 系统课时
调节 Cost Delay 与 Cost Limit
调节 Cost Delay 与 Cost Limit
Autovacuum 的目标不是“越快越好”,而是在清理速度和业务 I/O 抖动之间找到可持续的平衡。本课把 Cost Delay 与 Cost Limit 当作一组限速器来理解,并通过配置、校验和观测判断应该加速还是降速。
学习目标
- 解释 Cost Delay、Cost Limit 与 VACUUM 工作节奏之间的关系
- 根据死元组积压和业务延迟选择正确的调节方向
- 修改并验证 autovacuum 的全局成本限速参数
先看清成本限速如何工作
VACUUM 扫描 heap 和索引页时,会按缓存命中、磁盘读取、脏页写回等操作累计“成本”。成本不是毫秒、CPU 百分比或 IOPS,而是一套内部记账单位。当累计成本达到预算后,worker 会短暂休眠,再继续扫描。
对 autovacuum 来说,主要关注 autovacuum_vacuum_cost_delay 和 autovacuum_vacuum_cost_limit。前者决定达到成本预算后暂停多久,后者决定一次可以累计多少成本。更小的 Delay 或更大的 Limit 会提高推进速度;更大的 Delay 或更小的 Limit 会减轻瞬时压力,但会延长清理时间。
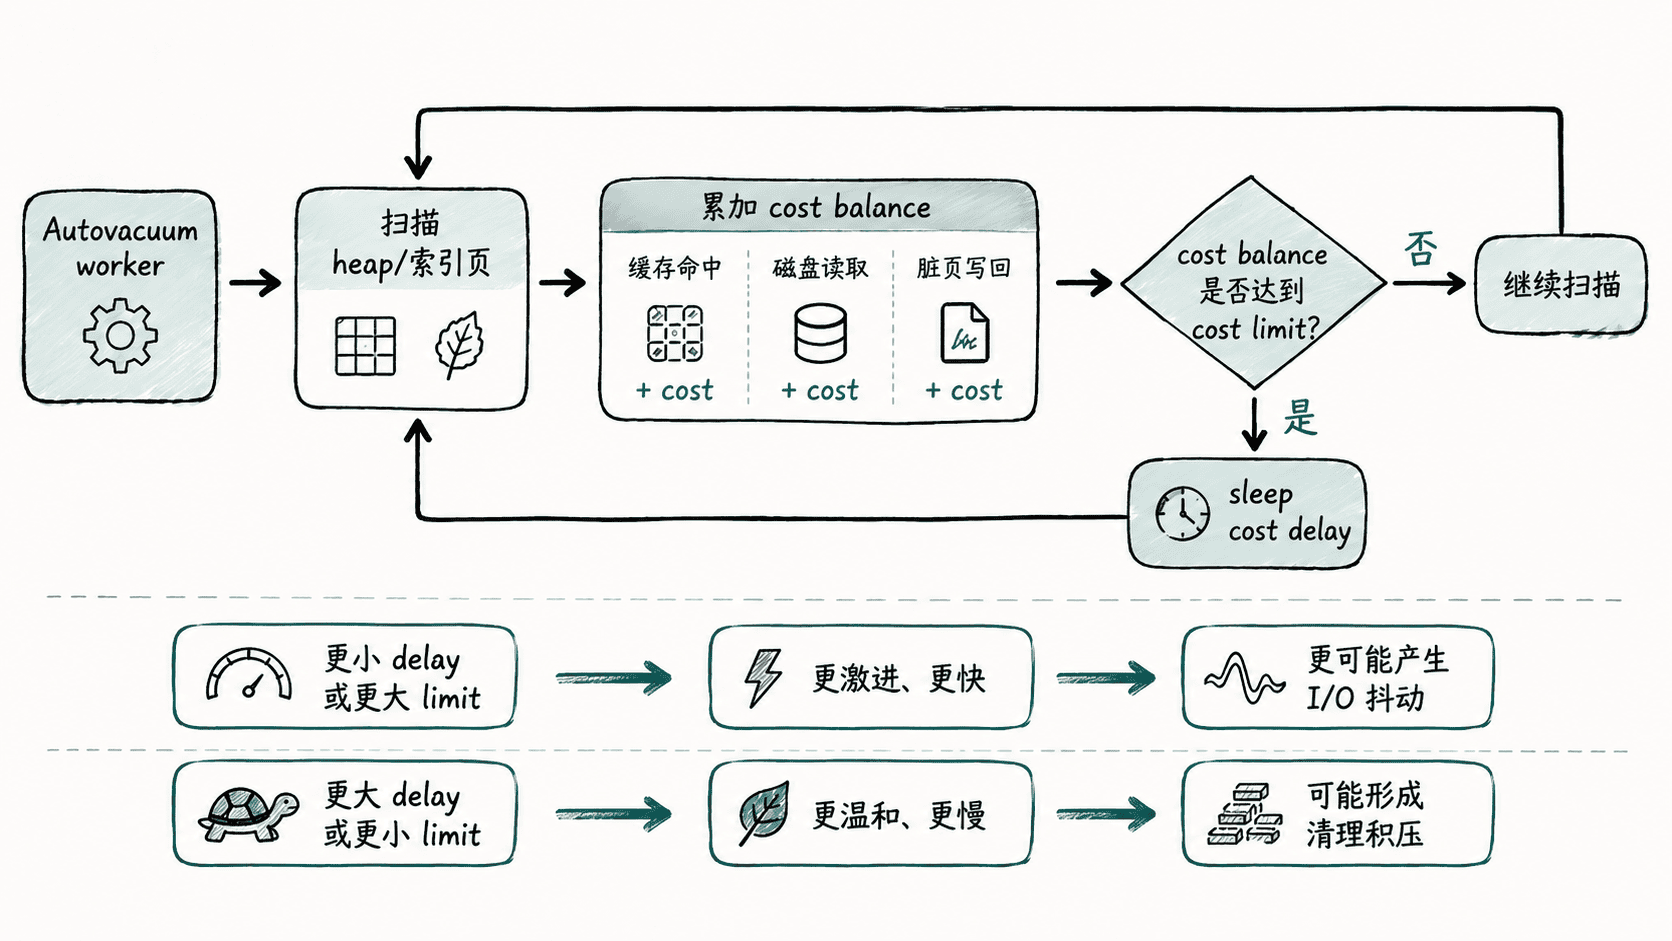
多个 autovacuum worker 同时运行时,还要考虑总 I/O 压力和成本额度分配。因此不要把某个 worker 的 Cost Limit 直接理解成整台数据库的固定 IOPS 上限,也不要期待“Limit 翻倍,VACUUM 时间就必然减半”。
读取当前配置
先读取实际生效值,不要凭默认值做判断。下面的查询同时检查 autovacuum 专用参数和普通 VACUUM 的成本参数,便于识别是否存在继承或覆盖。
SELECT name, setting, unit, source
FROM pg_settings
WHERE name IN (
  'autovacuum_vacuum_cost_delay',
  'autovacuum_vacuum_cost_limit',
  'vacuum_cost_delay',
  'vacuum_cost_limit'
)
ORDER BY name;
预期输出
              name               | setting | unit |   source
---------------------------------+---------+------+------------
autovacuum_vacuum_cost_delay     | <VALUE> | ms   | <SOURCE>
autovacuum_vacuum_cost_limit     | <VALUE> |      | <SOURCE>
vacuum_cost_delay                | <VALUE> | ms   | <SOURCE>
vacuum_cost_limit                | <VALUE> |      | <SOURCE>
(4 rows)
<VALUE> 和 <SOURCE> 取决于实例配置;如果某个 autovacuum 参数使用继承语义,应继续确认它最终引用的普通 VACUUM 参数,而不是只看参数名。
在实验环境调节并重载
下面示例把 autovacuum 的暂停时间设为 5 ms、成本上限设为 800。它适合演示“更长休眠 + 更大单轮预算”的组合效果,不代表生产环境推荐值。执行 ALTER SYSTEM 需要相应权限;托管数据库应使用平台提供的参数组完成等价设置。
ALTER SYSTEM SET autovacuum_vacuum_cost_delay = '5ms';
ALTER SYSTEM SET autovacuum_vacuum_cost_limit = 800;

SELECT pg_reload_conf();

SELECT name, setting, unit
FROM pg_settings
WHERE name IN (
  'autovacuum_vacuum_cost_delay',
  'autovacuum_vacuum_cost_limit'
)
ORDER BY name;
预期输出
ALTER SYSTEM
ALTER SYSTEM
 pg_reload_conf
----------------
 t
(1 row)

              name               | setting | unit
---------------------------------+---------+------
autovacuum_vacuum_cost_delay     | 5       | ms
autovacuum_vacuum_cost_limit     | 800     |
(2 rows)
调参时一次只改变一个方向更容易解释结果。若业务延迟在 autovacuum 活跃时明显抖动,可以先小幅增加 Delay 或降低 Limit;若 n_dead_tup 长期上升、单次清理持续很久且存储仍有余量,则可以小幅降低 Delay 或提高 Limit。
用表级积压验证调节结果
调节后至少观察几个 autovacuum 周期,确认热点表的死元组是否能回落,同时业务延迟是否保持稳定。下面的查询用 pg_stat_user_tables 找出当前死元组最多的表。
SELECT
  relid::regclass AS table_name,
  n_live_tup,
  n_dead_tup,
  last_autovacuum,
  autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 5;
预期输出
 table_name | n_live_tup | n_dead_tup |    last_autovacuum     | autovacuum_count
------------+------------+------------+------------------------+------------------
 <TABLE>    | <VALUE>    | <VALUE>    | <TIME>                 | <VALUE>
 ...
(<N> rows)
实际行数、时间和值会不同。真正有效的调节应同时满足两个条件:业务延迟不再因清理产生不可接受的尖峰,且热点表的清理速度足以跟上写入 churn;如果只能满足其中一个条件,就还没有找到稳定的资源平衡点。