
PostgreSQL / 系统课时
识别反回卷 Autovacuum
识别反回卷 Autovacuum
当后台出现持续时间很长、I/O 很高的 Autovacuum 时,先判断它是不是为防止事务 ID 回卷而启动。关键不是“跑了多久”,而是 relfrozenxid 的年龄、当前冻结阈值,以及活动查询是否明确标记为防回卷任务。
学习目标
- 区分普通 Autovacuum、aggressive VACUUM 与 anti-wraparound Autovacuum
- 用
pg_stat_activity、pg_stat_progress_vacuum和relfrozenxid识别真实风险 - 判断为什么防回卷任务不应被当作普通后台负载随意取消
先确认它是不是防回卷任务
普通 Autovacuum 多由更新、删除或插入阈值触发;anti-wraparound Autovacuum 则由事务年龄安全线触发。当表的 relfrozenxid 年龄超过 autovacuum_freeze_max_age 时,PostgreSQL 会强制安排 VACUUM,即使普通 Autovacuum 被关闭也不能依赖这一点来逃避回卷保护。
运行下面的查询,先看当前 Autovacuum 是否带有 (to prevent wraparound) 标记,再结合进度和等待事件判断它是在扫描、清理还是等待锁。
SELECT
    a.pid,
    a.datname,
    p.relid::regclass AS relation,
    p.phase,
    p.heap_blks_scanned,
    p.heap_blks_total,
    a.wait_event_type,
    a.wait_event,
    a.query
FROM pg_stat_activity AS a
LEFT JOIN pg_stat_progress_vacuum AS p USING (pid)
WHERE a.backend_type = 'autovacuum worker'
ORDER BY a.pid;
预期输出
 pid   | datname | relation      | phase         | heap_blks_scanned | heap_blks_total | wait_event_type | wait_event | query
-------+---------+---------------+---------------+-------------------+-----------------+-----------------+------------+---------------------------------------------------------------
<PID> | appdb | public.orders | scanning heap | <VALUE> | <VALUE> | <VALUE> | <VALUE> | autovacuum: VACUUM public.orders (to prevent wraparound)pid、页数和阶段会随现场变化。查询文本末尾的 (to prevent wraparound) 是最直接的运行态信号;如果 wait_event_type 为 Lock,说明任务虽然必须完成,但此刻可能被冲突锁拖住。
用 relfrozenxid 判断风险窗口
relfrozenxid 表示该关系中仍可能存在的最老未冻结事务 ID 下界。一次 VACUUM 运行时,年龄超过 vacuum_freeze_table_age 会转为 aggressive 扫描;超过 autovacuum_freeze_max_age 则会强制安排防回卷 Autovacuum。继续逼近 vacuum_failsafe_age 时,VACUUM 会进入更激进的失效保护策略。
WITH settings AS (
    SELECT
        current_setting('vacuum_freeze_table_age')::bigint AS freeze_table_age,
        current_setting('autovacuum_freeze_max_age')::bigint AS freeze_max_age,
        current_setting('vacuum_failsafe_age')::bigint AS failsafe_age
),
ages AS (
    SELECT
        c.oid::regclass AS relation,
        GREATEST(
            age(c.relfrozenxid),
            COALESCE(age(t.relfrozenxid), 0)
        )::bigint AS xid_age
    FROM pg_class AS c
    LEFT JOIN pg_class AS t ON t.oid = c.reltoastrelid
    WHERE c.relkind IN ('r', 'm')
)
SELECT
    a.relation,
    a.xid_age,
    s.freeze_table_age,
    s.freeze_max_age,
    s.failsafe_age,
    round(100.0 * a.xid_age / NULLIF(s.freeze_max_age, 0), 1) AS pct_of_freeze_max
FROM ages AS a
CROSS JOIN settings AS s
ORDER BY a.xid_age DESC
LIMIT 10;
预期输出
 relation      | xid_age | freeze_table_age | freeze_max_age | failsafe_age | pct_of_freeze_max
---------------+---------+------------------+----------------+--------------+-------------------
 public.orders | <VALUE> | <VALUE>          | <VALUE>        | <VALUE>      | <VALUE>
这里同时取主表和 TOAST 表中更老的一侧,避免只看主表而漏掉真正的冻结瓶颈。pct_of_freeze_max 越接近或超过 100,越不能把当前 VACUUM 当成可有可无的后台任务。
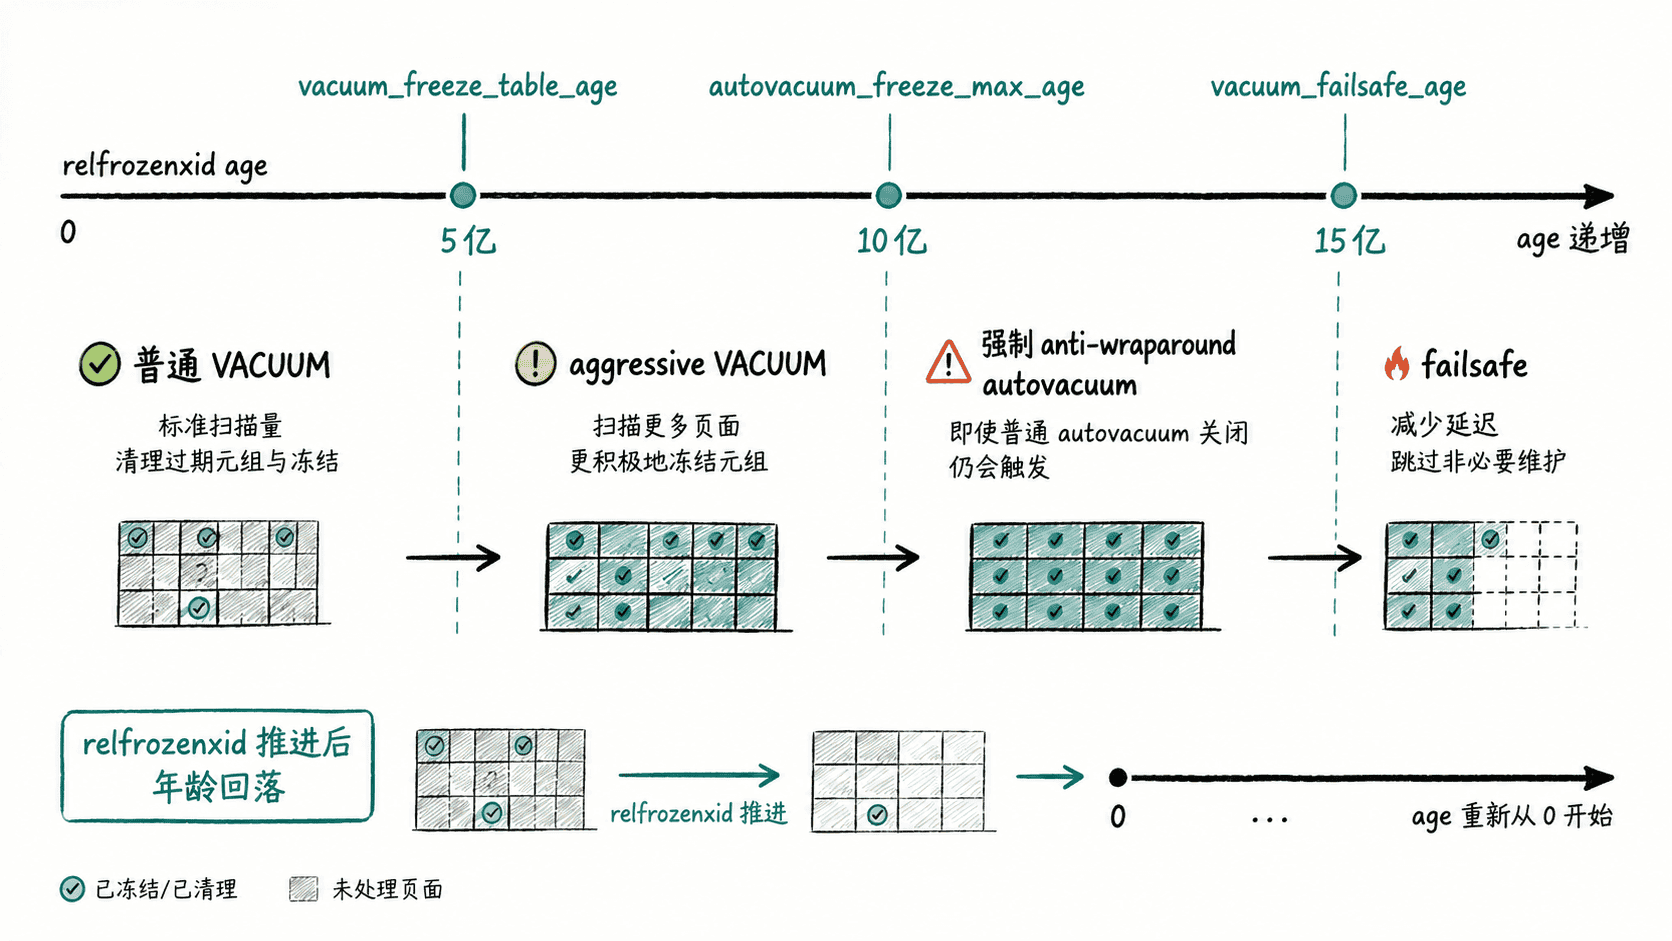
为什么不能简单取消
取消防回卷任务只会中断这一次扫描,不会消除旧事务 ID。relfrozenxid 没有推进时,系统仍会再次选择这张表;如果长期阻止冻结,风险会继续向回卷边界逼近,最终 PostgreSQL 会限制分配新的事务 ID 来保护数据一致性。
防回卷 Autovacuum 也不会像普通 Autovacuum 那样因冲突锁请求而自动让路。若它正在等待锁,应优先根据 wait_event_type、wait_event 和 pg_blocking_pids(pid) 找到阻塞者,协调 DDL 或维护窗口,而不是把终止 VACUUM 当作常规降负载手段。
处置顺序应保持简单:先确认任务确实是防回卷,再确认它是否持续取得扫描进展;若等待锁就解除阻塞,若只是 I/O 压力就减少竞争负载并让它完成。只有明确评估过回卷余量和维护窗口时,才考虑中断后立即安排可控的替代 VACUUM。
验证冻结是否真正推进
任务完成后重新运行年龄查询,目标关系的 xid_age 应明显下降,活动列表中的防回卷 worker 也应消失。数据库级 datfrozenxid 不一定同步下降,因为它取决于该数据库内最老的关系;如果年龄仍高,应继续查找更老的普通表、物化视图或其 TOAST 表。
如果同一大表反复在接近 autovacuum_freeze_max_age 时才被强制处理,问题已经从“单次任务太重”变成“预防性冻结来得太晚”。治理方向应是提前完成冻结、给 VACUUM 足够 worker 与 I/O 预算,而不是单纯提高回卷上限。