
PostgreSQL / 系统课时
从 pg_stat_activity 找到清理阻塞源
从 pg_stat_activity 找到清理阻塞源
当数据库的事务年龄持续上升、VACUUM 反复运行却清不掉旧版本时,真正要回答的是“哪个 backend 正在把清理边界拖在过去”。本课用 pg_database 与 pg_stat_activity 建立从库级年龄到具体会话、事务和应用的排查链路。
学习目标
- 用
age(datfrozenxid)判断数据库是否存在事务年龄压力 - 用
backend_xid、backend_xmin与xact_start排出最可疑的 backend - 区分真正的长事务阻塞与复制槽、预备事务等非普通会话来源
先把库级年龄当作风险信号
pg_database.datfrozenxid 记录数据库冻结进度的下界,age(datfrozenxid) 越大,说明仍有更老的普通事务 ID 尚未完成冻结。它适合回答“哪个数据库需要优先看”,但不能单凭这个值认定某个会话就是阻塞源:冻结年龄也可能来自尚未被及时 vacuum 的大表。
真正定位 backend 时,要同时看两类年龄。backend_xid 表示当前 backend 已分配的顶层事务 ID;backend_xmin 表示该 backend 当前需要保留的快照 xmin 边界。两者任一很老,都值得结合事务持续时间和会话状态继续核对。
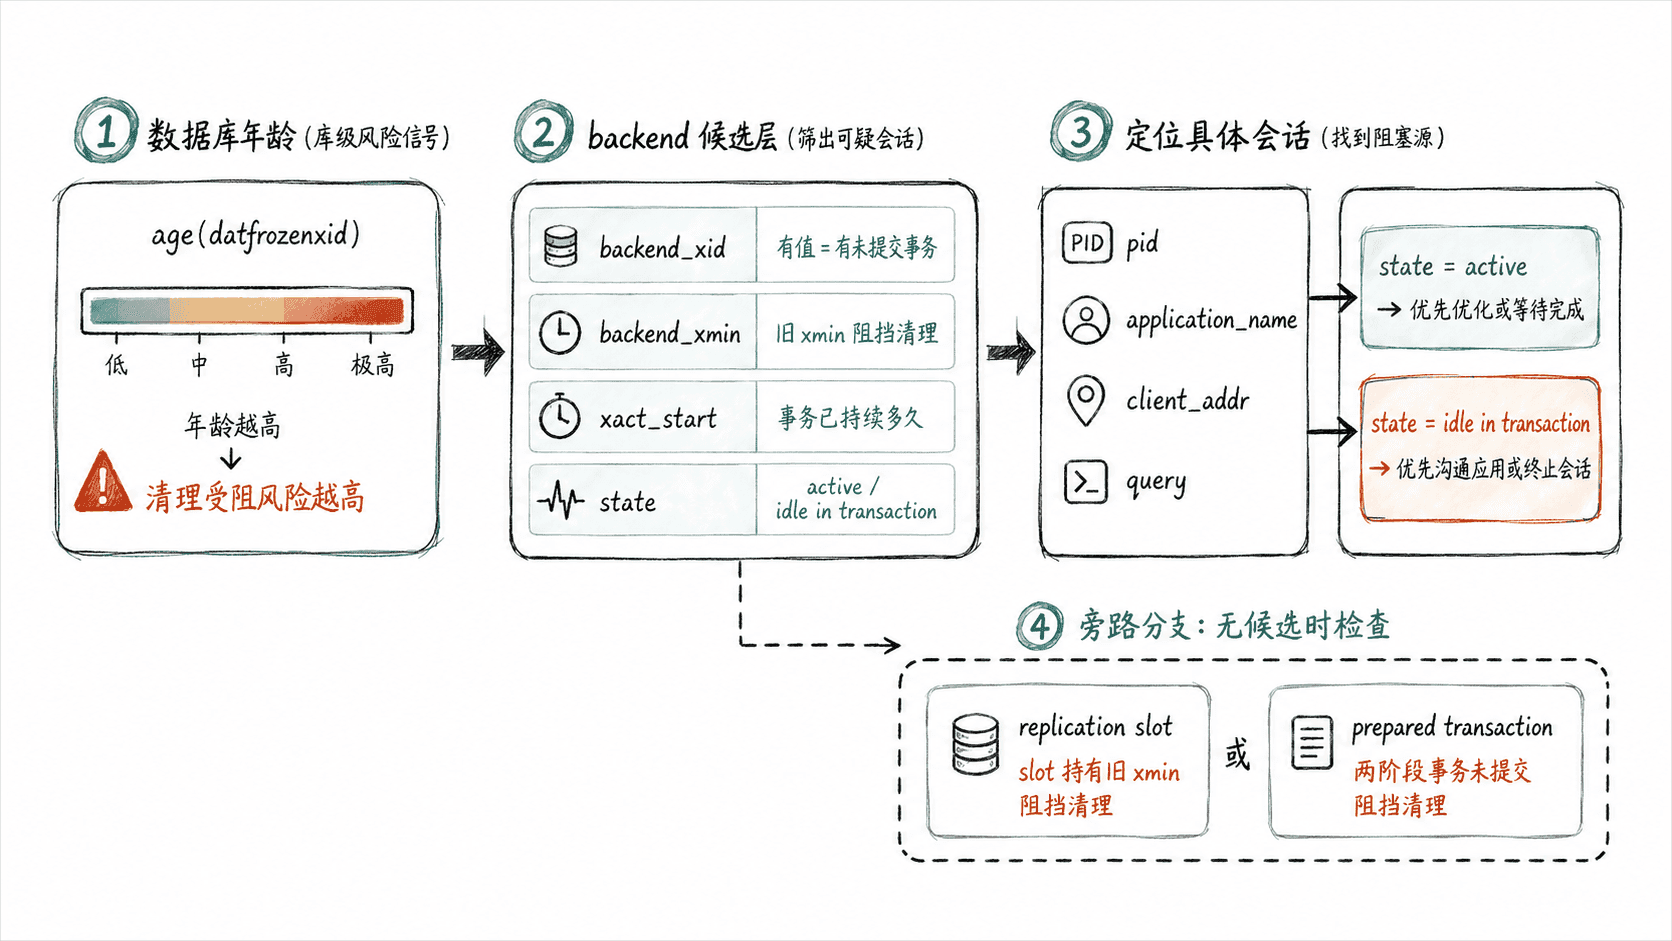
沿年龄链路锁定 backend
下面的主查询先看当前数据库的冻结年龄,再按 backend 持有的最老事务或快照年龄排序。执行它通常需要能读取其他会话统计信息的权限;权限不足时,其他用户的查询文本可能被隐藏。
-- 先确认当前数据库的冻结年龄
SELECT datname,
       age(datfrozenxid) AS frozen_xid_age
FROM pg_database
WHERE datname = current_database();

-- 再按最老事务或快照边界排列候选 backend
SELECT pid,
       usename,
       application_name,
       client_addr,
       state,
       xact_start,
       clock_timestamp() - xact_start AS xact_age,
       backend_xid,
       age(backend_xid) AS backend_xid_age,
       backend_xmin,
       age(backend_xmin) AS backend_xmin_age,
       wait_event_type,
       wait_event,
       left(query, 120) AS query
FROM pg_stat_activity
WHERE datname = current_database()
  AND pid <> pg_backend_pid()
  AND (
        backend_xid IS NOT NULL
        OR backend_xmin IS NOT NULL
        OR state = 'idle in transaction'
      )
ORDER BY GREATEST(
           COALESCE(age(backend_xid), 0),
           COALESCE(age(backend_xmin), 0)
         ) DESC,
         xact_start NULLS LAST;
预期输出
 datname | frozen_xid_age
---------+----------------
 appdb   | <VALUE>

 pid  | usename | application_name | client_addr | state               | xact_start | xact_age | backend_xid | backend_xid_age | backend_xmin | backend_xmin_age | wait_event_type | wait_event | query
------+---------+------------------+-------------+---------------------+------------+----------+-------------+-----------------+--------------+------------------+-----------------+------------+-------------------------
<ID> | app | api | <IP> | idle in transaction | <TIME> | <VALUE> | <ID> | <VALUE> | <ID> | <VALUE> | Client | ClientRead | UPDATE accounts SET ...<VALUE>、<ID>、<IP> 和 <TIME> 会随环境变化,部分列也可能为 NULL。排序靠前不等于一定有故障,但它给出了最应该先核实的会话。
读懂几个容易误判的字段
backend_xmin_age 很大时,说明该 backend 的快照仍可能需要看到很老的行版本,这是 VACUUM 无法越过的典型可见性边界。长时间运行的 Repeatable Read 或 Serializable 事务尤其需要关注。
backend_xid_age 很大时,说明事务本身已经很老。若同时 state = 'idle in transaction',往往是应用开启事务后长期不提交或回滚;这类会话没有在执行 SQL,却仍占着事务生命周期。
只看 xact_age 也会误判。事务可能持续很久但没有持有老快照或老 XID;反过来,一个当前查询很短的 backend,也可能处在已经持续很久的事务里。因此要用 xact_start、backend_xid、backend_xmin 和 state 交叉判断,而不是只按“最长查询”排序。
处理时先释放事务,再观察冻结进度
如果是正常的长查询,先确认业务是否允许等待;若必须中止,pg_cancel_backend 只取消当前语句,并不保证事务立即结束。对 idle in transaction 会话,真正释放边界的是让应用执行 COMMIT 或 ROLLBACK,必要时再由有权限的管理员终止 backend。
事务结束后,候选 backend 的老 backend_xid 或 backend_xmin 应先从 pg_stat_activity 中消失。随后由正常 VACUUM 或 autovacuum 推进表级冻结进度;datfrozenxid 不一定立刻大幅变化,因为它取决于数据库中各关系的整体冻结状态。
pg_stat_activity 没找到时的边界
如果冻结年龄或死元组保留明显异常,但 pg_stat_activity 没有足够老的 backend,就不要继续“盯着会话找会话”。复制槽的 xmin 或 catalog_xmin、两阶段提交留下的 prepared transaction,以及复制相关的反馈机制,都可能在普通业务会话之外保留旧版本。
因此这条排查链路的正确用法是:先用数据库年龄判断压力,再用 pg_stat_activity 定位普通 backend;找到候选后按事务与快照年龄确认是否真的占住边界;若没有候选,再转向复制槽与预备事务。这样才能把“VACUUM 清不掉”落到一个可以处置的具体保留源上。