
PostgreSQL / 系统课时
排查 Autovacuum 跟不上更新速度
排查 Autovacuum 跟不上更新速度
当高更新表的 dead tuple 持续增长时,问题可能不是“Autovacuum 太慢”这么简单:它可能根本没触发、被旧快照阻塞、单次清理吞吐不足,或 worker 被其他大表占满。本课按证据顺序定位瓶颈,并给出不会相互打架的调参次序。
学习目标
- 判断 dead tuple 增长是短时峰值还是 Autovacuum 持续落后
- 区分旧快照阻塞、触发过晚、单任务吞吐不足和 worker 排队四类原因
- 按风险优先级调整表级参数,并用普通 VACUUM 和统计视图验证效果
先确认是真正的持续积压
先从表级统计找出“写入很活跃、死元组不断增加、Autovacuum 又无法及时拉回”的对象。一次采样只能给出快照,生产排障应至少对比连续多个采样点。
SELECT
    schemaname,
    relname,
    n_live_tup,
    n_dead_tup,
    n_tup_upd,
    n_tup_del,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
预期结果
schemaname | relname | n_live_tup | n_dead_tup | n_tup_upd | n_tup_del | last_autovacuum | autovacuum_count
-----------+---------+------------+------------+-----------+-----------+-----------------+-----------------
app        | <TABLE> | <VALUE>    | <VALUE>    | <VALUE>   | <VALUE>   | <TIME>          | <VALUE>
如果 n_dead_tup 在多个采样周期内单调上升,而 autovacuum_count 不增加或增加后积压仍很快恢复,就进入下一层。若只是批处理期间短时冲高、随后能被拉回,则优先调整告警持续时间,而不是立刻改 Autovacuum 参数。
按四层顺序找瓶颈
排查顺序应固定为:能不能回收 → 会不会及时启动 → 单次跑得够不够快 → 有没有足够并发。前一层不成立时,调后一层通常无效。例如长事务保留着旧快照时,即使增加 worker,也不能让那些仍可能被访问的旧版本提前回收。
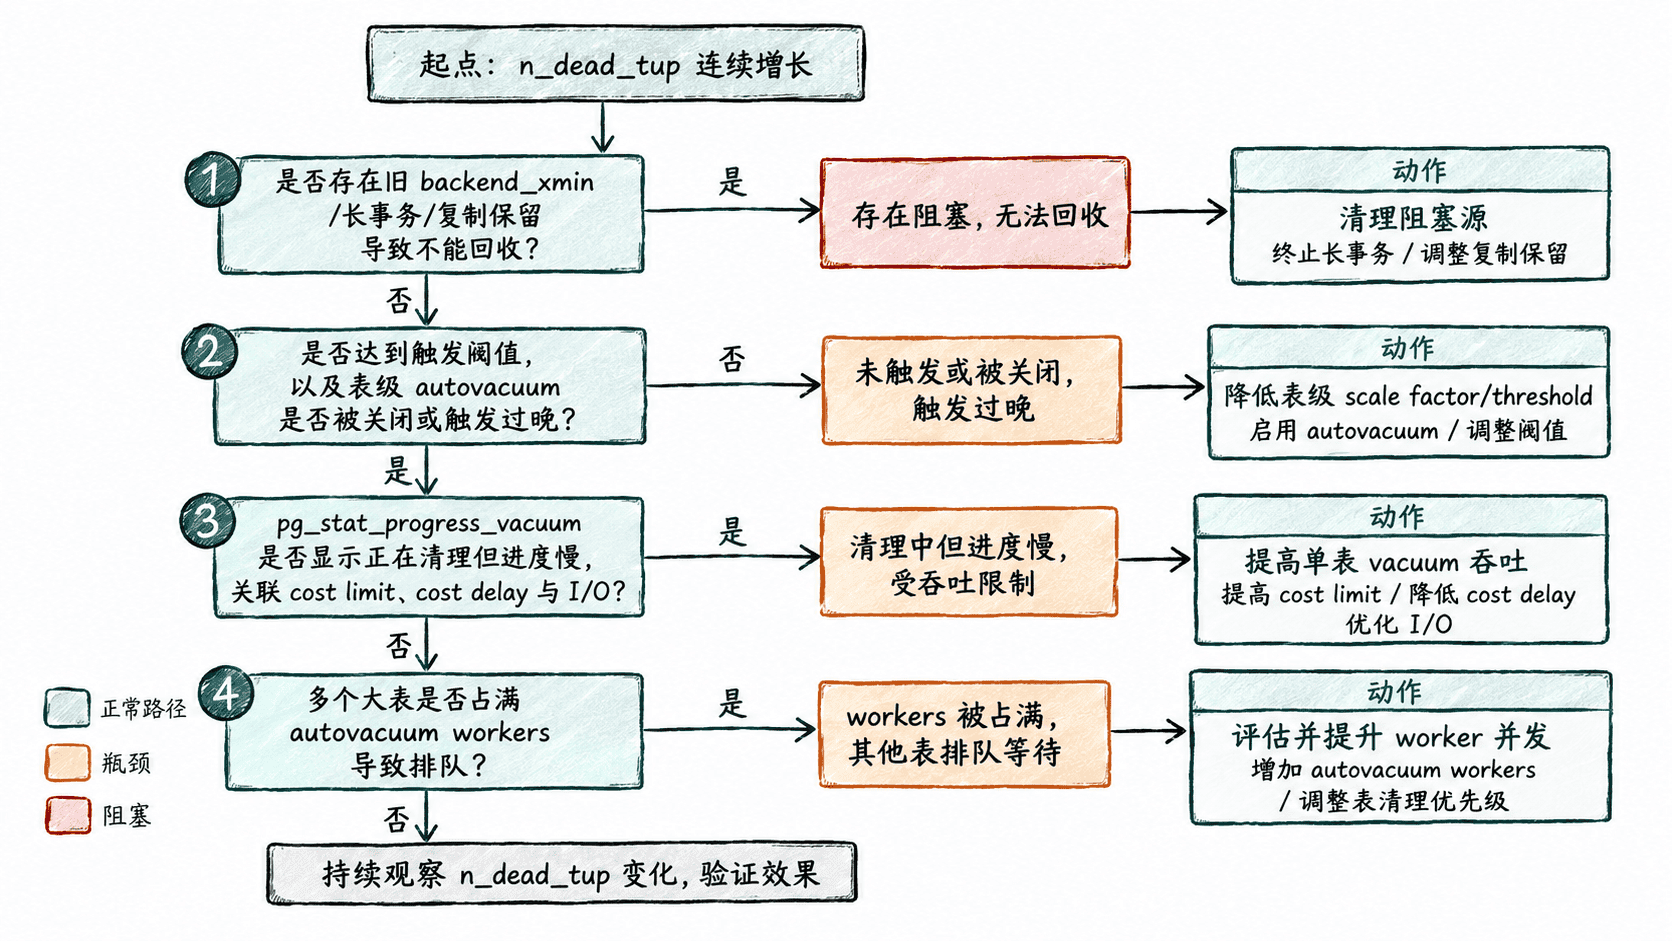
先确认当前是否真的有 Vacuum 在跑,以及它停留在哪个阶段。
SELECT
    pid,
    datname,
    relid::regclass AS relation,
    phase,
    heap_blks_scanned,
    heap_blks_total
FROM pg_stat_progress_vacuum
ORDER BY pid;
预期结果
pid   | datname    | relation    | phase        | heap_blks_scanned | heap_blks_total
------+------------+-------------+--------------+-------------------+----------------
<PID> | <DATABASE> | app.<TABLE> | <PHASE>      | <VALUE>           | <VALUE>
结果为空不一定是故障,只表示采样瞬间没有普通 VACUUM/Autovacuum 正在执行。若目标表持续积压但长期看不到任务,应优先检查触发参数和 worker 排队;若一直有任务却很慢,则再看 I/O 与 cost-based delay。
先清除“不能回收”的阻塞源
旧事务或其他保留源可以让 Vacuum 扫过表,却无法清掉仍可能被某个快照看到的版本。先按 backend_xmin 年龄找出最老会话,再检查复制槽是否持有较老的 xmin 或 catalog_xmin。
SELECT
    pid,
    usename,
    state,
    age(backend_xmin) AS xmin_age,
    now() - xact_start AS xact_age,
    left(query, 120) AS query
FROM pg_stat_activity
WHERE backend_xmin IS NOT NULL
ORDER BY age(backend_xmin) DESC
LIMIT 10;

SELECT
    slot_name,
    slot_type,
    active,
    age(xmin) AS xmin_age,
    age(catalog_xmin) AS catalog_xmin_age
FROM pg_replication_slots
WHERE xmin IS NOT NULL OR catalog_xmin IS NOT NULL
ORDER BY greatest(
    coalesce(age(xmin), 0),
    coalesce(age(catalog_xmin), 0)
) DESC;
预期结果
pid   | usename | state                 | xmin_age | xact_age | query
------+---------+-----------------------+----------+----------+----------------
<PID> | <USER>  | idle in transaction  | <VALUE>  | <TIME>   | <QUERY>

slot_name | slot_type | active | xmin_age | catalog_xmin_age
----------+-----------+--------+----------+-----------------
<SLOT>    | <TYPE>    | <BOOL> | <VALUE>  | <VALUE>
真正异常的是“年龄长期增长且没有业务必要性”的保留源。先确认调用方、复制或逻辑消费需求,再结束会话、修复事务边界或处理失效复制槽;不要为了让 Vacuum 变快而直接删除仍在使用的 slot。
再调整触发时机和单表吞吐
阻塞源排除后,如果高更新大表总要积累很久才启动 Vacuum,可优先做表级配置,而不是立即修改全实例。下面的数值只是演示起点:它让 app.orders 更早达到普通 Vacuum 触发条件,并给该表更高的 cost budget;上线前必须结合磁盘余量、延迟和邻居表负载做压测。
ALTER TABLE app.orders SET (
    autovacuum_vacuum_scale_factor = 0.02,
    autovacuum_vacuum_threshold = 5000,
    autovacuum_vacuum_cost_limit = 2000
);
预期结果
ALTER TABLE触发过晚时先调 autovacuum_vacuum_scale_factor 和 autovacuum_vacuum_threshold;已经持续运行但清理速度仍低于更新速度时,再考虑提高 cost limit 或减少 cost delay。只有当多个数据库或大表长期同时等待 worker 时,才评估增加实例级 worker 并发,因为 worker 更多会同时放大 CPU、缓存和 I/O 压力。
用普通 VACUUM 做受控恢复和验收
在已经处理旧快照并确认业务负载允许后,可以对目标表执行一次普通 VACUUM,快速验证“现在是否已经具备可回收条件”。VERBOSE 便于观察过程,ANALYZE 同时刷新规划器统计。
VACUUM (VERBOSE, ANALYZE) app.orders;预期输出
INFO:  vacuuming "<DATABASE>.app.orders"
<DETAILS>
VACUUM
<DETAILS> 中的页数、dead tuple 数量和 I/O 信息依数据规模而变化。执行后再检查表级统计;手工 Vacuum 更新的是 last_vacuum,后续 Autovacuum 成功运行才会推进 last_autovacuum 和 autovacuum_count。
SELECT
    relname,
    n_dead_tup,
    last_vacuum,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
WHERE relid = 'app.orders'::regclass;
预期结果
relname | n_dead_tup | last_vacuum | last_autovacuum | autovacuum_count
--------+------------+-------------+-----------------+-----------------
orders  | <VALUE>    | <TIME>      | <TIME>          | <VALUE>
验收不要只看一次 n_dead_tup 下降,而要观察至少数个业务更新周期:积压峰值应被周期性拉回,Autovacuum 周期稳定,最老 backend_xmin 不再无界增长,同时数据库延迟和 I/O 没有因调参明显恶化。达到这个状态,才说明清理能力真正追上了更新速度。