
PostgreSQL / 系统课时
拆解 VACUUM 的执行阶段
拆解 VACUUM 的执行阶段
VACUUM 不是一次“把死元组删掉”的单动作,而是一组相互衔接的清理工作。本课把一次普通 VACUUM 拆成堆扫描、死元组识别、索引清理、堆页回收与尾部截断,帮助你读懂日志和进度信息。
学习目标
- 说清 VACUUM 从扫描堆页到清理索引的大致执行顺序。
- 理解死元组、索引死项与可复用空间之间的关系。
- 使用进度视图观察正在运行的 VACUUM,并知道哪些阶段可能最耗时。
从业务现象理解清理链路
一张频繁 UPDATE、DELETE 的表会留下旧行版本。只要这些版本已经不可能被任何仍然有效的快照看到,VACUUM 就可以把它们判定为可回收对象;但堆表与索引是分开的物理结构,因此清理不会只发生在一个位置。
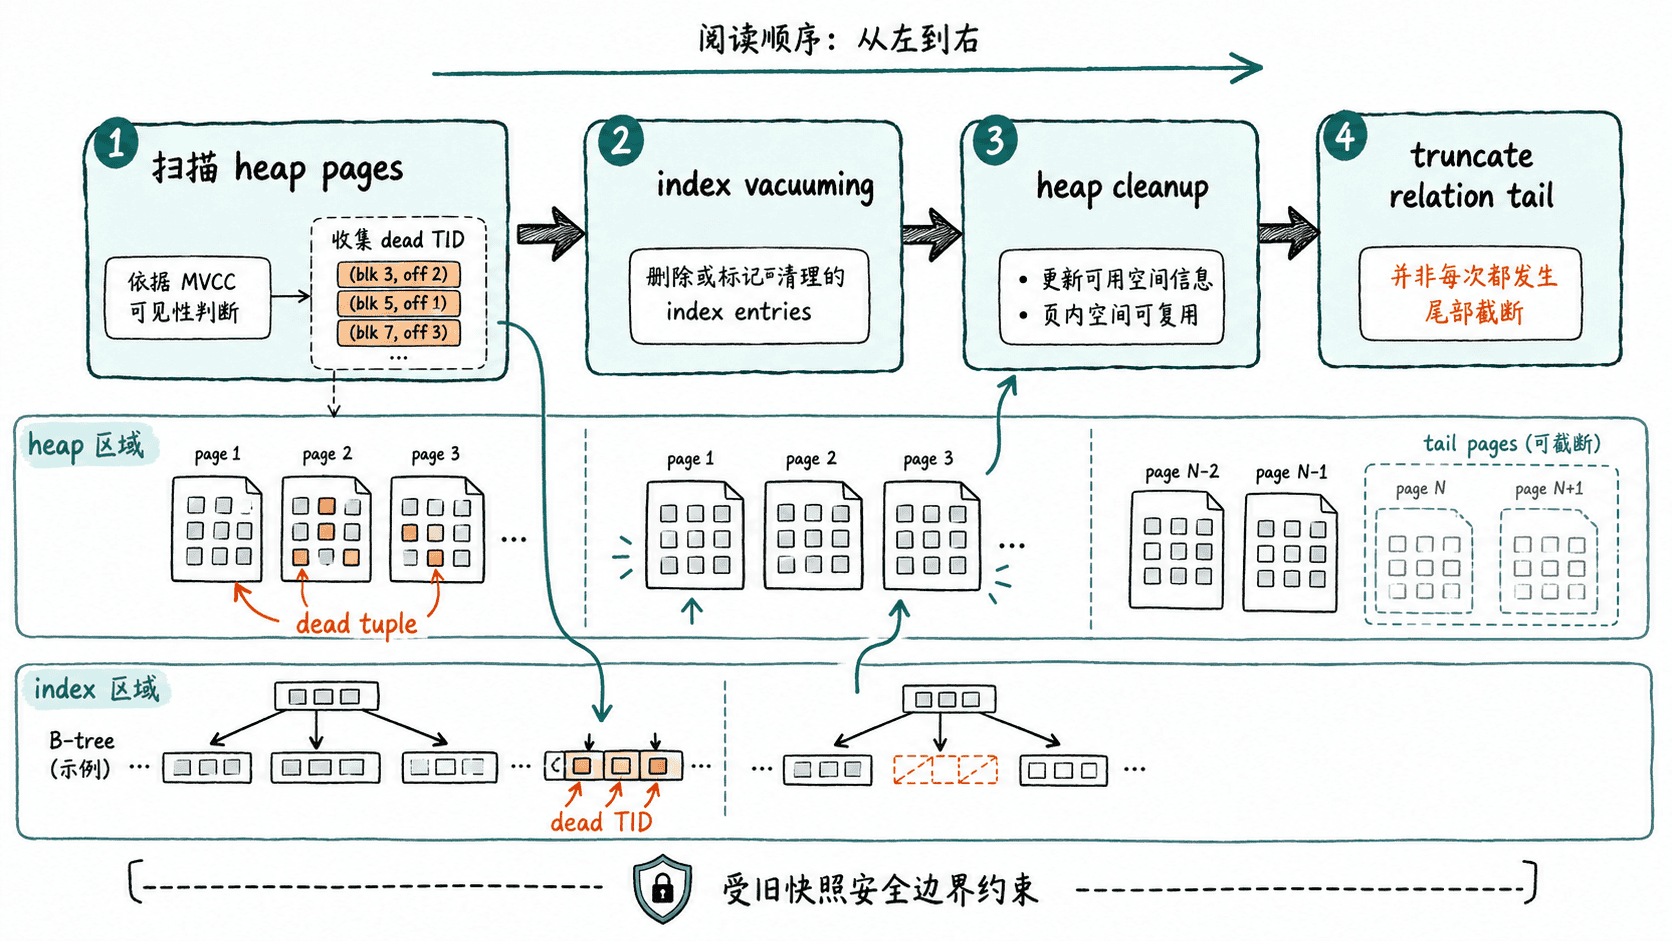
第一阶段是扫描堆页。VACUUM 检查页中的元组状态,并结合当前可回收边界判断哪些旧版本已经彻底失去可见性。仍可能被长事务、复制槽或其他安全边界需要的版本不能回收,因此“看起来很旧”不等于“现在就能删”。
当发现可回收元组后,VACUUM 会记录这些元组的位置,也就是 TID。索引项保存的正是指向堆元组的定位信息,所以这些 TID 会成为后续索引清理的依据。实现细节会随 PostgreSQL 版本、索引访问方法和运行参数变化,但核心关系始终是先确认堆中的旧版本安全失效,再处理相关索引引用。
索引清理与堆页回收
普通 UPDATE 若不能使用 HOT,会为新版本创建新的索引项;旧索引项则需要等 VACUUM 识别到对应旧元组已经可回收后再清理。索引清理完成后,堆页上原先由死元组占用的空间才可以更完整地进入后续复用流程。
堆页内部被释放的空间通常不会立即返还给操作系统,而是登记为该关系未来可再次使用的空间。后续 INSERT 或 UPDATE 生成新元组时,可以优先落入这些已有页,从而避免持续向文件尾部扩张。
尾部截断是另一个独立动作:只有关系文件末尾形成了连续、可释放的空页,并且 VACUUM 能安全取得所需锁时,才可能把这些尾页截掉。因此,看到 dead tuples 明显下降,并不意味着表文件尺寸一定同步缩小。
观察正在运行的 VACUUM
可以用 pg_stat_progress_vacuum 查看当前正在执行的 VACUUM。下面的查询只读取系统视图,不会改变数据库状态。
SELECT
    pid,
    relid::regclass AS relation,
    phase,
    heap_blks_scanned,
    heap_blks_total,
    index_vacuum_count
FROM pg_stat_progress_vacuum
ORDER BY pid;
预期输出:有 VACUUM 正在运行时会返回一行或多行;没有正在运行的 VACUUM 时结果为空。阶段名称和计数会随执行进度变化,实际 PID、关系名和数字也会不同。
 pid  | relation | phase                  | heap_blks_scanned | heap_blks_total | index_vacuum_count
------+----------+------------------------+-------------------+-----------------+-------------------
 <ID> | <TABLE>  | <CURRENT_PHASE>        | <VALUE>           | <VALUE>         | <VALUE>
重点不是死记 phase 的所有字符串,而是把进度状态映射回“扫描堆、处理索引、清理堆、尝试截断”这条主线。若扫描阶段长期不前进,要看 I/O 与锁;若清理受阻或死元组迟迟降不下来,则继续检查长事务、旧快照和其他阻碍回收边界的因素。
读懂阶段之间的因果关系
VACUUM 的关键不是“删除越快越好”,而是在 MVCC 安全边界内,把堆中已失效的版本、索引中的过期引用和页内可用空间协调起来。只有理解这条链路,才能解释为什么某次 VACUUM 很忙却没有缩文件、为什么索引仍可能膨胀,以及为什么长事务会把后续清理一起拖住。