
PostgreSQL / 系统课时
评估表、索引与 TOAST 膨胀
评估表、索引与 TOAST 膨胀
看到一个关系从几十 GB 长到几百 GB,不能直接把增长全部叫作“表膨胀”。PostgreSQL 的主表 heap、索引和 TOAST 各自占空间、各自形成碎片,也需要不同的测量方法。本课先拆清空间归属,再用统计视图和扩展函数验证哪里真的存在可回收或低密度空间。
学习目标
- 分清主表 heap、主表索引与 TOAST 的空间占用
- 用内置大小函数和统计视图完成低成本初筛
- 用
pgstattuple、pgstattuple_approx与pgstatindex对不同对象做进一步量化
先把“变大”拆成三个对象
普通表至少要分开看 heap、索引和 TOAST。heap 保存普通行版本;索引有独立页结构和分裂历史;当可变长字段过大时,数据可能被压缩或移到关联 TOAST 表,TOAST 自己还有索引。
所以“总大小增长”只说明容量在增加,不等价于“可回收膨胀增加”。先确认增长落在哪个对象,再讨论 VACUUM、REINDEX 或表重写是否有价值。
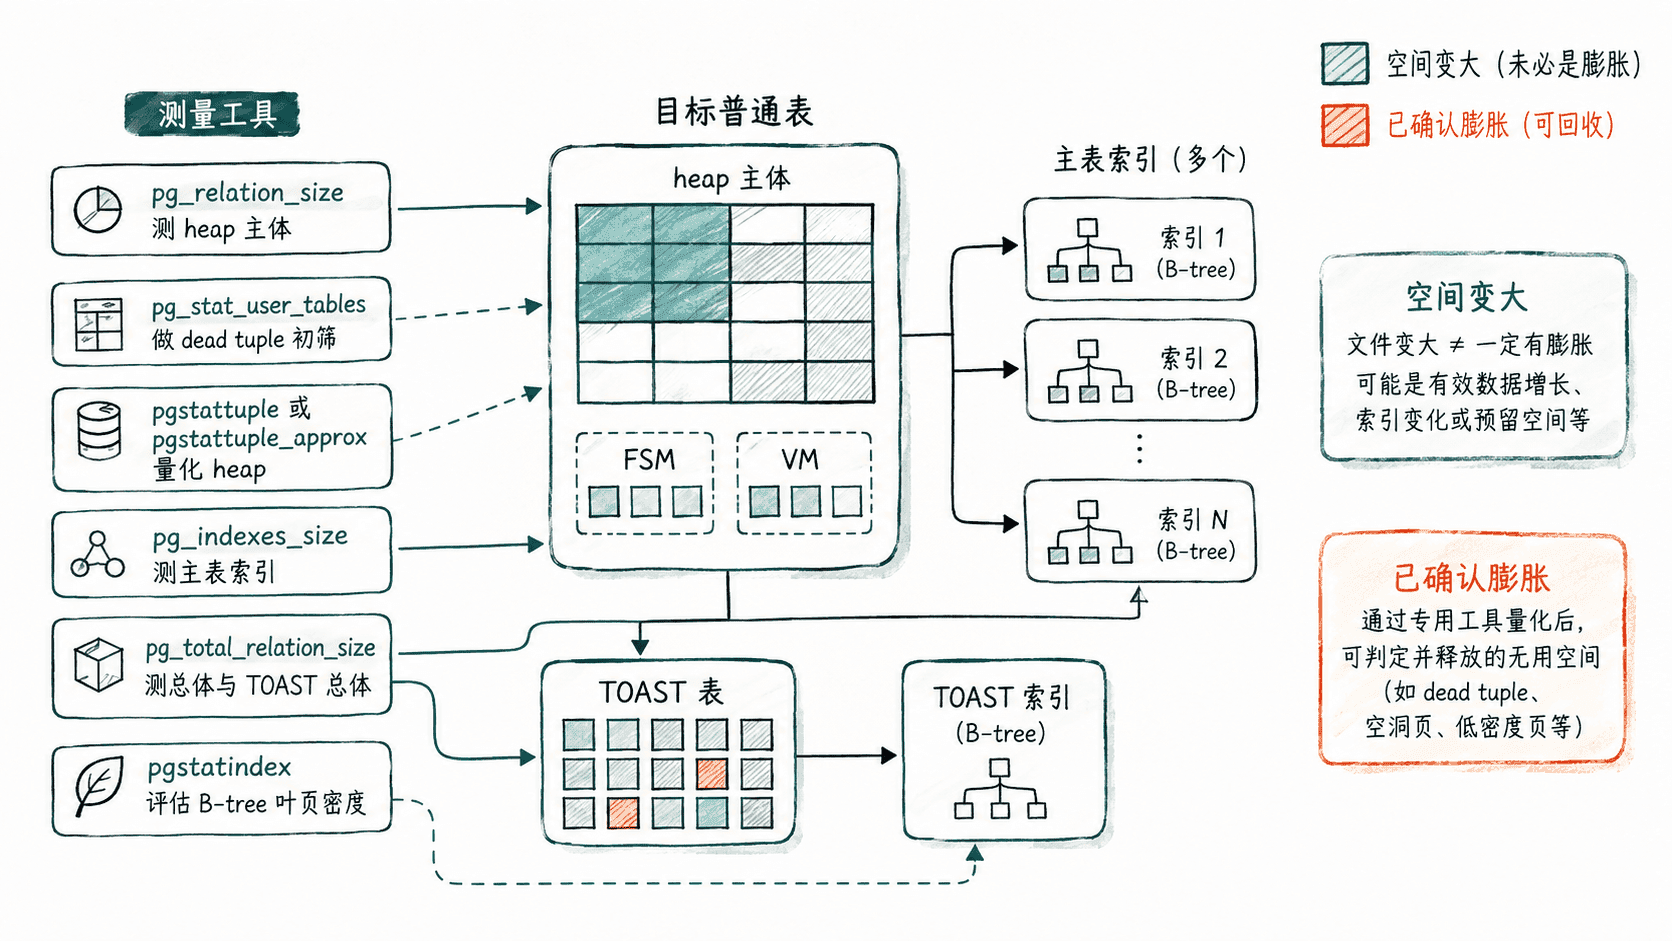
用内置函数做第一轮空间归因
下面以 public.orders 为目标表。pg_relation_size 看主表主体,pg_indexes_size 汇总主表索引,reltoastrelid 找到关联 TOAST 关系,pg_total_relation_size 则给出 PostgreSQL 的总体磁盘占用口径。
WITH target AS (
  SELECT c.oid,
         c.reltoastrelid
  FROM pg_class AS c
  WHERE c.oid = 'public.orders'::regclass
)
SELECT pg_size_pretty(pg_relation_size(oid)) AS heap_main,
       pg_size_pretty(pg_indexes_size(oid)) AS main_indexes,
       CASE
         WHEN reltoastrelid = 0 THEN '0 bytes'
         ELSE pg_size_pretty(pg_total_relation_size(reltoastrelid))
       END AS toast_total,
       pg_size_pretty(pg_total_relation_size(oid)) AS relation_total
FROM target;
预期输出
 heap_main | main_indexes | toast_total | relation_total
-----------+--------------+-------------+----------------
 <VALUE>   | <VALUE>      | <VALUE>     | <VALUE>
实际大小会随数据变化。这里最重要的是比例:如果 main_indexes 接近或超过 heap,优先查索引增长;如果 toast_total 异常大,重点看宽字段更新与 TOAST churn;如果主要是 heap 变大,再进入死元组和空闲空间测量。
主表先筛查,再做精确或近似测量
pg_stat_user_tables.n_dead_tup 是统计系统给出的死元组估计,适合便宜地筛出候选表,但它不是物理扫描结果。对很大的 heap,可以使用 pgstattuple_approx 近似量化死元组和空闲空间;要先安装 pgstattuple 扩展,并确保当前账号具有相应执行权限。
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       autovacuum_count
FROM pg_stat_user_tables
WHERE relid = 'public.orders'::regclass;

SELECT table_len,
       scanned_percent,
       approx_tuple_count,
       dead_tuple_count,
       dead_tuple_percent,
       approx_free_space,
       approx_free_percent
FROM pgstattuple_approx('public.orders'::regclass);
预期输出
 relname | n_live_tup | n_dead_tup | last_autovacuum | autovacuum_count
---------+------------+------------+-----------------+-----------------
 orders  | <VALUE>    | <VALUE>    | <TIME>          | <VALUE>

 table_len | scanned_percent | approx_tuple_count | dead_tuple_count | dead_tuple_percent | approx_free_space | approx_free_percent
-----------+-----------------+--------------------+------------------+--------------------+-------------------+--------------------
 <VALUE>   | <VALUE>         | <VALUE>            | <VALUE>          | <VALUE>            | <VALUE>           | <VALUE>
<VALUE> 和 <TIME> 会随环境变化。dead_tuple_percent 高说明存在较多尚未清理的死元组;approx_free_percent 高说明页内存在较多空闲空间,但这些空间通常可以被后续写入复用,并不代表操作系统文件会自动缩小。
B-tree 索引看叶页密度,不只看文件大小
索引文件变大可能来自正常数据增长、页面分裂、删除后的空页或低叶页密度。对 B-tree,可以用 pgstatindex 查看叶页密度和碎片信号;这些指标需要和索引 fillfactor、写入模式及业务增长一起解释。
SELECT index_size,
       leaf_pages,
       deleted_pages,
       avg_leaf_density,
       leaf_fragmentation
FROM pgstatindex('public.orders_pkey'::regclass);
预期输出
 index_size | leaf_pages | deleted_pages | avg_leaf_density | leaf_fragmentation
------------+------------+---------------+------------------+-------------------
 <VALUE>    | <VALUE>    | <VALUE>       | <VALUE>          | <VALUE>
avg_leaf_density 长期明显偏低且索引体积远高于合理预期时,才有必要继续评估 REINDEX。不要把一次低密度读数直接等同于“必须重建”:有意设置较低 fillfactor、高频随机插入以及近期页分裂都可能让密度下降。
TOAST 要按独立关系观察
TOAST 经常被漏掉,因为业务查询操作的是主表,而大字段的真实存储可能已经移到 pg_toast 关系。前面的 toast_total 能先回答“空间是不是主要长在 TOAST”;如果确实异常,再通过主表的 reltoastrelid 找到对应 TOAST 关系,并在有权限、可接受扫描成本的前提下对它执行物理统计。
高频更新 JSON、text、bytea 等宽字段时,即使只改了其中一小部分,也可能产生新的 TOAST 值和旧版本。VACUUM 能回收可见性上已经安全的死元组,但通常不会主动把关系文件压缩回更小尺寸。因此容量治理要区分“可复用空闲空间”和“必须通过重写或重建才能归还文件空间”。
最终判断不要只盯一个百分比:先用大小函数定位增长对象,再用表统计判断死元组压力,用 pgstattuple 系列确认 heap/TOAST 的物理状态,用 pgstatindex 观察 B-tree 叶页密度。把对象和测量方法对应起来,才能避免把正常增长误判成膨胀,也避免对错误的对象执行昂贵重建。