
PostgreSQL / 系统课时
识别长事务与复制保留造成的清理阻塞
识别长事务与复制保留造成的清理阻塞
VACUUM 已经运行,死元组却迟迟不降,先确认是否还有事务或复制消费者需要旧版本。本课按活动会话、两阶段事务和复制保留三个入口收集证据,区分清理边界与锁等待,再选择能验证的修复动作。
学习目标
- 找出可能保留旧版本的事务和复制边界
- 区分元组保留、WAL 保留与表锁等待
- 按责任方处理阻塞并验证清理恢复
从会话的实际快照开始查
以下诊断适用于 PostgreSQL 18,应在主库执行;完整查看其他用户的活动可能需要 pg_read_all_stats 或管理员权限。先查当前数据库的事务年龄与快照边界,不按 query_start 代替事务起点。
-- 只做观测;保留 pid 供后续关联应用日志。
SELECT pid, usename, application_name, state,
       now() - xact_start AS transaction_duration,
       backend_xid::text, age(backend_xid) AS xid_age,
       backend_xmin::text, age(backend_xmin) AS snapshot_age,
       wait_event_type, wait_event,
       left(query, 120) AS query_sample
FROM pg_stat_activity
WHERE datname = current_database()
  AND pid <> pg_backend_pid()
  AND xact_start IS NOT NULL
ORDER BY xact_start;
预期结果:每个有事务的其他会话一行,ID、时长和查询文本随环境变化;没有候选时为 0 行。重点看 idle in transaction、很老的 backend_xid 或 backend_xmin。NULL 年龄不能按 0 解释,表示该项没有当前可见值。视图字段含义见 活动统计参考。
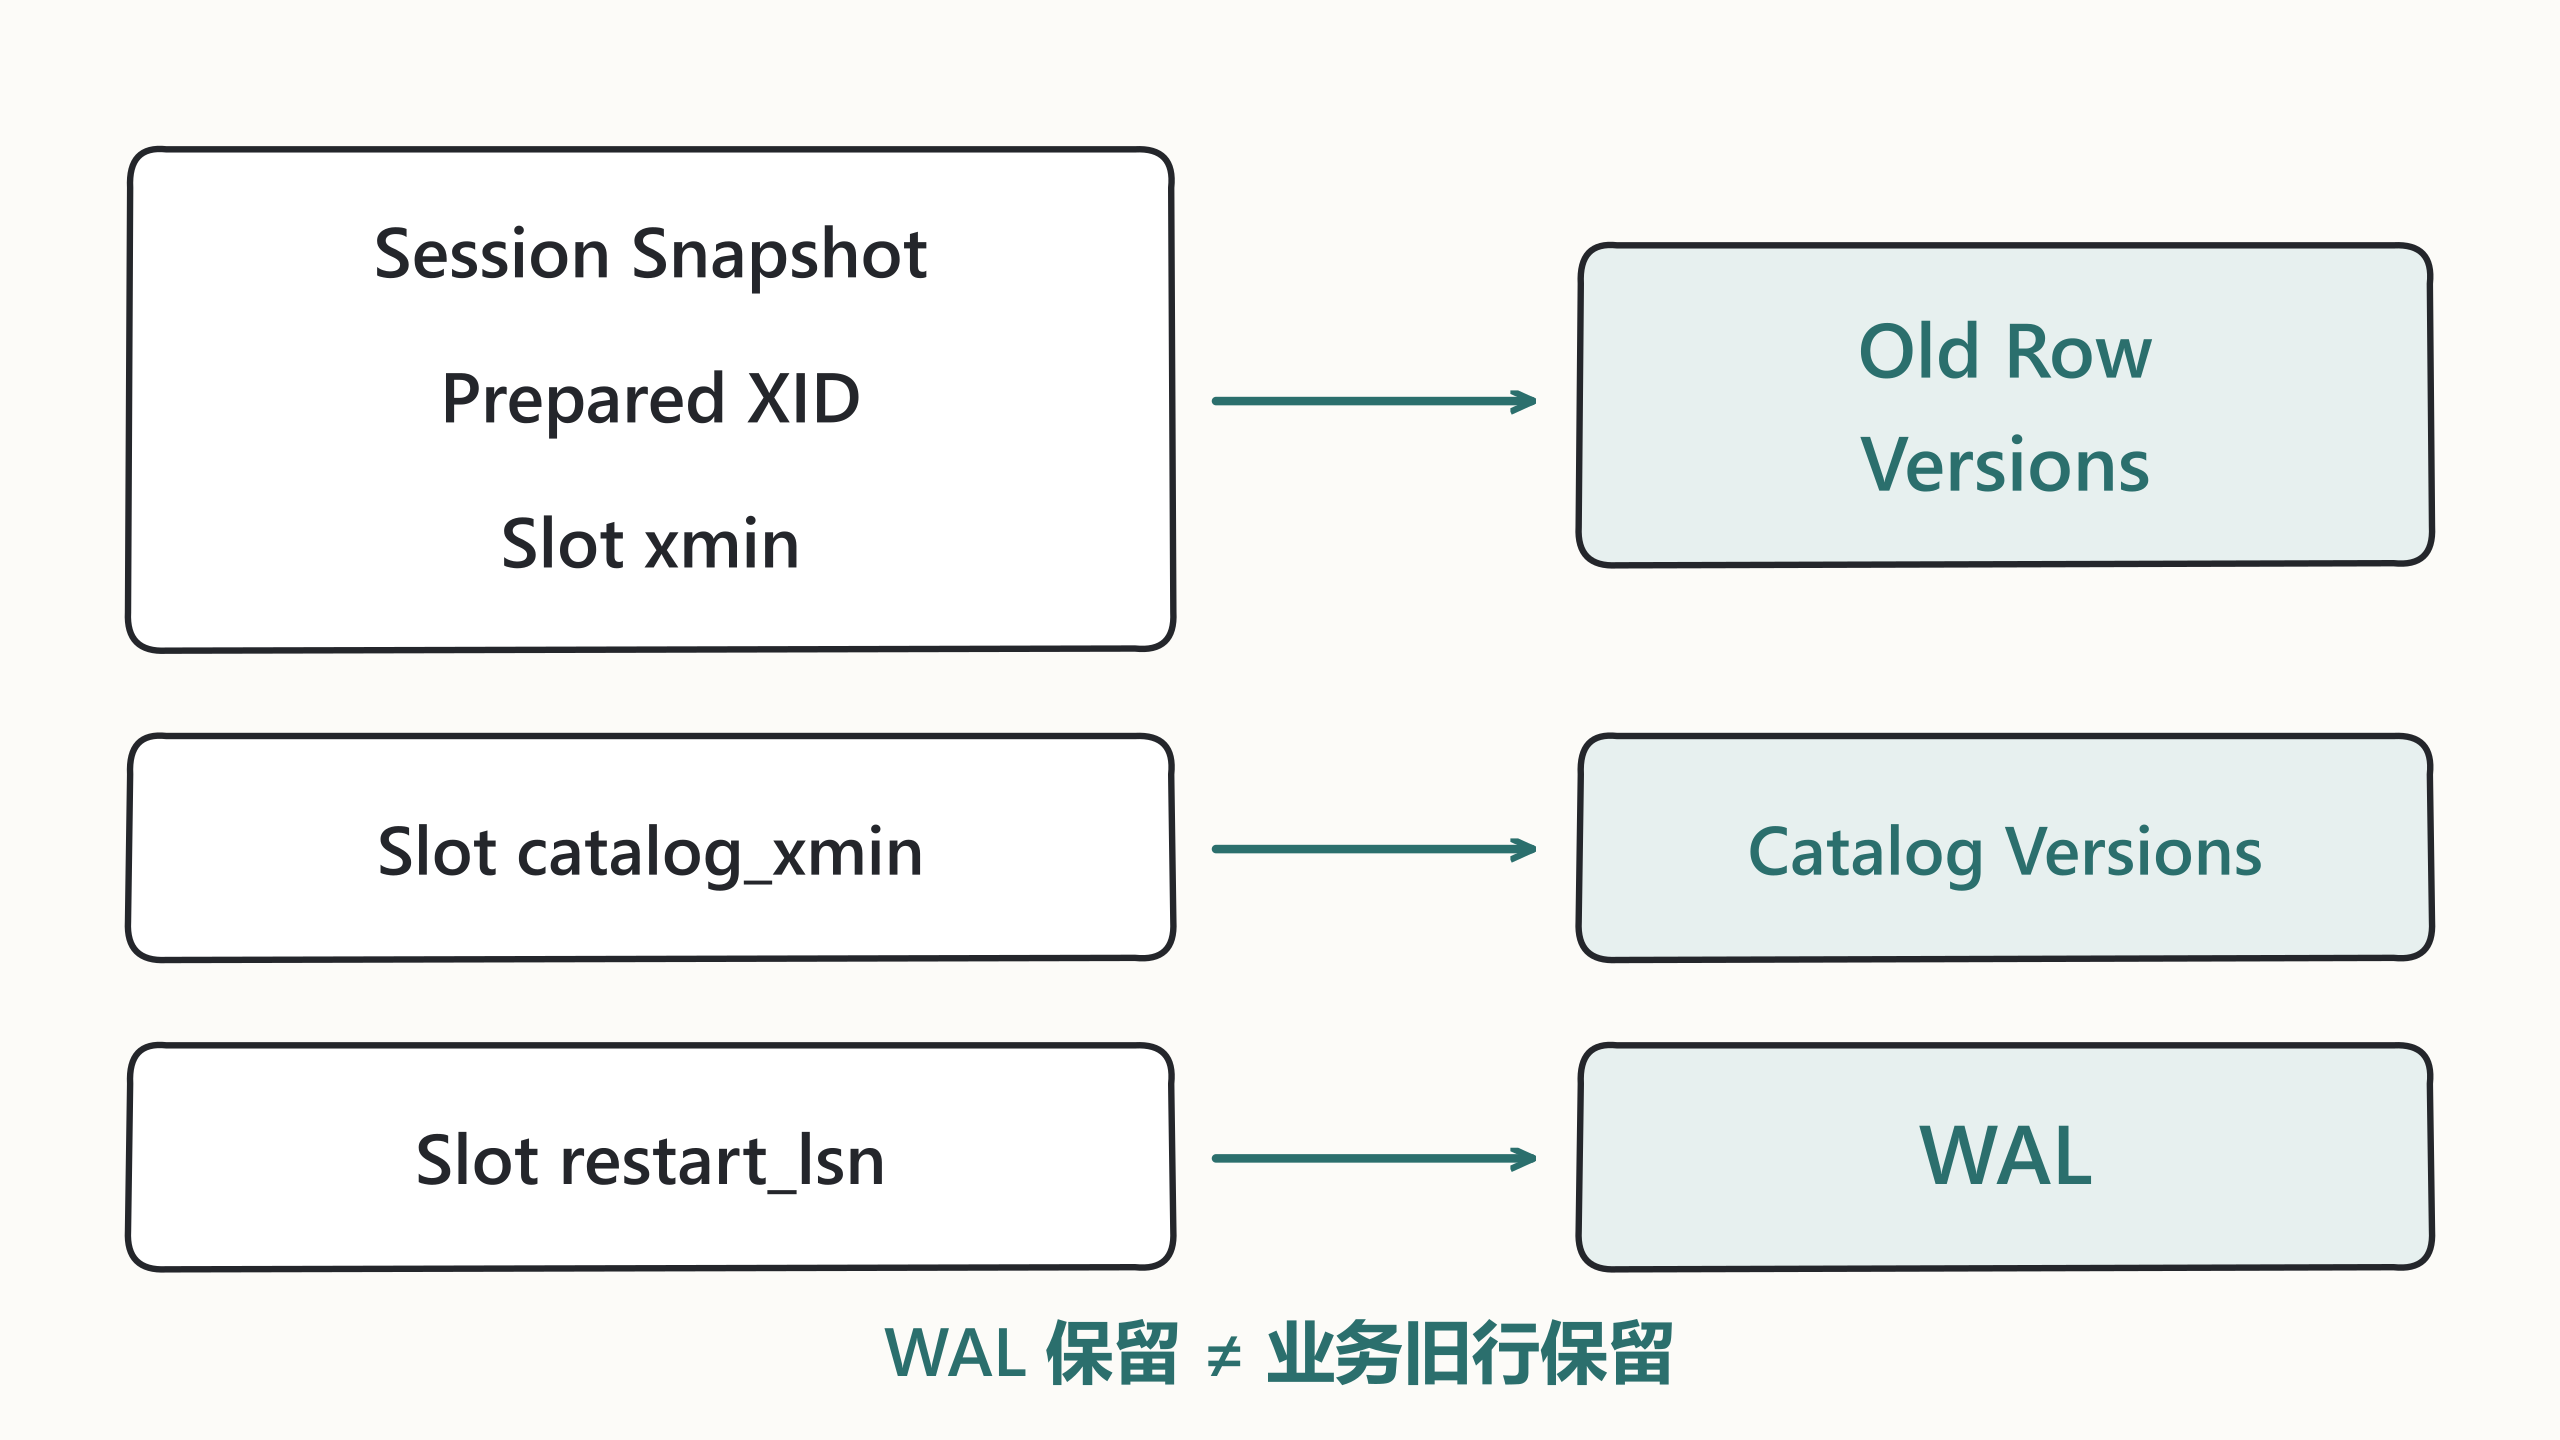
持续 30 分钟的连接不等于持续 30 分钟的事务,持续 30 分钟的事务也不一定持有同样老的快照。以 backend_xmin、隔离级别及实际语句为证据。只读 REPEATABLE READ 会话可能不需要分配写事务 ID,却仍因快照阻止旧版本清理。
再查不挂在普通连接上的事务
prepared transaction 可在客户端断开后继续存在。下面查询不是让你随意回滚,而是找出需要交给事务协调器核对的记录。
SELECT gid, owner, database, prepared,
       now() - prepared AS prepared_duration,
       transaction::text AS xid, age(transaction) AS xid_age
FROM pg_prepared_xacts
ORDER BY prepared;
预期结果:没有两阶段事务时返回 0 行;有记录时,gid 用于关联协调器决策日志。其用途见 prepared transaction 视图。先恢复协调器或由负责人确认最终决策,再执行相应提交、回滚;仅因“看起来很旧”就回滚,会破坏分布式业务一致性。
分开读取复制的三条边界
复制槽的 xmin、catalog_xmin 和 restart_lsn 保留的对象不同。WAL 积压很大不能直接推出业务表的旧行也被保留。以下查询在主库执行:
SELECT slot_name, slot_type, active,
       xmin::text, age(xmin) AS xmin_age,
       catalog_xmin::text, age(catalog_xmin) AS catalog_age,
       restart_lsn,
       pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) AS retained_wal_bytes
FROM pg_replication_slots
ORDER BY slot_name;

SELECT application_name, state, backend_xmin::text,
       age(backend_xmin) AS feedback_age
FROM pg_stat_replication;
预期结果:每个槽或直连备库对应一行,无复制时各为 0 行。xmin 与普通元组清理相关,catalog_xmin 与系统目录旧版本相关,restart_lsn 与所需 WAL 起点相关;字段规则见 复制槽参考。备库的 hot_standby_feedback 也可能通过 backend_xmin 保留清理边界。
不要因为 active=false 就删除槽,暂时停机的正常消费者也会不活跃。先记录槽归属、最后消费时间、恢复速度和重建方案;已确认废弃的消费者才走删除流程。关闭 feedback 可能把主库膨胀问题变成备库查询被取消的问题,需要评估业务影响。
处理之后重新验收
按归属先请应用提交或回滚长事务;取消一条查询不等于结束整个事务,idle in transaction 会话甚至没有正在运行的语句可取消。必须核对事务是否真正消失。紧急终止会话要明确其回滚量、重试行为和业务责任人。
解除保留后,在自动提交模式下对已确认的目标表执行 VACUUM (VERBOSE, ANALYZE),比较清理日志、年龄和后续采样。n_dead_tup 是估计值,统计刷新有延迟;不要把一次采样没下降当成修复失败,也不要要求普通 VACUUM 必须缩小文件。
若 VACUUM 自己在等待锁,使用 pg_blocking_pids(pid)、wait_event 和 pg_locks 定位阻塞者。这和“扫描完成但旧元组尚不能回收”是两条排障路径。记录修复前后边界、处理对象与业务延迟,才能确认清理恢复且没有把问题转移到复制或应用重试。