
PostgreSQL / 系统课时
理解 Visibility Map 与 Index-Only Scan
理解 Visibility Map 与 Index-Only Scan
Index-Only Scan 并不意味着 PostgreSQL 永远不访问 heap。执行器能否只靠索引返回结果,还取决于目标 heap 页在 Visibility Map 中是否标记为 all-visible。本课把索引、Visibility Map 与 heap 页连起来,并用一次可重复实验观察 Heap Fetches 的变化。
学习目标
- 理解 Visibility Map 的 all-visible 与 all-frozen 两个位分别表达什么
- 能解释 Index-Only Scan 为什么仍可能出现 heap 访问
- 能用
VACUUM与EXPLAIN (ANALYZE, BUFFERS)验证可见性位对扫描行为的影响
一个位如何决定是否访问 heap
Visibility Map 为每个 heap 页维护两个状态位。all-visible 表示该页上的元组已知对所有需要考虑的事务可见,因此执行 Index-Only Scan 时无需逐条回 heap 检查 MVCC 可见性;all-frozen 表示页上的元组都已冻结,主要服务于 VACUUM 的冻结与反回卷处理。all-frozen 页必然也是 all-visible,但 Index-Only Scan 直接关心的是 all-visible。
索引项保存的是键值和指向 heap 的 TID,而普通 B-tree 索引本身不保存“这个行版本对当前快照是否可见”的完整 MVCC 结论。因此,即使执行计划写着 Index Only Scan,只要某个目标 heap 页的 all-visible 位没有设置,执行器仍要访问该页确认可见性,并把这些回表次数计入 Heap Fetches。
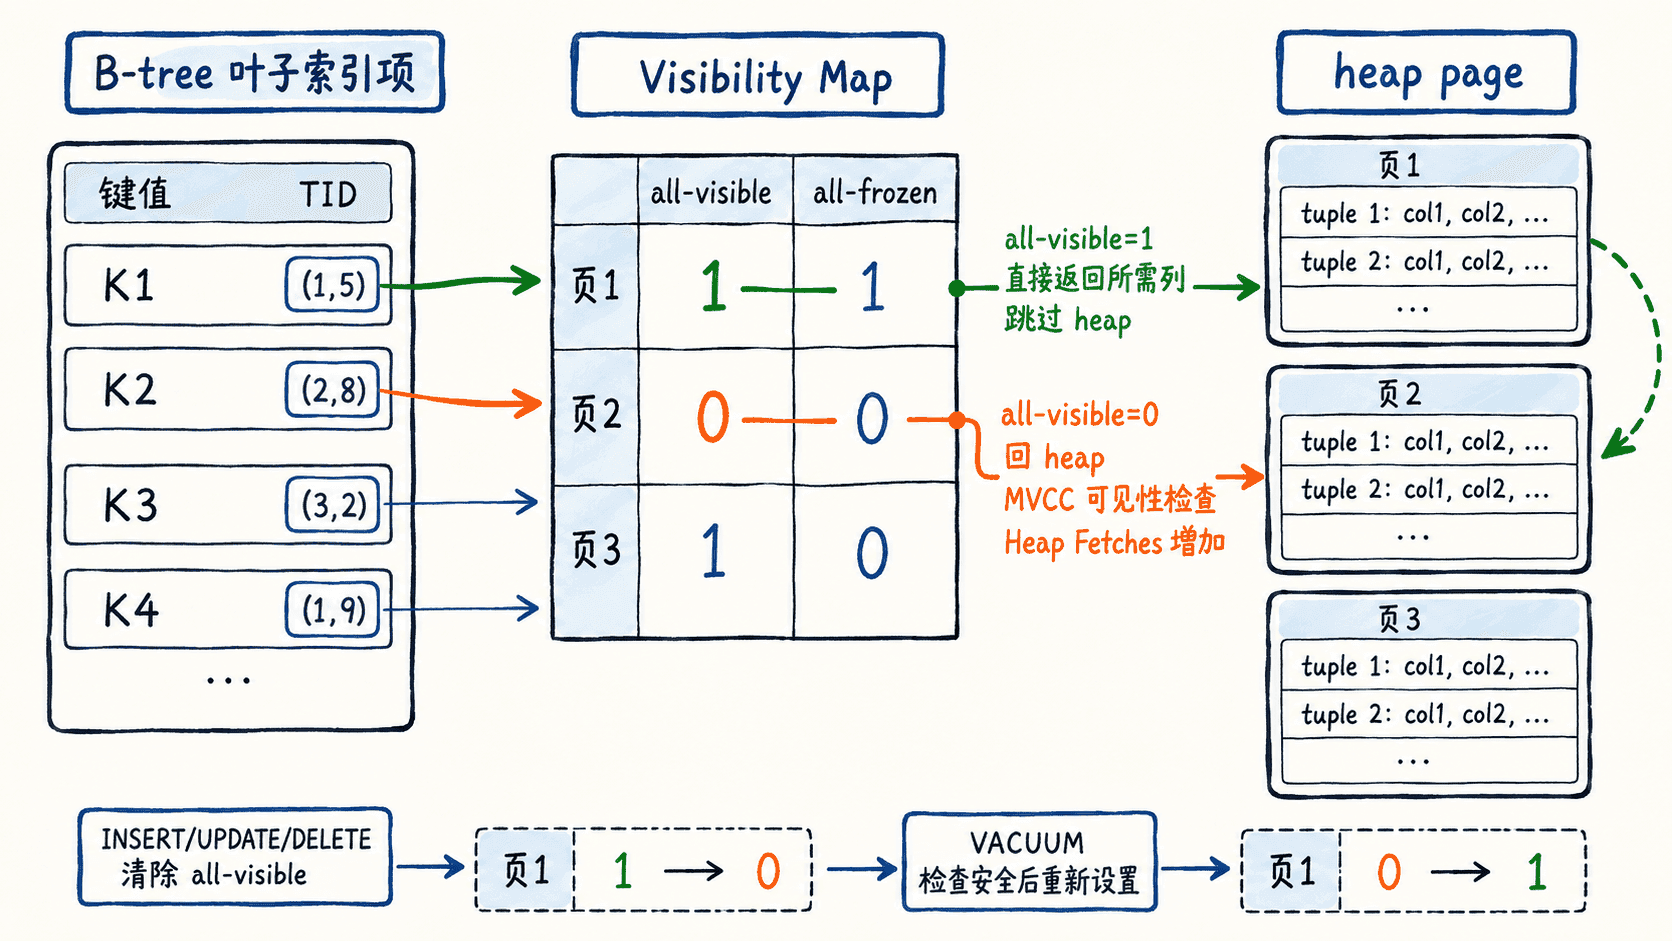
用同一查询观察 Heap Fetches
下面建立一张带主键索引的测试表。查询只读取主键列,因此索引本身已经覆盖所需数据;SET enable_seqscan = off 仅用于让实验更稳定地选择索引路径,不是生产调优建议。
DROP TABLE IF EXISTS vm_demo;

CREATE TABLE vm_demo (
    id bigint PRIMARY KEY,
    payload text NOT NULL
);

INSERT INTO vm_demo
SELECT g, repeat('x', 80)
FROM generate_series(1, 100000) AS g;

VACUUM (ANALYZE) vm_demo;

SET enable_seqscan = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM vm_demo
WHERE id BETWEEN 1000 AND 2000;
预期输出(成本、耗时和 buffer 数字会变化):
Index Only Scan using vm_demo_pkey on vm_demo  (cost=<VALUE> rows=<VALUE> width=8) (actual time=<VALUE> rows=1001 loops=1)
  Index Cond: ((id >= 1000) AND (id <= 2000))
  Heap Fetches: 0
  Buffers: shared hit=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
VACUUM 检查这些页后可以把满足条件的页设为 all-visible,所以执行器只从主键索引取得 id,通常不需要回 heap。这里的关键观察值是 Heap Fetches: 0,而不是执行时间本身。
写入如何让 Index-Only Scan 重新回表
对 heap 页执行 INSERT、UPDATE 或 DELETE 后,受影响页原有的 all-visible 状态会被清除,因为系统不能再假定整页对所有快照都可直接判定为可见。下面更新一小段非索引列,再运行同一查询:
UPDATE vm_demo
SET payload = payload || 'y'
WHERE id BETWEEN 1000 AND 1100;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM vm_demo
WHERE id BETWEEN 1000 AND 2000;
预期输出:
UPDATE 101
Index Only Scan using vm_demo_pkey on vm_demo  (cost=<VALUE> rows=<VALUE> width=8) (actual time=<VALUE> rows=1001 loops=1)
  Index Cond: ((id >= 1000) AND (id <= 2000))
  Heap Fetches: <VALUE>
  Buffers: shared hit=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
此时 <VALUE> 的具体数值由受影响页数、HOT 更新、页布局和并发状态决定,但通常会大于 0。注意计划节点仍叫 Index Only Scan:这个名字描述的是“查询所需列可以由索引提供”,并不保证每个候选 TID 都无需 heap 可见性检查。
再次执行 VACUUM (ANALYZE) vm_demo 后,如果没有旧快照阻止清理、这些页也满足 all-visible 条件,同一查询的 Heap Fetches 通常会重新接近或回到 0。
Index-Only Scan 真正成立的边界
要获得稳定的少回表收益,需要同时满足三个条件:索引访问方法支持 Index-Only Scan;查询所需列都能由索引返回,例如键列或合适的 INCLUDE 列;目标 heap 页还要有足够高的 all-visible 覆盖率。缺任何一个条件,都不能把“有索引”直接等同于“不会读 heap”。
更新频繁的表即使有覆盖索引,all-visible 位也会不断被写入清除,因此 Heap Fetches 可能长期偏高。相反,写少读多、VACUUM 能及时推进的历史数据页更容易保持 all-visible,Index-Only Scan 的收益通常更稳定。判断这类优化是否有效,应同时看执行计划是否选择 Index-Only Scan,以及实际执行中的 Heap Fetches,而不是只看计划节点名称。