
PostgreSQL / 系统课时
理解长事务对版本回收的影响
理解长事务对版本回收的影响
PostgreSQL 的 MVCC 允许读写并发,但代价是旧行版本不能随更新立刻删除。真正危险的长事务往往不是一直占着表锁,而是长期保留旧快照,让 VACUUM 无法回收仍可能被该快照看见的版本,最终放大膨胀与维护压力。
学习目标
- 解释长时间持有旧快照为什么会推迟 dead tuple 的安全回收。
- 用受控更新与 VACUUM 实验验证旧快照仍能读取旧版本。
- 通过
pg_stat_activity找出长事务,并把事务时长转化为可执行的工程约束。
旧快照如何拖住回收边界
UPDATE 和 DELETE 不会立即把旧元组从堆表中物理擦除。旧版本只有在系统确认任何仍然相关的事务都不可能再看见它之后,才具备被 VACUUM 回收的条件;普通 VACUUM 回收后通常只是让空间可在表内复用,并不保证把文件空间归还给操作系统。
如果一个 Repeatable Read 事务先建立了旧快照,其他会话随后更新大量行,那么这个旧事务仍可能需要更新前的版本。VACUUM 可以继续运行,但不能越过安全可见性边界删除这些仍有潜在读者的版本。结果常表现为 dead tuple 积累、表和索引膨胀风险上升,以及后续 VACUUM 需要处理更多垃圾版本。
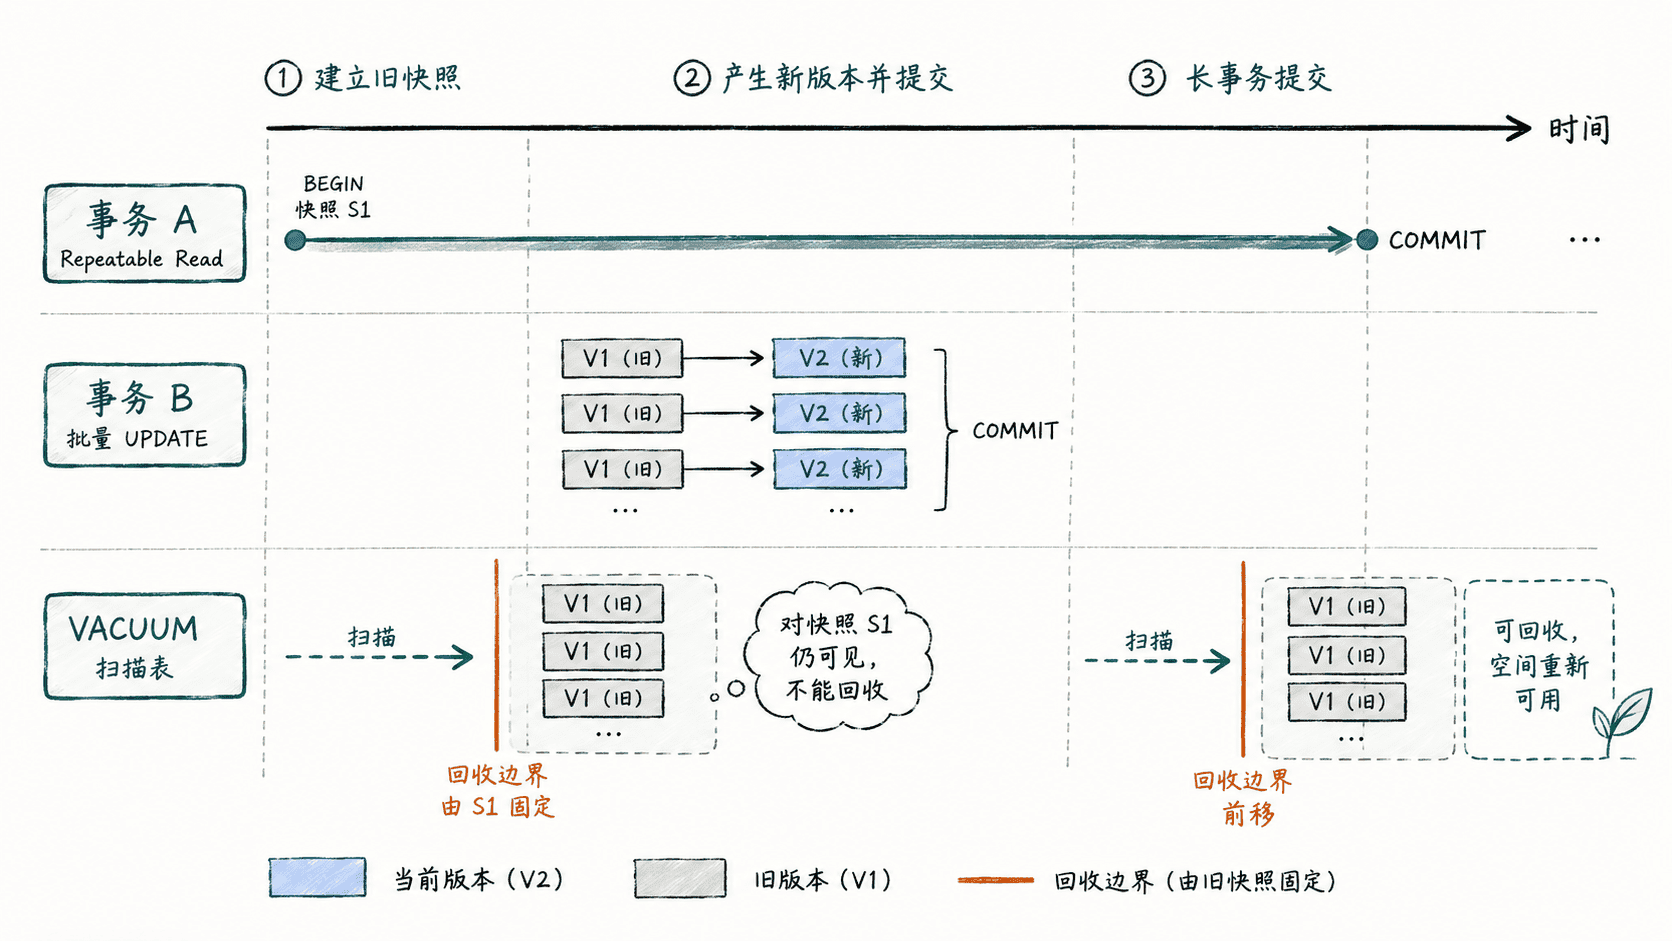
用受控实验观察旧版本被保留
在测试数据库创建 10000 行数据。实验会更新整张表,请勿直接在生产表上执行。
DROP TABLE IF EXISTS vacuum_demo;
CREATE TABLE vacuum_demo (
    id integer PRIMARY KEY,
    payload text NOT NULL
);
INSERT INTO vacuum_demo(id, payload)
SELECT g, 'old'
FROM generate_series(1, 10000) AS g;

SELECT count(*) AS old_rows
FROM vacuum_demo
WHERE payload = 'old';
预期结果:最终查询确认 10000 行都处于旧值。
 old_rows
----------
    10000
在会话 A 建立一个 Repeatable Read 快照并保持事务不提交。
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) AS old_rows
FROM vacuum_demo
WHERE payload = 'old';
预期输出:
BEGIN
 old_rows
----------
    10000
在会话 B 更新全部行并执行普通 VACUUM。这里让 B 保持自动提交,确保 VACUUM 不在事务块内执行。
UPDATE vacuum_demo SET payload = 'new';
VACUUM vacuum_demo;

SELECT count(*) AS new_rows
FROM vacuum_demo
WHERE payload = 'new';
预期结果:B 的当前视图已经看到 10000 个新版本,VACUUM 命令本身正常完成。
UPDATE 10000
VACUUM
 new_rows
----------
    10000
回到会话 A 再读一次。即使会话 B 已经更新并执行过 VACUUM,A 仍必须能够按自己的旧快照读取更新前的版本。
SELECT
    count(*) FILTER (WHERE payload = 'old') AS old_rows,
    count(*) FILTER (WHERE payload = 'new') AS new_rows
FROM vacuum_demo;
预期输出:
 old_rows | new_rows
----------+----------
    10000 |        0
这个结果直接说明:旧版本不能因为“已经执行过 VACUUM”就被无条件删除。先结束会话 A,再由会话 B 执行一次 VACUUM,旧版本才失去这个快照读者带来的保护。
-- 会话 A
COMMIT;

-- 会话 B
VACUUM vacuum_demo;
预期输出:
COMMIT
VACUUM
第二次 VACUUM 之后,旧版本占用的空间具备被清理并在表内复用的条件。不要把它误解成文件一定立刻缩小;普通 VACUUM 的主要目标是回收可复用空间,而不是重写整张表。
找出正在固定旧 horizon 的会话
生产环境不要只盯 n_dead_tup。先看哪些会话持有事务以及它们的快照 horizon。xact_start 能帮助判断事务持续时间,backend_xmin 表示该后端当前的 xmin horizon;长时间存在的旧值值得优先调查。
SELECT
    pid,
    state,
    xact_start,
    backend_xmin,
    now() - xact_start AS xact_age
FROM pg_stat_activity
WHERE datname = current_database()
  AND xact_start IS NOT NULL
ORDER BY xact_start;
预期结果:在前面的会话 A 尚未提交时,应能看到对应的长事务行。PID、时间、XID 和持续时长都是动态值,实例中若还有其他事务会返回更多行。
 pid   | state               | xact_start | backend_xmin | xact_age
-------+---------------------+------------+--------------+----------
<PID> | idle in transaction | <TIME> | <XID> | <VALUE>把事务时长变成工程约束
治理重点不是“更频繁地 VACUUM”,而是缩短旧快照存在的时间。应用事务应只覆盖真正需要原子性的数据库操作,避免在事务中等待用户输入、慢 HTTP 调用、长时间计算或队列消费;连接池也要重点告警 idle in transaction。
statement_timeout 只限制单条语句,不能天然限制多条短语句组成的长事务。可在应用层设置事务截止时间,并使用 idle_in_transaction_session_timeout 清理长期空闲的事务;在支持 transaction_timeout 的 PostgreSQL 版本中,还可以为角色或会话设置事务总时长上限。超时策略要先在测试环境验证,避免连接池把服务端主动断开误判为普通查询错误。
如果没有发现长用户事务,但回收边界仍异常,再继续检查 prepared transaction、复制槽等同样可能固定旧 XID 的来源。只有先解除真正的 horizon 阻塞,再调整 autovacuum 阈值和成本参数,才能避免用更高的 VACUUM 频率掩盖根因。