
PostgreSQL / 系统课时
控制锁等待与排队顺序
控制锁等待与排队顺序
锁冲突发生后,真正决定故障半径的是“等多久、谁排在谁前面”。本课解释 PostgreSQL 锁队列为什么会把一次 DDL 等待放大成请求堆积,并用 NOWAIT 与 lock_timeout 把无界等待改成可控失败。
学习目标
- 理解同一锁对象上的等待队列与“后来的请求也被排住”的现象。
- 使用
NOWAIT和lock_timeout分别实现立即失败与限时等待。 - 根据请求延迟预算、重试能力和变更风险选择合适策略。
锁队列如何放大一次 DDL 等待
PostgreSQL 的锁授予不是简单的全局 FIFO,但同一锁对象上的排队会考虑前方等待者,避免强锁长期饥饿。一个典型风险是:会话 A 已持有较弱锁;会话 B 申请 ACCESS EXCLUSIVE 并开始等待;此时会话 C 即使申请的锁与 A 兼容,也可能因为会和排在前面的 B 冲突而继续排队。
这就是“等待中的 DDL 把后续流量一起堵住”的队头放大效应。它解释了为什么某些 DDL 明明还没有拿到锁,却已经让正常查询或写入延迟快速上升。
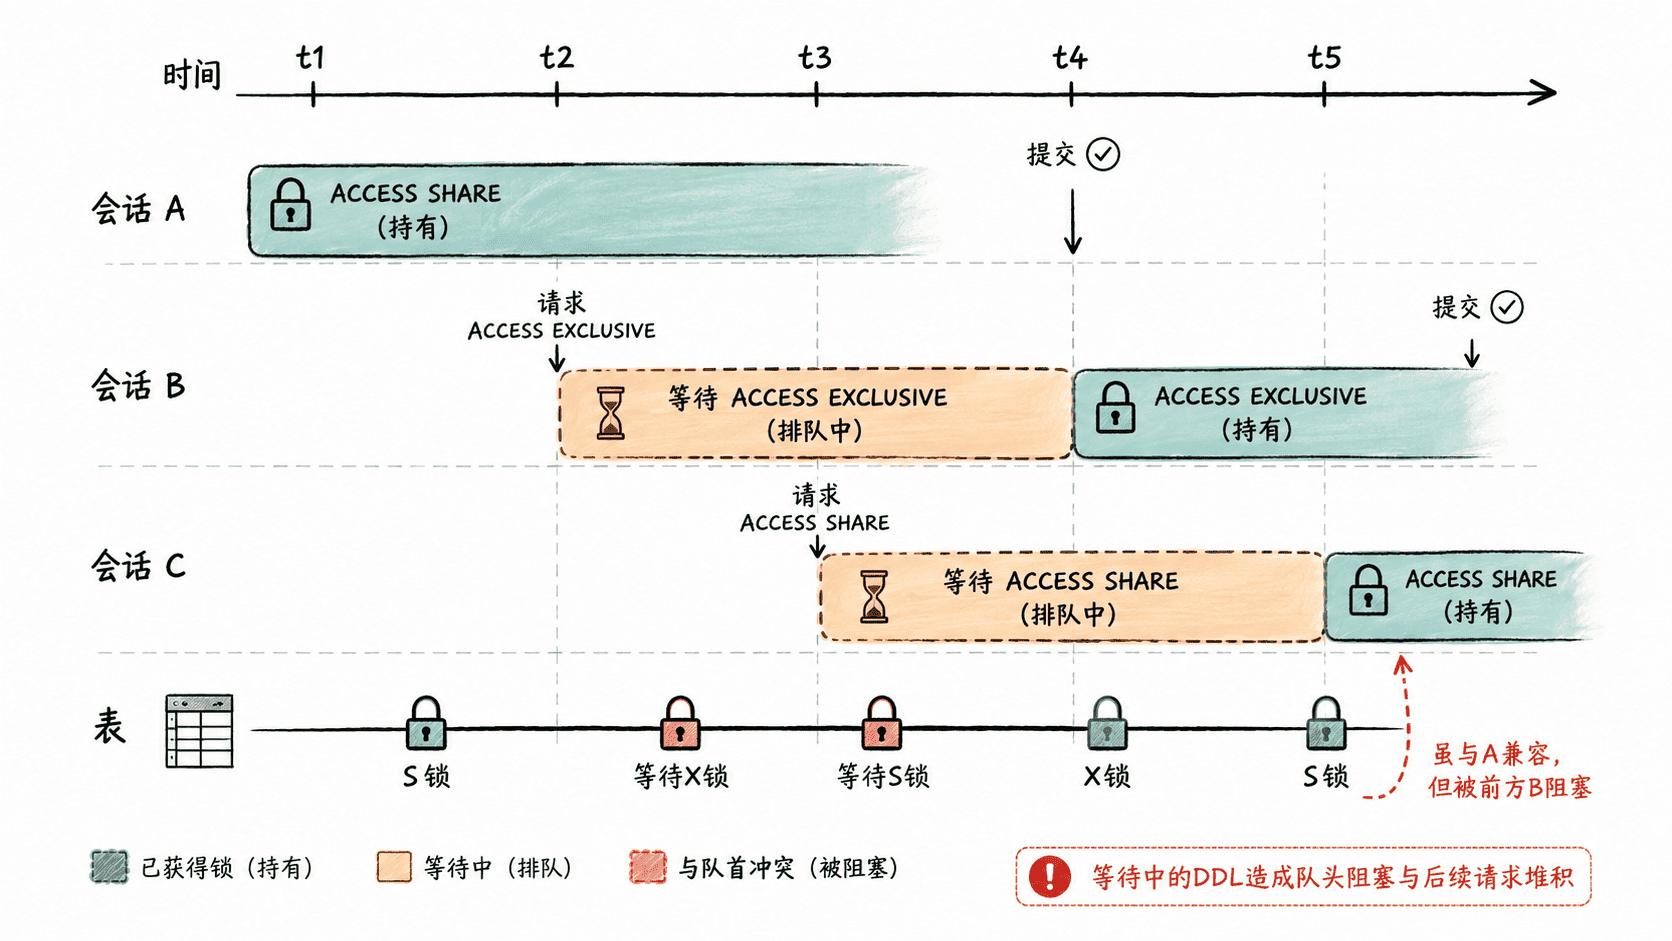
用 NOWAIT 把等待改成立即失败
NOWAIT 适合“拿不到锁就马上走重试或回退分支”的场景。先创建表,并让会话 A 持有强锁。以下为多会话片段示例。
DROP TABLE IF EXISTS lock_queue_lab;
CREATE TABLE lock_queue_lab (id bigint PRIMARY KEY);
预期输出:
DROP TABLE
CREATE TABLE
会话 A:
BEGIN;
LOCK TABLE lock_queue_lab IN ACCESS EXCLUSIVE MODE;
SELECT pg_backend_pid() AS blocker_pid;
预期输出:
BEGIN
LOCK TABLE
 blocker_pid
-------------
 <PID>
(1 row)
会话 B 使用 NOWAIT:
BEGIN;
LOCK TABLE lock_queue_lab IN ACCESS SHARE MODE NOWAIT;
预期输出:
BEGIN
ERROR:  could not obtain lock on relation "lock_queue_lab"
失败后当前事务已处于错误状态,应执行 ROLLBACK 再决定是否重试。NOWAIT 的价值是延迟上界清晰,但代价是调用方必须能处理失败。
用 lock_timeout 给等待加预算
如果短暂等待是可以接受的,比立即失败更合适的做法是设置 lock_timeout。它只约束“等待锁”的时间,不限制语句已经拿到锁后的执行时间。
先确保会话 A 仍持有上面的 ACCESS EXCLUSIVE,然后在新的会话 B 中执行:
BEGIN;
SET LOCAL lock_timeout = '1500ms';
LOCK TABLE lock_queue_lab IN ACCESS SHARE MODE;
预期结果:等待约 1.5 秒后失败,具体时间会有少量调度偏差。
BEGIN
SET
ERROR:  canceling statement due to lock timeout
SET LOCAL 只在当前事务生效,适合迁移脚本或单次关键操作,避免把会话后续语句永久改成同一超时策略。
什么时候应该等,什么时候立即失败
适合等待的请求通常具备两个条件:预期持锁时间很短,而且调用方宁愿多等几百毫秒也不愿承担重试成本。此时用较小的 lock_timeout 给等待设上界,比无限阻塞更稳妥。
适合立即失败的场景包括发布 DDL、延迟敏感接口、可安全重试的任务和任何“排队本身会扩大故障”的操作。NOWAIT 能快速暴露冲突,执行器可以记录阻塞者、退出发布或稍后重试,而不是把连接池耗在等待上。
生产治理不要把 lock_timeout 当作“越小越安全”的全局参数。正确做法是按操作类型设置预算:普通事务允许短等待,批处理允许稍长等待,强 DDL 倾向 NOWAIT 或很短的锁超时。这样才能在吞吐、成功率和尾延迟之间做可解释的取舍。