
PostgreSQL / 系统课时
掌握 Serializable 与 SSI
掌握 Serializable 与 SSI
Serializable 要解决的不是“读到同一份快照”这么简单,而是保证所有成功提交的并发事务,其整体效果等价于某一种串行执行。PostgreSQL 通过 Serializable Snapshot Isolation(SSI)追踪读写依赖,在可能形成不可串行化结果时主动中止事务,而不是把所有读操作都改成阻塞锁。
学习目标
- 解释 Serializable 相比 Repeatable Read 多出的可串行化保证
- 理解
SIReadLock如何记录读取范围以及 SSI 如何识别危险读写依赖 - 用并发聚合写入场景验证
40001,并建立完整事务重试策略
Serializable 在快照隔离上增加了什么
Serializable 与 Repeatable Read 一样使用稳定快照,但还会监控并发 Serializable 事务之间的读写依赖。如果一组依赖关系可能使最终结果无法对应任何串行顺序,PostgreSQL 会让其中一个事务失败,从而只保留可以解释为串行执行的提交结果。通常这不会给普通读操作增加阻塞;代价主要来自依赖跟踪和失败事务的重试。:contentReference[oaicite:2]{index=2}
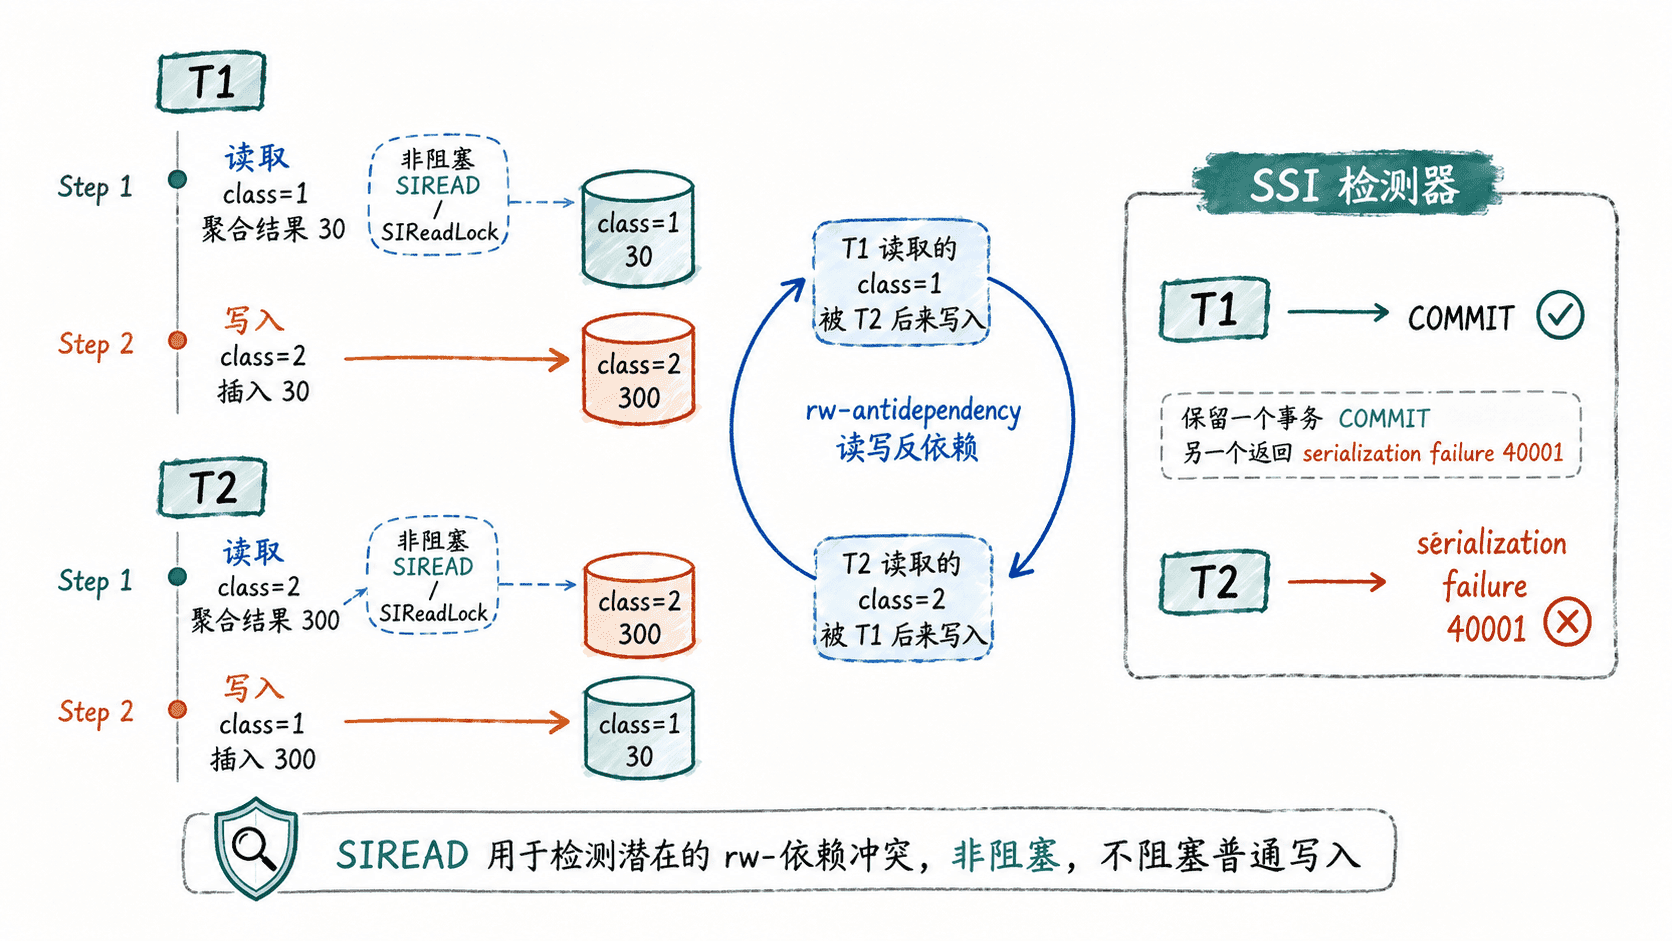
可以把读写反依赖理解为:事务 T1 先读到某个值或范围,而并发事务 T2 随后写入了会改变这次读取结果的数据,就形成一条从 T1 指向 T2 的依赖。单条依赖并不一定有问题;SSI 关注的是多条依赖能否组合成危险结构,并在它们会导致不可串行化结果时选择一个事务作为牺牲者。
SIREAD 谓词锁为什么不会挡住写入
PostgreSQL 用 predicate locking 记录“这个 Serializable 事务读过哪些数据或范围”。这些记录在 pg_locks 中以 SIReadLock 出现,但它们与 SELECT ... FOR UPDATE 的排他式锁不同:SIREAD 不阻塞写事务,也不参与死锁等待,只用于之后判断某次写入是否与先前读取形成依赖。锁粒度可能是元组、页面或整个关系,并可能为了节省跟踪内存而提升粒度;必要时它还会在读事务提交后保留一段时间,直到重叠事务结束。:contentReference[oaicite:3]{index=3}
先准备一张只有两类数值的表。类 1 总和为 30,类 2 总和为 300。
DROP TABLE IF EXISTS ssi_values;

CREATE TABLE ssi_values (
    class integer NOT NULL,
    value integer NOT NULL
);

INSERT INTO ssi_values (class, value)
VALUES
    (1, 10),
    (1, 20),
    (2, 100),
    (2, 200);
预期输出
DROP TABLE
CREATE TABLE
INSERT 0 4如果表此前不存在,DROP TABLE IF EXISTS 可能额外打印 NOTICE。
用并发聚合写入验证 SSI
会话 A 读取类 1 的总和 30,并把这个结果写入类 2,但暂不提交。
BEGIN ISOLATION LEVEL SERIALIZABLE;

SELECT SUM(value) AS sum_class_1
FROM ssi_values
WHERE class = 1;

INSERT INTO ssi_values (class, value)
VALUES (2, 30);
预期输出
BEGIN
 sum_class_1
-------------
          30
(1 row)

INSERT 0 1
会话 B 在 A 提交前启动,因此它的快照仍看到类 2 的原始总和 300,并把 300 写回类 1。
BEGIN ISOLATION LEVEL SERIALIZABLE;

SELECT SUM(value) AS sum_class_2
FROM ssi_values
WHERE class = 2;

INSERT INTO ssi_values (class, value)
VALUES (1, 300);
预期输出
BEGIN
 sum_class_2
-------------
         300
(1 row)

INSERT 0 1
在两个事务都尚未提交时,可从第三个会话观察 SIREAD 记录:
SELECT pid, mode, relation::regclass AS relation
FROM pg_locks
WHERE mode = 'SIReadLock'
  AND relation = 'ssi_values'::regclass;
预期结果至少能看到这两个 Serializable 读取对应的 SIReadLock;实际行数与锁粒度会受执行计划和锁提升影响。
 pid   |    mode    |  relation
-------+------------+------------
 <PID> | SIReadLock | ssi_values
 <PID> | SIReadLock | ssi_values
<PID> 是实际后端进程号,每次连接都可能不同。
现在分别在 A、B 中执行提交:
COMMIT;预期结果不是“两边都 COMMIT”。其中一个事务会成功,另一个会被 SSI 中止;具体哪个事务成为牺牲者不应作为业务逻辑的一部分。:contentReference[oaicite:4]{index=4}
一个事务:
COMMIT

另一个事务:
ERROR:  could not serialize access due to read/write dependencies among transactions
原因可以直接从依赖图看出:A 读过类 1,而 B 向类 1 写入;B 读过类 2,而 A 向类 2 写入。若两者都提交,就不存在任何串行顺序能同时得到 A 读到 30、B 读到 300 这两个结果,因此必须牺牲一个事务。
把重试当成 Serializable 的组成部分
序列化失败的 SQLSTATE 是 40001。应用处理它时必须回滚并重新执行整个事务,因为新的尝试需要重新获取快照、重新读取条件并重新计算写入,而不是继续使用失败事务中的旧判断。工程上通常还会加入带抖动的短退避、有限重试次数,并保证事务之外的副作用具备幂等性。:contentReference[oaicite:5]{index=5}
对于长时间只读报表,可以使用 SERIALIZABLE READ ONLY DEFERRABLE。它允许 PostgreSQL 在事务开始阶段等待一个安全快照;一旦真正开始读取,就不会因为 SSI 的序列化冲突而被迫重试。DEFERRABLE 对普通读写事务或更低隔离级别没有同样作用。:contentReference[oaicite:6]{index=6}
BEGIN ISOLATION LEVEL SERIALIZABLE READ ONLY DEFERRABLE;

SELECT count(*) AS row_count
FROM ssi_values;

COMMIT;
预期输出
BEGIN
 row_count
-----------
         5
(1 row)

COMMIT
前面的并发实验最终只会保留一个插入,因此表中有 5 行。对于依赖“先读多个条件,再据此写入”的业务规则,Serializable 往往比手工枚举所有互斥锁更容易证明正确;代价是必须把 40001 重试、事务长度和并发连接数纳入正常运行设计。