
PostgreSQL / 系统课时
设计退避、抖动与重试预算
设计退避、抖动与重试预算
事务重试如果立即连续撞回数据库,会把短暂冲突放大成持续拥塞。可控的重试策略需要同时限制尝试次数、拉开重试间隔、打散并发客户端,并用总时长预算决定何时停止,把失败转换成明确的业务结果。
学习目标
- 用指数退避和随机抖动降低多个事务同步重试造成的再次冲突
- 同时设置最大尝试次数与总耗时预算,避免无限重试
- 在预算耗尽后返回可识别的业务错误,而不是吞掉数据库冲突
先限定哪些错误值得重试
在 PostgreSQL 中,40001(serialization_failure)和 40P01(deadlock_detected)通常适合按“完整事务”重试。其他错误不能因为看起来像“暂时失败”就统一重试,例如约束违反、语法错误和权限错误通常需要修正输入或代码。
重试策略的第一道门不是“等多久”,而是是否允许重试。只有进入允许列表的错误,才消耗后面的重试预算。
用指数退避扩大重试窗口
第 次失败后的基础等待窗口可以写成:
其中 是初始窗口, 是上限。不要让所有客户端都固定等待 后同时醒来,否则它们可能再次在同一时刻竞争。常见做法是使用 full jitter:从 中随机选择本次睡眠时间。
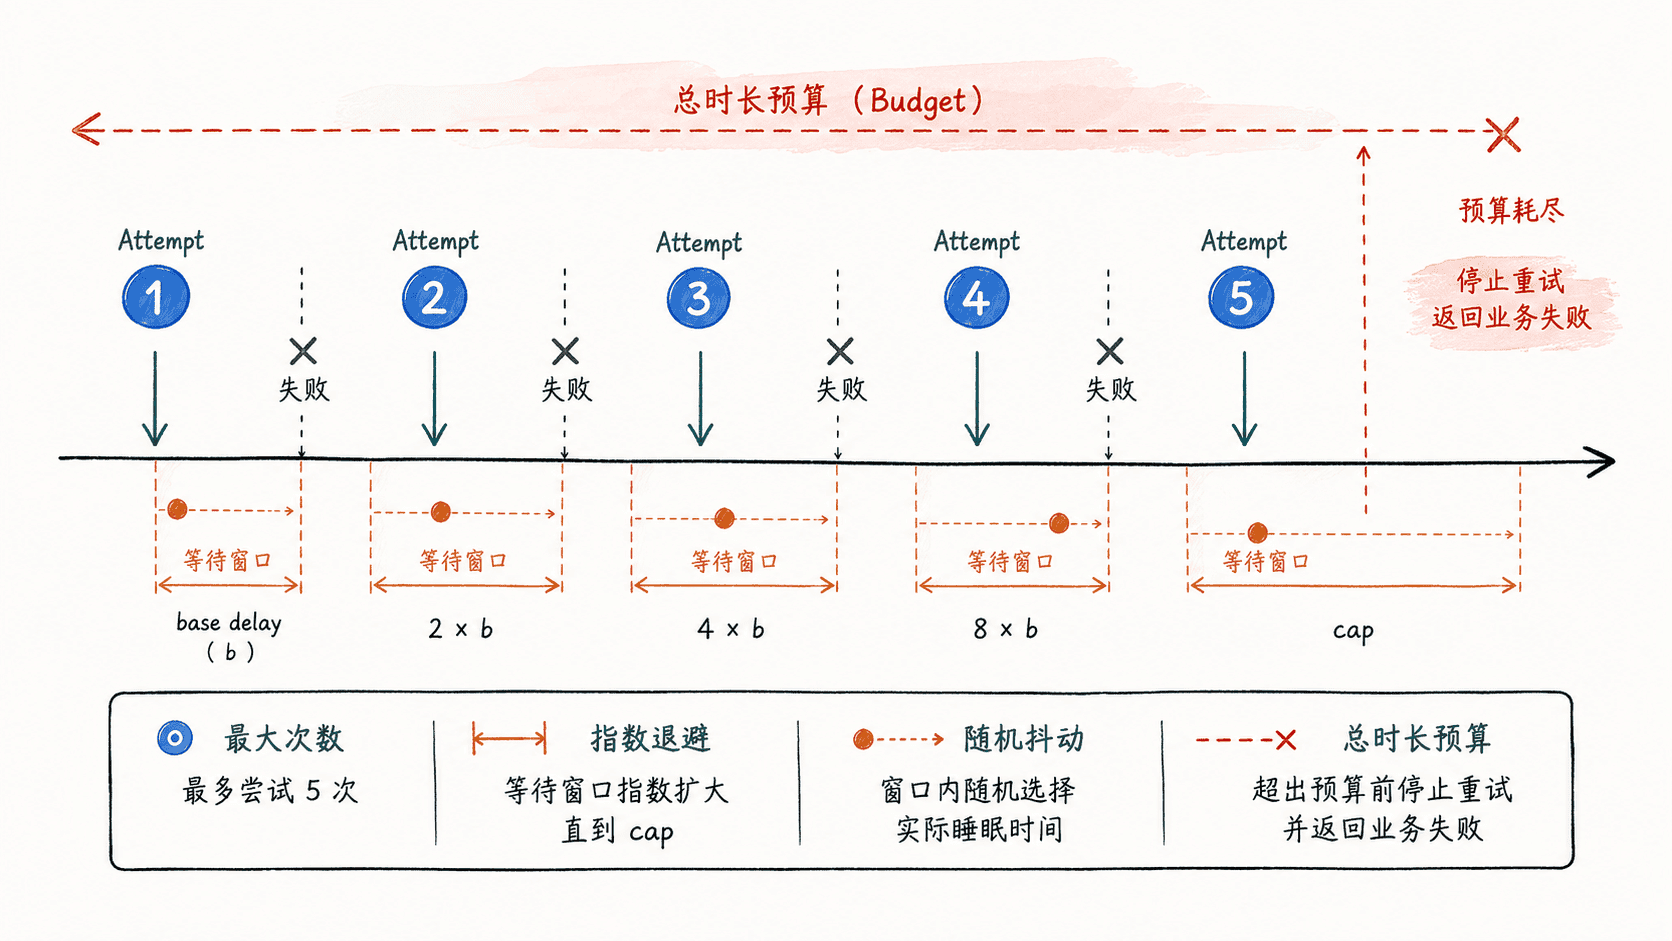
窗口上限必须结合真实冲突持续时间设置。如果死锁通常几十毫秒内解除,把最大等待设成几十秒只会拖长请求;如果热点锁可能持续数百毫秒,过小的窗口又会让客户端过早再次撞上同一资源。
总预算比单纯次数更可靠
只限制“最多重试 5 次”仍然无法控制请求总耗时,因为每次数据库执行本身也会占时间。更稳妥的做法是同时设置:
max_attempts:限制最多执行多少个完整事务max_elapsed:限制从第一次尝试开始到最终返回的总时间base_delay:第一次失败后的退避基准max_delay:单次等待窗口上限
判断下一次重试前,要把已经消耗的数据库执行时间和即将睡眠的时间都计入总预算。若剩余预算不足,就立即停止,不再为了“凑满次数”启动一个注定超时的新事务。
一个可执行的预算控制器
下面的示例用自定义异常模拟 PostgreSQL 的可重试冲突,核心结构可以直接替换成捕获 40001 和 40P01 后重放完整事务。示例故意失败两次,第三次成功。
import random
import time

class RetryableConflict(Exception):
    pass

class RetryExhausted(Exception):
    pass

def retry(operation, max_attempts=5, base_delay=0.05,
          max_delay=0.5, max_elapsed=1.0):
    started = time.monotonic()

    for attempt in range(1, max_attempts + 1):
        try:
            return operation()
        except RetryableConflict as exc:
            if attempt == max_attempts:
                raise RetryExhausted("retry attempts exhausted") from exc

            elapsed = time.monotonic() - started
            window = min(max_delay, base_delay * 2 ** (attempt - 1))
            sleep_for = random.uniform(0, window)

            if elapsed + sleep_for >= max_elapsed:
                raise RetryExhausted("retry time budget exhausted") from exc

            print(f"attempt={attempt} sleep={sleep_for:.3f}s")
            time.sleep(sleep_for)

def demo_operation():
    demo_operation.calls += 1
    if demo_operation.calls < 3:
        raise RetryableConflict("simulated SQLSTATE 40001")
    return "committed"

demo_operation.calls = 0
print(retry(demo_operation))
预期输出:
attempt=1 sleep=<VALUE>s
attempt=2 sleep=<VALUE>s
committed
<VALUE> 由随机抖动决定,实际值每次可能不同,但都不会超过对应的指数窗口。生产代码应把 RetryableConflict 换成对 PostgreSQL SQLSTATE 的明确分类,并确保 operation() 每次都创建新事务、重新读取数据库状态。
预算耗尽要成为业务结果
重试耗尽不是“程序内部的小插曲”,而是一次明确的业务结果。服务端至少应记录冲突类型、尝试次数和累计耗时,并把结果转换成调用方能处理的错误,例如“当前资源竞争激烈,请稍后重试”或可识别的冲突状态。
如果同一热点持续把大量请求推到预算耗尽,继续加大次数通常不是解决办法。此时应回到并发设计本身,缩短事务、减少热点行竞争、调整访问顺序,或按业务键串行化处理;退避只能缓和瞬时竞争,不能修复结构性的持续冲突。