
PostgreSQL / 系统课时
排查长事务与 Vacuum 压力
排查长事务与 Vacuum 压力
dead tuple 持续上升、autovacuum 频繁运行却回收不佳时,先检查长事务与长期快照。本节从会话年龄、事务水位和表统计建立证据链,再决定应优化业务事务还是处置异常连接。
学习目标
- 用
pg_stat_activity找出可能拖住事务水位的长事务和空闲事务。 - 把旧事务与
n_dead_tup、autovacuum 活动联系起来,而不是只看单一指标。 - 根据事务性质选择拆分业务、回滚异常会话或继续调整 Vacuum 参数。
先理解长事务为什么会妨碍回收
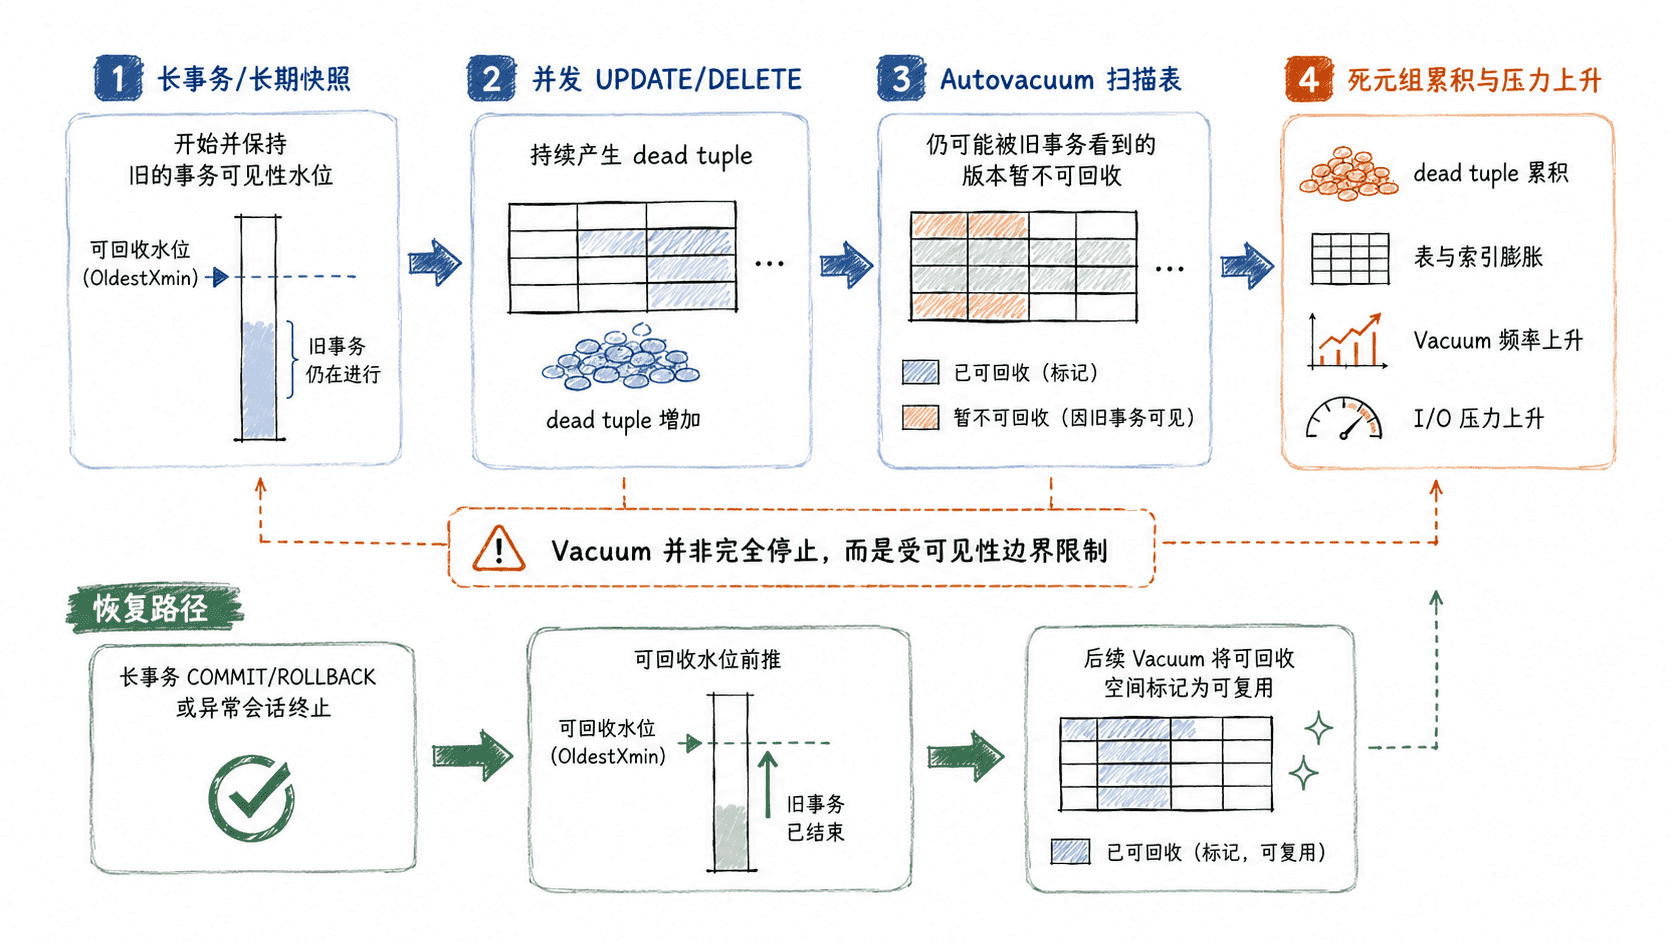
PostgreSQL 的 Vacuum 不会因为出现一个长事务就“完全停止”。它仍然可以扫描并清理已经对所有活跃事务都不可见的旧版本;真正受阻的是那些仍可能被旧事务或旧快照看到的 tuple 版本。
当事务或快照长期存活时,全局可回收水位无法正常前推。与此同时,其他事务不断 UPDATE、DELETE 会制造新的 dead tuple。Vacuum 即使反复执行,也可能因为可见性边界过旧而暂时不能移除其中一部分,于是表膨胀、索引压力和 autovacuum 工作量一起上升。
从最老事务开始建立证据链
先找出当前数据库中仍有事务上下文的会话,重点观察事务开始时间、backend_xid、backend_xmin 和会话状态。backend_xid 或 backend_xmin 可能为空,因此不要只凭一个字段下结论。
SELECT
    pid,
    usename,
    application_name,
    state,
    now() - xact_start AS xact_age,
    backend_xid,
    backend_xmin,
    age(backend_xid) AS xid_age,
    age(backend_xmin) AS xmin_age,
    wait_event_type,
    wait_event,
    left(query, 100) AS query_preview
FROM pg_stat_activity
WHERE datname = current_database()
  AND xact_start IS NOT NULL
ORDER BY xact_start;
预期输出
 pid   | usename | application_name | state               | xact_age   | backend_xid | backend_xmin | xid_age | xmin_age | wait_event_type | wait_event | query_preview
-------+---------+------------------+---------------------+------------+-------------+--------------+---------+----------+-----------------+------------+--------------
 <PID> | <USER>  | <APP>            | idle in transaction | <INTERVAL> | <XID>       | <XID>        | <VALUE> | <VALUE>  | Client          | ClientRead | <SQL>
 <PID> | <USER>  | <APP>            | active              | <INTERVAL> | <XID>       | <XID_OR_NULL>| <VALUE> | <VALUE>  | <TYPE_OR_NULL>  | <EVENT>    | <SQL>
实际值会随负载变化。优先调查“事务年龄明显高于业务正常范围”的会话,尤其是 idle in transaction、长时间报表事务、长批处理以及 REPEATABLE READ 或 SERIALIZABLE 下长期保留快照的会话。
把事务年龄与 dead tuple 对上
接着查看用户表的 dead tuple 估算值和 autovacuum 历史。n_dead_tup 是统计估算,不是逐行精确计数,因此应看趋势和相对规模,而不是把某个瞬时数字当成最终结论。
SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    round(
        100.0 * n_dead_tup
        / GREATEST(n_live_tup + n_dead_tup, 1),
        2
    ) AS dead_pct,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 10;
预期输出
 relname | n_live_tup | n_dead_tup | dead_pct | last_autovacuum | autovacuum_count
---------+------------+------------+----------+-----------------+-----------------
 <TABLE> | <VALUE>    | <VALUE>    | <VALUE>  | <TIME_OR_NULL>  | <VALUE>
如果同一张高更新表的 n_dead_tup 长期增长,同时存在明显老于业务基线的事务,就已经形成较强的因果线索。反过来,如果没有老事务而 dead tuple 仍持续堆积,才更应该转向检查 autovacuum 触发阈值、worker 数量、成本限速、I/O 能力或表级参数。
判断该优化业务还是处置会话
对“正常但过长”的业务事务,优先缩短事务生命周期,而不是直接终止。典型做法是把大批量更新拆成可提交的小批次、避免在事务内等待外部 HTTP 或人工输入,并让只读报表在满足一致性要求的前提下尽快释放快照。
对 idle in transaction 且已明显超过业务预期的会话,应先确认来源和影响,再回滚或终止异常连接,并用 idle_in_transaction_session_timeout 防止同类问题重复发生。直接杀会话会回滚未提交工作,因此必须先确认它不是仍在执行的重要事务。
如果本地会话都很新,但可回收水位仍异常,还应继续检查复制相关因素,例如长期 replication slot 或 hot_standby_feedback;这时问题已经不再是单纯的业务长事务。
修复后验证 Vacuum 是否重新有效
释放异常事务后,可以先观察后续 autovacuum;如果需要加速验证,并且表规模与业务窗口允许,可对目标表执行一次普通 Vacuum。下面以 public.orders 为例,实际表名按现场替换。
VACUUM (ANALYZE) public.orders;预期输出
VACUUM随后重新执行事务查询和 pg_stat_user_tables 查询:异常老事务应消失,n_dead_tup 应在后续 Vacuum 与统计刷新后回落或停止异常增长。若事务水位已经恢复而 dead tuple 仍持续攀升,说明根因更可能在写入速率与 autovacuum 能力不匹配,需要进入参数与容量层面的治理。