
PostgreSQL / 系统课时
编写事务并发故障 Runbook
编写事务并发故障 Runbook
并发故障现场最怕先做破坏性操作、后补证据。一个可执行的 Runbook 应把长事务、锁等待、死锁和序列化失败统一成“触发告警→采集证据→分类→止损→恢复验证→升级”的固定路径,让值班人员在压力下也能做出可审计的决定。
学习目标
- 用固定查询快速采集事务年龄、等待事件、阻塞链和死锁计数。
- 为四类常见并发故障选择不同的止损与根因方向。
- 定义恢复验证和升级条件,避免只凭“错误暂时消失”结束事件。
固定 Runbook 的执行顺序
Runbook 的第一条原则是先保存现场,再改变现场。告警触发后先记录时间窗口、数据库、应用版本和流量变化,再采集活动会话与累计统计;证据齐全后才判断属于长事务、锁等待、死锁还是 40001 激增,并为每个分支预先写好允许执行的止损动作和停止条件。
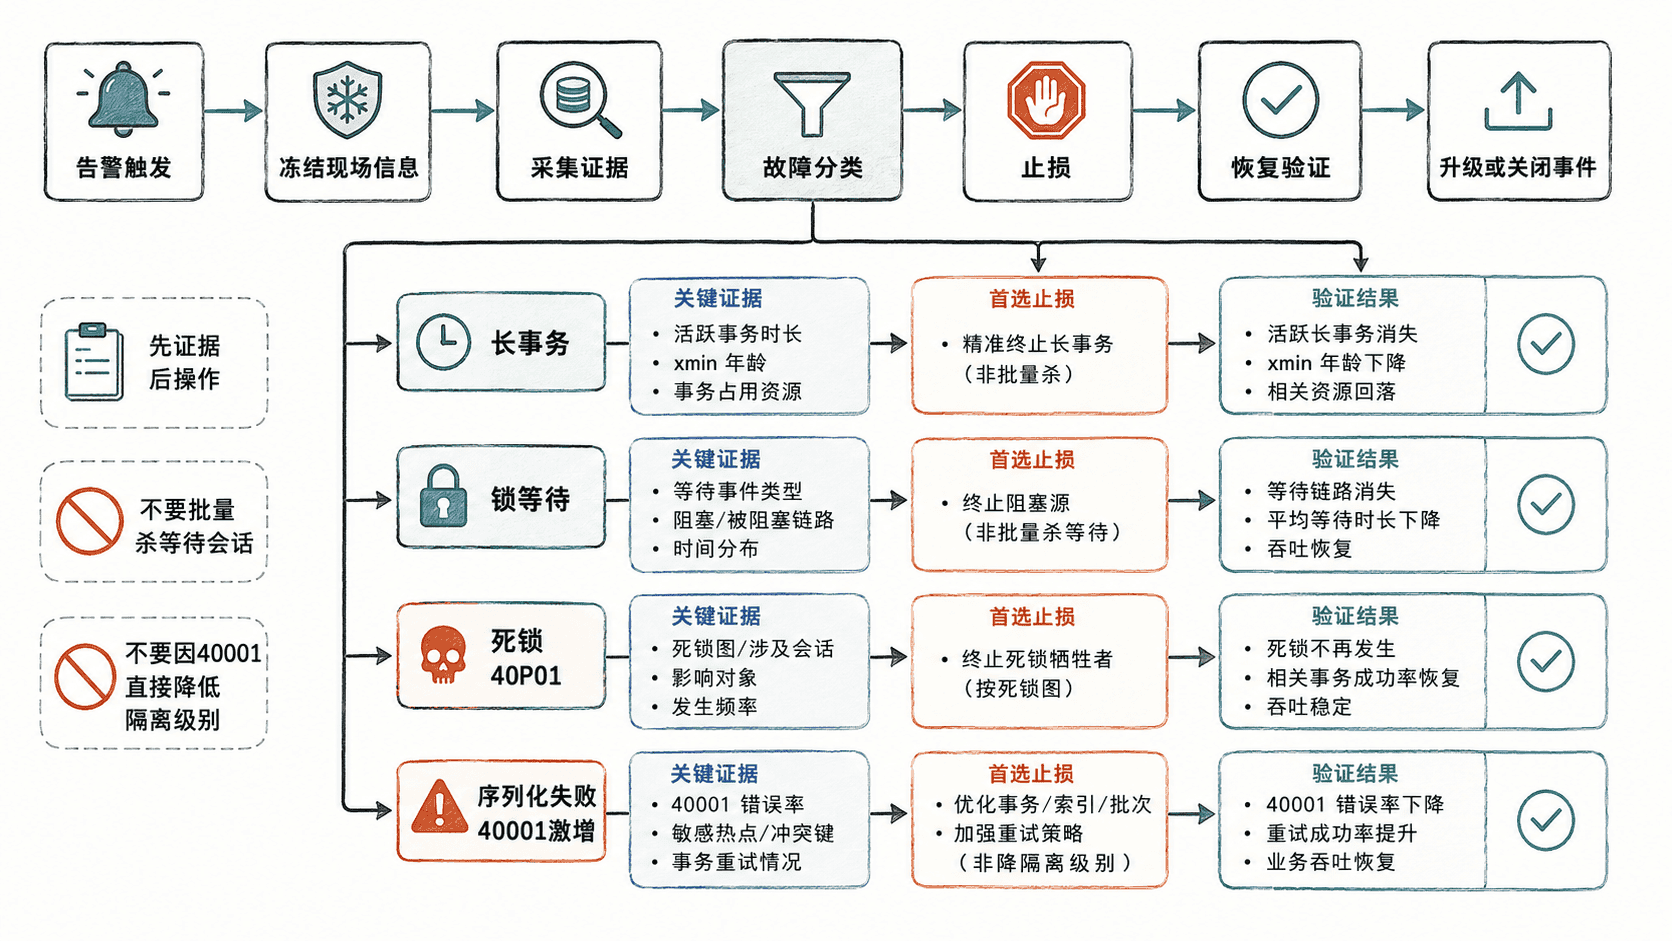
第一时间采集可复用证据
从独立管理会话执行下面的证据包。观测账号需要能看到目标会话的活动信息;生产环境通常由受控的监控角色承担这项权限。第一条查询同时给出事务年龄、状态、等待事件和直接阻塞者;第二条读取数据库累计提交、回滚和死锁计数。pg_stat_database.deadlocks 是累计值,应与事件开始前的基线做差,而不是把当前绝对值当成本次事件数量。
SELECT
    pid,
    usename,
    application_name,
    state,
    clock_timestamp() - xact_start AS xact_age,
    wait_event_type,
    wait_event,
    pg_blocking_pids(pid) AS blocking_pids,
    left(query, 100) AS query
FROM pg_stat_activity
WHERE datname = current_database()
  AND pid <> pg_backend_pid()
  AND xact_start IS NOT NULL
ORDER BY xact_start;

SELECT
    datname,
    xact_commit,
    xact_rollback,
    deadlocks,
    stats_reset
FROM pg_stat_database
WHERE datname = current_database();
预期输出中的 PID、时长和计数均为动态值。
 pid   | application_name | state               | xact_age | wait_event_type | wait_event | blocking_pids
<PID>  | <VALUE>          | idle in transaction | <VALUE>  | <VALUE>         | <VALUE>    | {}
<PID>  | <VALUE>          | active              | <VALUE>  | Lock            | <VALUE>    | {<PID>}

 datname | xact_commit | xact_rollback | deadlocks | stats_reset
<VALUE>  | <VALUE>     | <VALUE>       | <VALUE>   | <TIME>
pg_stat_database 没有单独的序列化失败计数,因此 40001 必须从应用错误指标、pgbench --failures-detailed 或带 SQLSTATE 的数据库日志中统计;xact_rollback 只能说明发生了回滚,不能等价为序列化失败数。
按故障类型选择止损动作
| 故障 | 最强现场证据 | 首选止损 | 恢复验证 |
|---|---|---|---|
| 长事务 | xact_start 很早,尤其长期 idle in transaction |
找到会话所有者并停止继续占用;活动查询先尝试取消,确认是失效阻塞会话且能接受整笔回滚时才终止连接 | 最老事务回到基线,阻塞链消失,延迟恢复 |
| 锁等待 | wait_event_type='Lock' 且 pg_blocking_pids() 指向明确阻塞者 |
处理队头阻塞者或临时降低热点入口并发,不要批量杀等待者 | 等待队列下降,吞吐和尾延迟恢复 |
| 死锁 | 40P01、数据库 deadlocks 增量或死锁日志 |
允许有限的整事务重试并临时降并发;永久修复是统一加锁顺序、缩短事务 | 40P01 回到基线,同一路径重复压测不再形成循环等待 |
| 序列化失败激增 | 应用或压测记录大量 40001 |
保证从事务入口有限重试,减少热点重叠或并发度;先查依赖结构,不把降低隔离级别当默认止损 | 40001 与重试次数回落,成功率和 p95/p99 回到 SLO |
死锁与序列化失败都要求重试完整事务,而不是在已失败事务中继续执行。它们的治理方向不同:死锁通常指向互斥锁顺序,40001 则指向当前并发读写依赖无法安全提交;Runbook 必须把两者分开计数。
约束破坏性操作
止损动作还应写明负责人和退出条件。例如“降低热点接口并发”必须同时注明恢复阈值;“终止失效长事务”必须记录 PID、应用名、事务开始时间、执行人和结果。Runbook 的价值不是列出命令,而是限制在什么证据下谁可以执行什么动作。
用恢复证据决定关闭还是升级
故障消失并不等于恢复完成。至少连续观察多个业务窗口,确认最老事务年龄、锁等待数量、40P01、40001、事务成功率和 p95/p99 延迟都回到预先定义的基线或 SLO,同时重新检查核心业务不变量与积压队列,避免把回滚、限流或重试造成的后续影响遗漏掉。
出现无法确认阻塞者所有权、止损后错误持续上升、需要终止高价值长事务、重试预算即将耗尽,或任何动作可能改变业务一致性保证时,应立即升级给数据库负责人和业务负责人。事件结束后把时间线、证据、执行动作和验证结果回填到 Runbook,并把临时止损转成可测试的永久修复。