
PostgreSQL / 系统课时
制定生产事务治理准则
制定生产事务治理准则
生产并发问题很少靠单个隔离级别解决。本课把隔离选择、事务时长、锁顺序、重试、副作用和监控收敛为一套可执行的生产准则,最终形成可用于设计评审、代码审查和发布验收的检查表。
学习目标
- 为不同业务不变量选择可解释、可验证的事务与锁策略
- 定义事务时长、锁顺序、重试预算和外部副作用的硬性边界
- 用数据库指标与发布检查把准则落实为持续治理机制
把并发治理写成可审查的约束
治理准则不能只写“避免长事务”“必要时重试”这类口号,而要能在评审时直接判断通过或拒绝。每条规则至少应回答三个问题:适用对象是什么、允许边界是什么、如何验证。
建议把规则按六个维度固化:隔离级别、事务时长、锁获取顺序、失败重试、外部副作用、监控告警。它们不是独立选项,而是一条完整链路:隔离级别决定可能遇到的并发错误,锁策略决定等待关系,事务时长放大或缩小锁影响,重试机制承接可恢复失败,副作用边界保证重试安全,监控则验证这些约束是否真的在生产生效。
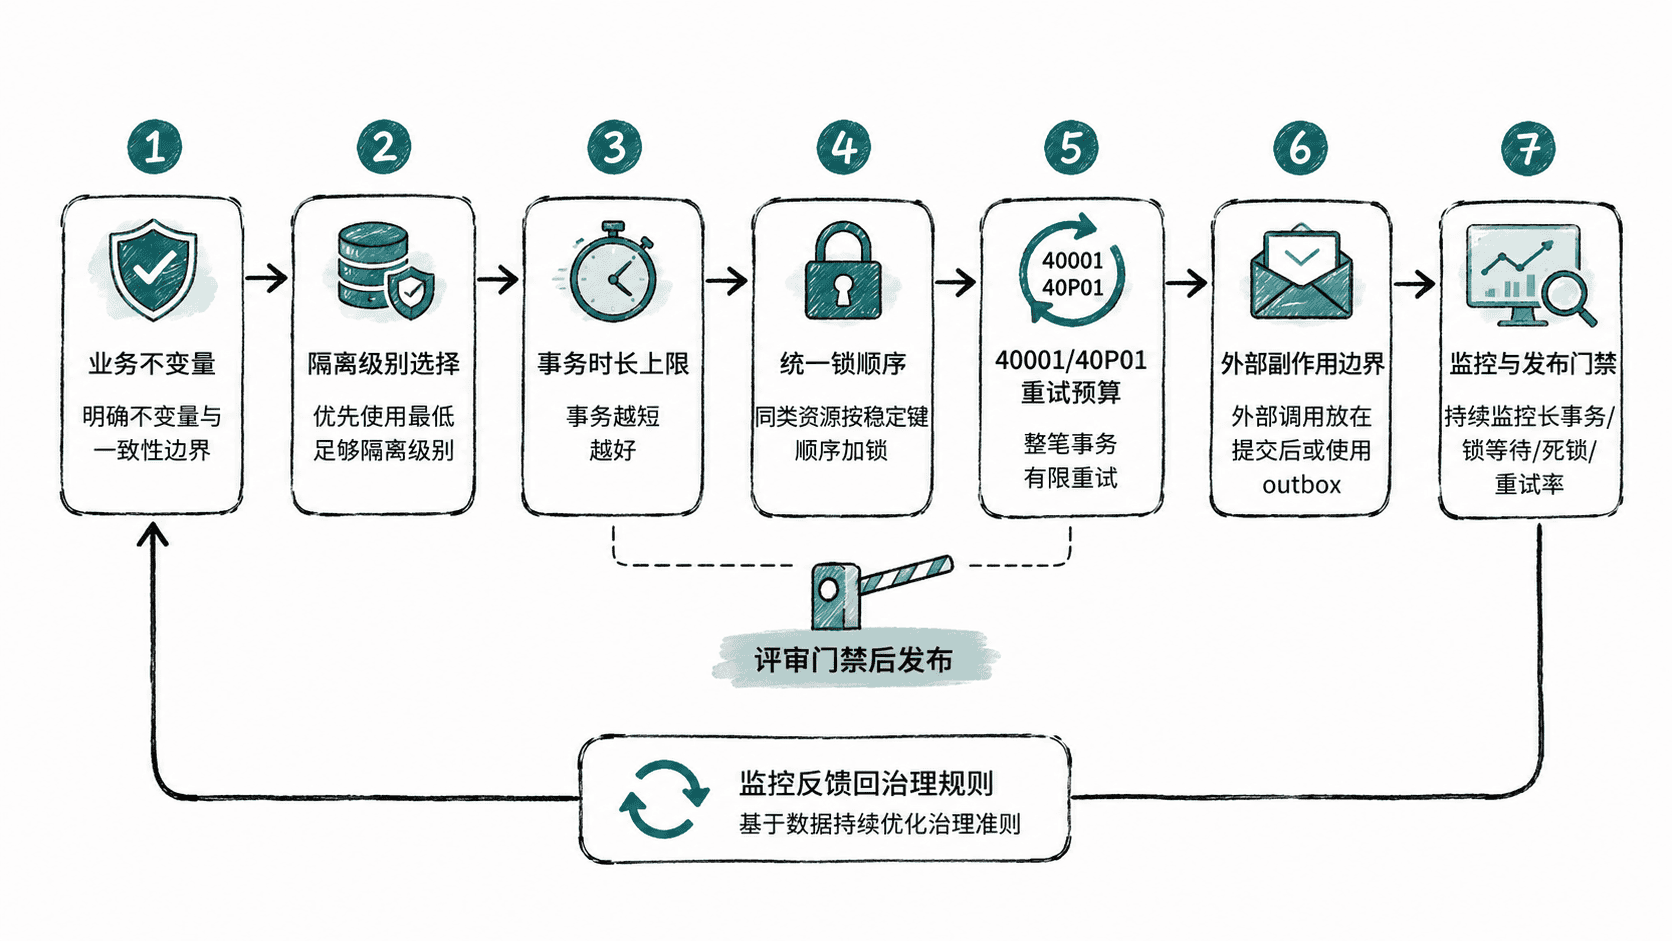
定义默认策略与升级条件
默认策略应尽量简单:能用唯一约束、条件 UPDATE、原子写或明确行锁表达的不变量,优先在 READ COMMITTED 下完成;需要事务内稳定快照时再使用 REPEATABLE READ;只有无法可靠映射到单行、单键或稳定锁对象的跨行规则,才考虑 SERIALIZABLE,并把序列化失败纳入重试设计。
不要把“更高隔离级别”当作统一安全开关。它会改变冲突方式和失败形态,却不会自动解决长事务、锁顺序混乱、外部 API 重复调用等问题。生产规范应要求每个高隔离级别场景写明业务不变量、失败 SQLSTATE、预期重试行为和并发回归测试。
可以先建立一组会话级保护参数,作为应用连接池或关键任务的基线。以下示例需要在测试环境执行;实际阈值应按业务延迟目标和批处理特性调整。
SET statement_timeout = '5s';
SET lock_timeout = '1s';
SET idle_in_transaction_session_timeout = '30s';
SET transaction_isolation = 'read committed';

SHOW statement_timeout;
SHOW lock_timeout;
SHOW idle_in_transaction_session_timeout;
SHOW transaction_isolation;
预期输出
 statement_timeout
-------------------
 5s

 lock_timeout
--------------
 1s

 idle_in_transaction_session_timeout
-------------------------------------
 30s

 transaction_isolation
-----------------------
read committed这些参数不是彼此替代。statement_timeout 限制单条语句耗时,lock_timeout 限制等待锁的时间,idle_in_transaction_session_timeout 用于清理开启事务后长期空闲的会话。正式发布前应确认设置发生在正确角色、数据库或连接池层级,而不是只在一次手工会话中生效。
固定锁顺序与事务边界
凡是一次事务会锁定多个同类对象,都应规定稳定顺序,例如始终按账户 ID 升序锁定账户。规则的重点不是“少用锁”,而是让所有代码路径以相同顺序获得相同资源,从结构上减少循环等待。
同时给事务设置明确边界:事务内部只保留完成一致性所必需的数据库读写和计算;网络调用、消息发送、文件上传等不可回滚动作不要夹在事务中。需要“数据库提交成功后一定发送”的场景,优先使用 outbox;需要客户端安全重试的入口,使用稳定的幂等键。
统一重试预算
生产重试必须是有限、可观测、从完整事务外层开始。对 PostgreSQL,重点处理 40001(serialization_failure)和 40P01(deadlock_detected);收到这类错误后应回滚整笔事务,重新读取最新状态并重新计算,而不是在已失败的事务中继续执行。
建议在规范中固定三个参数:最大尝试次数、指数退避上限、总耗时预算。例如最多 4 次尝试,退避带 jitter,且整个业务操作不得超过调用方剩余超时。达到预算后返回明确失败,让上层决定降级或稍后重试,避免无限循环制造更大压力。
评审时还要确认重试不会重复产生外部副作用。如果事务内写入 outbox,则 outbox 记录应与业务数据同一事务提交;如果依赖幂等键,则数据库必须有唯一约束兜底,而不能只靠应用内存判断。
建立监控与发布门禁
至少持续观察四类信号:事务年龄、锁等待、死锁数量、重试错误率。单看数据库 CPU 或慢 SQL 不足以发现“长事务阻塞回收”“队头锁阻塞”“序列化冲突突增”这类一致性风险。
下面的查询可作为日常巡检基础,用于找出运行时间较长且仍处于事务中的会话。实际阈值应结合业务 SLA 设定。
SELECT
    pid,
    usename,
    state,
    now() - xact_start AS xact_age,
    wait_event_type,
    wait_event,
    left(query, 120) AS query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
  AND now() - xact_start > interval '30 seconds'
ORDER BY xact_start;
预期结果
 pid  | usename |        state        | xact_age | wait_event_type | wait_event | query
------+---------+---------------------+----------+-----------------+------------+------------------------------
 <PID>| app     | idle in transaction | 00:00:42 | Client          | ClientRead | UPDATE accounts SET ...
实际 <PID>、事务时长和 SQL 文本会因现场不同而变化。若没有超过阈值的事务,查询返回 0 行,这本身就是正常结果。
发布门禁应要求:关键事务路径存在并发回归测试;高风险 SQL 有锁与隔离说明;40001、40P01 有受控重试;外部副作用具备幂等或 outbox 保障;监控面板能看到长事务、锁等待、死锁和重试率。只有这些条件同时满足,事务治理才从“团队经验”变成可以重复执行的工程制度。