
PostgreSQL / 系统课时
执行高并发事务压测
执行高并发事务压测
并发控制方案只有在真实竞争下仍能守住正确性与延迟目标,才算可交付。本课用可重复的 pgbench 事务脚本逐级提高并发度,同时记录失败类型、锁等待和延迟拐点,最后用业务不变量与性能门槛共同验收。
学习目标
- 构造能稳定复现热点竞争的高并发事务压测。
- 区分序列化失败、死锁、锁等待和普通性能下降。
- 用失败率、延迟与业务不变量判断并发策略是否可上线。
把压测变成可比较的实验
先固定数据规模、事务 SQL、隔离级别、连接方式和单轮时长,只改变并发客户端数。正式对比时每档应从同一数据快照或等价初始化状态开始,并固定预热与 Vacuum 策略,避免把表膨胀或自动维护差异误判为并发策略变化。第一轮应关闭 40001 与 40P01 的自动重试,让原始冲突率暴露出来;随后再按生产重试预算复测,评估重试后的成功率与额外延迟,不能把“最终重试成功”误认为“系统没有竞争”。
下面建立 100 个账户,每个账户余额为 10000。该实验的核心不变量是总余额始终为 1000000。
DROP TABLE IF EXISTS bench_account;

CREATE TABLE bench_account (
    id integer PRIMARY KEY,
    balance bigint NOT NULL
);

INSERT INTO bench_account (id, balance)
SELECT g, 10000
FROM generate_series(1, 100) AS g;

ANALYZE bench_account;
预期输出
DROP TABLE
CREATE TABLE
INSERT 0 100
ANALYZE
创建 transfer.sql。一次脚本执行就是一个完整事务;随机选择两个账户并转移 1 个余额单位,较小的数据集会主动制造热点重叠,便于暴露序列化失败和反向锁顺序导致的死锁。
\set src random(1, 100)
\set dst random(1, 100)

BEGIN ISOLATION LEVEL SERIALIZABLE;
UPDATE bench_account SET balance = balance - 1 WHERE id = :src;
UPDATE bench_account SET balance = balance + 1 WHERE id = :dst;
COMMIT;
该文件由 pgbench -f transfer.sql 执行,本身不产生独立输出。真实业务压测应把脚本替换为核心交易路径,并保持事务边界、热点分布和隔离级别与生产一致。
逐级提高并发并保留原始失败
以下命令依次使用 8、16、32、64 个客户端,每档运行 180 秒。--max-tries=1 表示序列化失败或死锁不在 pgbench 内重试,--failures-detailed 会把失败拆成 serialization、deadlock 和 other 三类。
for clients in 8 16 32 64; do
  echo "=== clients=${clients} ==="
  pgbench -n -c "$clients" -j 4 -T 180 -P 10 \
    --max-tries=1 --failures-detailed \
    -f transfer.sql benchdb
done预期输出节选如下;<VALUE> 会随硬件、数据状态和并发调度变化。
=== clients=32 ===
number of clients: 32
maximum number of tries: 1
duration: 180 s
number of transactions actually processed: <VALUE>
number of failed transactions: <VALUE> (<VALUE>%)
number of serialization failures: <VALUE> (<VALUE>%)
number of deadlock failures: <VALUE> (<VALUE>%)
number of other failures: <VALUE> (<VALUE>%)
latency average = <VALUE> ms
tps = <VALUE> (without initial connection time)
在这一轮中,成功率可直接按 100% - failed transaction percentage 读取。若生产会重试,应再启用与生产相同的有限重试策略复测;这时还要单独记录重试次数和最终延迟,因为成功率提高可能只是把冲突成本转化成更长的响应时间。
同时观察锁等待与长事务
压测报告能告诉你“失败了多少”,数据库活动视图则帮助判断“为什么开始排队”。压测进行时从独立观测会话执行下面查询,重点看 wait_event_type='Lock'、阻塞 PID 和事务年龄。
SELECT
    pid,
    clock_timestamp() - xact_start AS xact_age,
    state,
    wait_event_type,
    wait_event,
    pg_blocking_pids(pid) AS blocking_pids,
    left(query, 80) AS query
FROM pg_stat_activity
WHERE datname = current_database()
  AND pid <> pg_backend_pid()
  AND (wait_event_type = 'Lock' OR state = 'idle in transaction')
ORDER BY xact_start NULLS LAST;
预期输出会随采样时刻变化;没有锁等待或空闲事务时可能返回 0 行。
 pid   | xact_age | state  | wait_event_type | wait_event    | blocking_pids | query
<PID>  | <VALUE>  | active | Lock            | transactionid | {<PID>}        | UPDATE bench_account ...
(<VALUE> rows)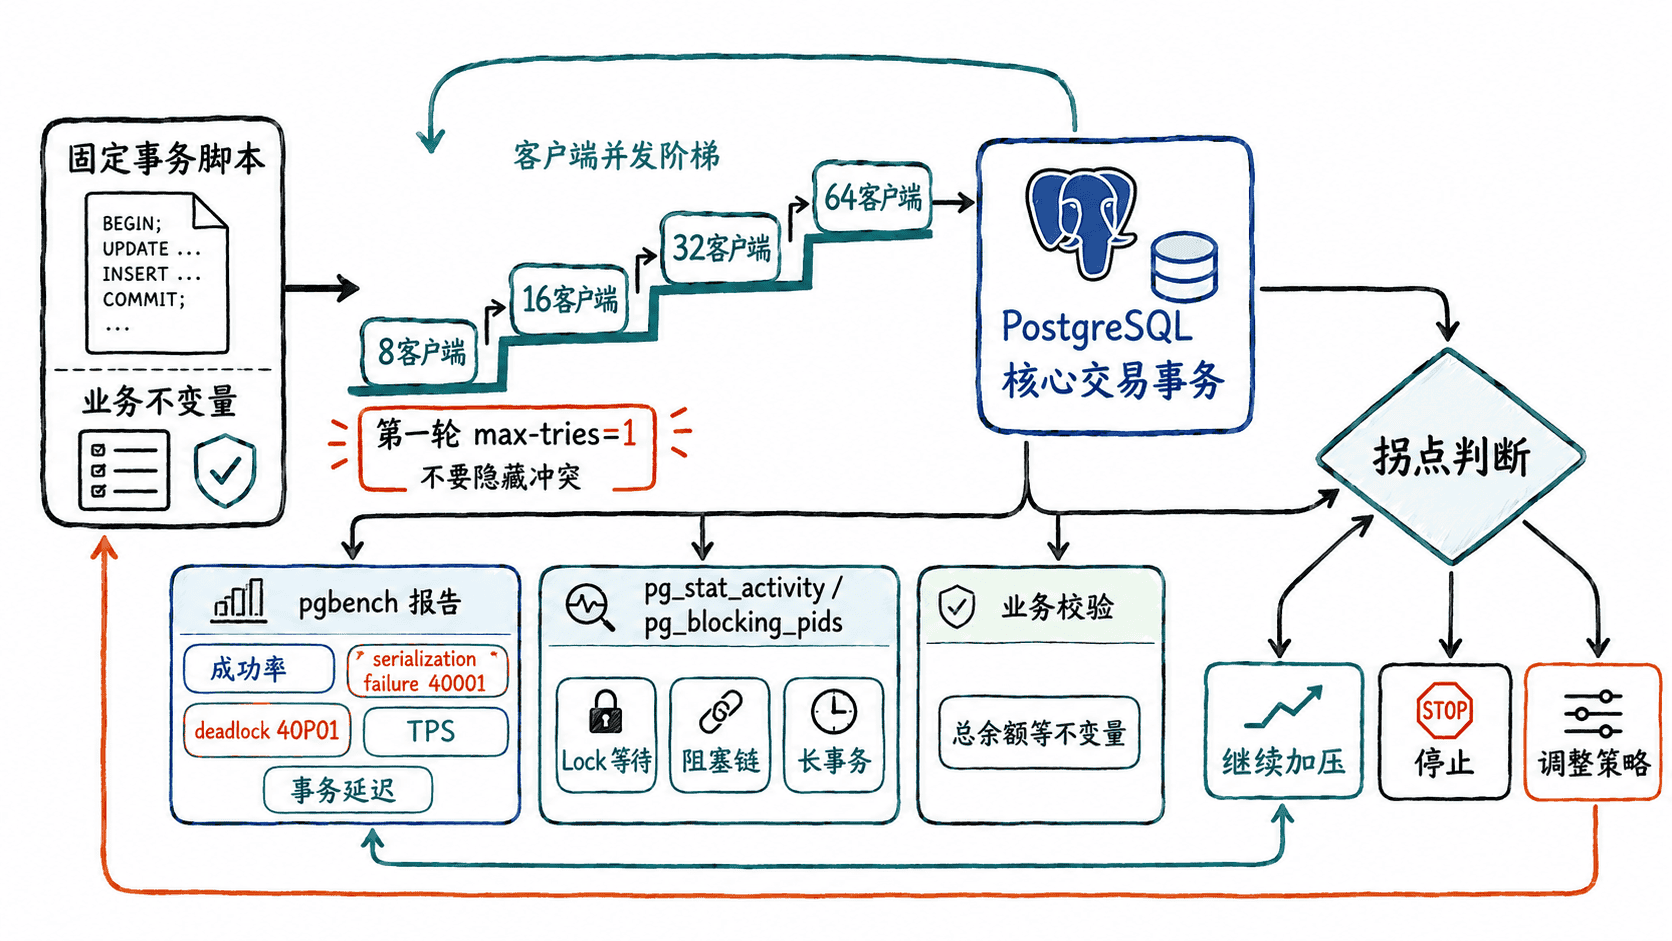
用拐点和一致性共同验收
不要把最高 TPS 当成唯一结论。应把每档并发的成功率、40001、40P01、锁等待数量、事务年龄和延迟放在同一时间轴上;当并发继续上升而 TPS 增幅趋近于零,同时失败率或等待显著上升时,通常已经越过可用并发区间。主报告只有平均延迟时,生产验收还应从事务日志或现有指标系统补充 p95/p99。
最后校验事务没有破坏不变量。无论中间出现多少回滚或重试,总余额都应保持不变。
SELECT count(*) AS accounts, sum(balance) AS total_balance
FROM bench_account;
预期输出
 accounts | total_balance
----------+---------------
      100 |       1000000
(1 row)
上线门槛应在压测前由业务 SLO 和错误预算确定,并要求“性能达标”和“不变量成立”同时通过。若必须靠无限重试才能维持表面成功率,或者热点一出现就形成长阻塞链,这个并发控制方案仍应视为未通过。